스토리 홈

인터뷰

피드

뉴스

조회수 1350

Humans of TODAIT : CTO 유병한을 만나다

어느 화창했던 3월, ‘Humans of TODAIT’ 의 첫 주인공인 투데잇 CTO 유병한을 만나봤습니다. 투데잇 핵심엔진인 그의 이야길 함께 들어볼까요?Q. 자기소개 부탁드려요.안녕하세요! 투데잇에서 CTO를 맡고 있는 유병한입니다. ‘SW 마에스트로’라는 과정에서 대표님과 좋은 인연이 되어 투데잇의 전신인 투데잇브레이커부터 지금까지 열심히 개발중입니다. 안드로이드분야에 관심이 많아서 시작하게 되었는데, 차츰 기술 스펙을 확장해 나가면서 서버개발부터 최근엔 iOS 개발까지 맡고 있습니다.Q. ‘꿈을 향한 오늘, 투데잇’ 이라는 슬로건처럼 CTO님의 꿈에 대해 들을 수 있을까요?제겐 두가지 꿈이 있는데요, 먼저 투데잇이라는 서비스 자체에 대해선 전국민 앱으로 거듭나고 싶어요. 기존 교육관련 산업에서 우뚝 솟을 수 있는 서비스가 되고 싶은데요, 공부하는 사람의 입장에서 처음부터 끝까지 도움을 줄 수 있는 서비스를 제공하고 싶어요. 그래서 ‘저 사람이 일하는 투데잇은 일하기 좋은 회사다!’ 라던가 ‘성장하기 좋은 회사!’라는 인식을 주고 싶어요! 여러사람들을 심쿵!하게 만들고 싶습니다(웃음)음.. 그리고 제 개인적인 꿈으론 진짜 언젠간 해보고 싶은건데, 다큐멘터리 내셔널 지오그래픽급의 사진작가가 되고 싶어요.이래저래 심쿵하는 사람이 되고, 심쿵하게 만드는 서비스를 제공하고 싶습니다.Q. ‘개발자’로서의 시작은 어땠나요?음 제가 처음부터 개발자가 되고 싶단 생각은 안했어요. ‘개발’과 인연의 끈이라고 되짚어본다면, 아마 어릴 적에 접했던 나모웹에디터로 홈페이지 만들기?였던 것 같아요.그리고 수시를 과감하게 버리고 제가 즐겁게 할 수 있었던 컴공이나 관련 학과로 찾다보니 지금의 과에 입학하게 되었어요. 대학교와서도 다양한 학교 수업 중 개발 관련 수업을 맛보면서 ‘아 이게 나한테 맞겠구나!’ 싶어서 본격적으로 공부했어요.(Q. 앗, 그럼 ‘개발자’라는건 갑작스러운 전환이었나요? )그렇다고 해서 아주 갑작스럽진 않았어요. 학생때 사진찍는걸 즐겨서 색감에 대한 거라던가 화면에서의 구도에 대한 이해같은게 높았거든요. 학과에서 배웠던 다양한 편집툴들이 지금의 UI 센스에 발판이 되지않았나 생각해요.어느 순간 하나가 쓸데없던 적은 없었던 것 같아요. 자그마한 순간순간들이 지금의 저로 만든 것 같아요.Q. 본인이 맡은 업무에 대해 어떻게 접근하나요?일단 맡은 분야에 대해서도 그렇고 제가 욕심이 좀 많아요(웃음) 내가 잘하고 싶은 욕심, 가지고 싶은 욕심이 여러 힘든 과정을 이겨낸 원동력이 아닐까 생각해요.Q. 예를 들면 어떤 경험이 있나요? 조금 더 자세하게 듣고 싶어요!음.. 아 이건 좀 비밀인데 중학교때 사진을 찍게 되었는데 보통 그냥 똑딱이카메라쓰던 시절이었거든요. 그런데 DSLR이 너무 가지고 싶어서 조르기도하고 한푼두푼 모으기도해서 결국엔 DSLR을 손에 넣었어요. 되게 사소한것 같지만 나름 원하는걸 얻어낸 뜻깊은 추억이죠. 뭐든 전문가처럼 해야겠단 욕심이 강한 것 같아요.(Q. 오.. 그런데 책상에 책이 되게 많이 쌓여있네요? )책을 쌓아두는게 사실 좀 최근 관심이 가진 프로그래밍 언어라던지 관심이 가는거 위주로 가져다 놓긴 했어요. 아이폰 관련 서적이 몇개 있는데, (이제 세달 정도) 레퍼런스로 많이 찾아보기 위해서 책들이 상시대기하고 있어요. 2–3권. 스위프트라는 언어를 배우면서 기존의 코틀린 자바 스크립트 등 다양한 관심이 생겨서 , 언어들에 대한 욕구가 좀 큰 요즘입니다~(웃음)Q. 일을 하다보면 힘든 순간도 많았을 것 같아요.힘든 순간은 매순간인것 같아요(하하) 그래도 진짜 엄청 힘든 순간이 있었는데 제겐 ‘아버지’가 되게 큰 힘이 되주셨어요. 아버지께서 목사님이시거든요. 평생 부산에서만 사셨던 분이 산골 깊숙히 들어와서 농촌교회를 준비하시면서 힘든 부분이 분명 클텐데도, 지금은 사회복지기관까지 운영하시는 걸 보면 정말 대단하신 것같아요. 홀로 타지에서 모든걸 감내하셨던 부분이, 그리고 하고자 하는 일에 대한 끊임없는 열정을 많이 배워요.그런 아버지를 보고 감명받아서인지 저도 모르는 사이에 창업가 마인드가 생겼던 것 같아요. “ ‘내’가 능동적으로, ‘내’회사를, ‘내’회사에서, ‘내’회사를 위해 일하는, ‘내’일을 한다. ”라는 생각 자체가 아버지의 영향을 많이 받지 않았나싶네요.음 그리고 역시나 빼놓을 수 없는! 우리 투데잇을 사랑해주시는 유저분들이 정말 큰 힘이되요. 실은 투데잇브레이커 당시에 제가 이일을 시작하게 된 이유자체가 ‘이 서비스를 사용하는 유저들이 있다’란 거였거든요. 제겐 그분들이 제 모든 이유인것 같아요. 제 스스로가 성장할 수 있는 이유, 투데잇이 인정받을 수 있는 이유, 그 모든 이유의 근간이라고 생각해요.Q. 항상 좋은 리뷰만 있진 않았을 것 같아요. 혹시 가장 기억에 남는 리뷰 있나요?되게 오래전 리뷰인데, 많이 부족했던 투데잇을 보고 ‘대체 언제쯤 기능 업데이트 되냐, 3D게임 만드냐’라고 하셨던 리뷰가 가장 기억에 남아요. 순간은 되게 기분이 상하면서도 점점 더 잘해내고 싶단 의지가 생기더라구요. ‘내가 3D게임 개발하는 것도 아닌데, 이정도라니. 더 개발 좀 열심히 해야겠다.’하구요. 지금은 그분께 감사하죠.그때 당시만해도 투데잇이란 서비스가 되게 부족했을텐데도 끊임없이 애정해주시면서 기다려주신 유저분 중 한 분이니까요.좋았던 리뷰들은 정말로 셀 수 없이 많아요. 저희가 매주 리뷰를 함께 공유하는 자리가 있는데, ‘성적이 올랐다는 리뷰’부터, ‘투데잇 덕분에 공부 스타일이 또는 생활 습관이 바뀌었어요’, ‘지금 수험생활을 하고 있는데 힘을 얻고 있어요.’ 그리고 ‘합격소식’까지. 진짜 큰 힘이 되죠. 제가 어떤 무형의 무언가를 하고 있단게 현실에서 드러난다는게. 그게 정말 큰 힘이 되요.Q. 나에게 ‘기술’ 이란?저는 아까 말씀드렸던 것처럼 욕심이 좀 많은 편인데, 그 중 제일 욕심 많은게 바로 ‘기술’이예요. 이 분야에서 전문가가 되기 위해서 하나하나 하면 하나를 깊게 파는 스타일이예요.그래서 다양한 분야의 기술을 심도있게 잘하고 싶은 욕심이 있었는데, 투데잇을 개발하면서 그런 욕심을 부릴 수 있는 기회가 주어졌어요. 당시만 해도 당장 없는 개발팀원 자릴 메우기 위해 열심히 욕심부렸던게 지금의 이 자리에 앉게되지 않았나 생각됩니다.제게 기술이란건, 기술 자체가 가지고 싶은 그 무언가예요. 끊임없이 욕심을 내서 계속해서 닿고싶은 그런 존재?(웃음)Q. 오픈소스활동에서 핫하다는 이야기가 있는데요~오픈소스 활동이 아주 거창하진 않아요. 아직은 걸음마단계 수준이죠. 음 처음엔 제가 필요한 오픈 소스를 사용하면서 발견한 에러나 버그 부분에 대해 피드백을 드렸어요. 되게 간단한 부분이었는데 그쪽에서 긍정적으로 받아들여주셨어요. 그런 상호 피드백이 오가면서 관심을 갖게되었습니다.제트브레인스라는 회사에서 근무하시는 분의 피드백을 받는 과정이 오픈 소스활동을 통해 서로 교류할 수 있단 점이 매력적이었어요.활동을 하게된 결정적인 계기는, 다른 회사에 다니는 친구와 함께 깃허브에 올리고 IOS 개발 커뮤니티에 올렸더니 반응이 핫하더라구요. 큰 이슈는 아니지만, 사람들이 긍정적인 피드백을 해줘서 즐거운 순간이었죠.앞으로도 작은것부터 하나씩 해나갈 예정이에요. 큰 규모의 기술은 아니더라도, 투데잇의 ANDROID/IOS에 필요한, 하지만 불편함을 해소해줄 수 있는 라이브러리나 툴들을 만들어나가려고 생각을 하고 있구요. 기존에 투데잇 안에서만 쓰던 걸, 조금씩 정리해서 공유해나갈 생각입니다.Q. 안드로이드 앱 개발을 하면서 소프트웨어 아키텍쳐에 관한 고민이 있다던데, 어떤 고민을 하고계신지 들어볼 수 있을까요?지금 저희 나름대로, 기존에 있던 MVVM, VIPER라든지 그런 아키텍쳐들을 많이 보고 차용을 해서, 투데잇에도 적용을 해나가고 있는 중이에요. 직접 해보니 학교에서 책으로 배운 “프로그래밍 구조가~” 나 “아키텍쳐 구조가~” 에 대해 필요성을 뼈저리게! 몸소 부딪혀가면서 느끼는 중입니다.개발을 하다보면, 사소한 버그나 문제점을 많이 발견하게 되는데, 이를 어떻게 미리 테스트할지 또 어떻게 검증할지에 대해 고민을 하고 있어요. 그런데 기존 소스코드는 각각 다른 기능을 하는 코드가 한데 뭉쳐있어서, 이걸 분리해서 테스트하기에 용이한 아키텍쳐에 대해 개선 및 적용해나가고 있습니다.또 안드로이드와 아이폰 버전을 개발 중인데, 각각 플랫폼에 종속적인 부분을 빼놓고 두 버전 모두 동일한 구조를 가지고 갈 수없을까에 대한 고민 중인데요, 이러한 고민을 함께 하실 분들이 오셨으면 좋겠어요. 이상적인 구조를 향해서 말이죠. (웃음)Q. 현재 일하고 있는 팀원이 7명이나 된다고!네! 대표님과 단둘이 끌어왔던게 엊그제같은데, 벌써 7명의 투데잇팀으로 구성되었네요. (웃음) 사실 제게 투데잇팀은 그냥 공기같은 존재예요. 같이 있을 땐 중요성을 모르다가도, 누구하나 자릴 비우게 되면 그 느낌이 진짜 오묘해요. 서로가 서로를 너무 당연하게 자리하고 있다고 느끼고 있어서요.언젠가 한번 기호형님(COO)이 자릴 비운적이 있었어요. 아직 일한지 1년도 채 안되는데도, 옛날 옛적부터 알고 있던 사람처럼 그때 그 공허감이 되게 크더라구요.사실 좋을 땐 다 좋죠. 중요한건 일하면서 분명 좋지 않은 순간이 올텐데, 이때 서로 어떻게 커뮤니케이션을 하느냐 인것 같아요. 부정적 피드백에 대해 받아들이는 자세가 우리 팀의 가장 메리트라고 생각해요.지금 팀원들은 일에 있어서 피드백이 오갈 땐, 감정적인 건 잠깐 내려놓고, 객관적으로 앞으로 더 발전 방향에 있어서 뭘 어떻게 해야할지를 생각하는 태도를 보이거든요. 이 부분에 대해 ‘서로 핏이 잘 맞는다’라는 문장이 딱 맞는 표현 같아요.그래서 전 “같이 있으면서 어색하지 않은 그런 사이”가 좋아요. 물론 시간이 지나면서 서로 맞춰가는거겠지만, 왜 그런거 있잖아요. 함께 일을 해도 계속해서 어색한 사람이 있고 조금 풀리는 사람이 있는거. 그런 점이 저희 팀의 메리트라고 생각합니다.Q. CTO의 입장에서, 같이 일하고 싶은 개발자는 어떤 사람인가요?당연한 거겠지만, 일단 서로 존중해줄 수 있는 사람이면 좋겠어요. 아무리 비즈니스라지만 서로가 서로에게 예의와 매너가 갖춰진 사람을 원합니다.업무적으론, 뭔가 새롭게 배우는거에 대해 두려움이 없는게 좋은 개발자의 기본 자세라고 생각해요. 그래서 바로바로 과감한 도전 정신이 있는 사람! 그리고 제게 없는 재능을 가져서 서로가 상호 보완해나갈 수 있는 파트너면 좋겠어요.Q. 지원하고 싶은, 지원을 생각하는, 이 글을 보고있는 사람에게 한마디 부탁드려요!“만약에 지원을 하신다면, 마음을 단단히 먹어야할겁니다.”초반만 하더라도, 스타트업에 대한 환상이 있었어요. 이상적인 모습, 장밋빛 회사생활만을 꿈꿨거든요. 언론에서 소위 말하는 ‘젊은 창업가!’의 그 이면엔, 장밋빛을 현실화 하기위해 매일매일이 고난의 길이란걸 잊지 않으셨음 해요. 스타트업이란게 자신의 한계를 확인하는 과정이기 때문에, 같은 출발선에서 함께 발전하기 위해 달릴 준비가 되신 분을 환영합니다.또 자기 나름의 미션이 있고, 그걸 회사의 가치 성장에 일치시켜 나가면서 함께 실현해나가실 분을 모십니다!우리의 이상을 위해 함께 이 현실을 헤쳐나가실 분을 찾습니다!#투데잇 #팀원소개 #팀원인터뷰 #팀원자랑 #기업문화 #조직문화 #개발자 #개발팀 #CTO
조회수 3378

ReactorKit 시작하기

ReactorKit 시작하기오늘은 StyleShare에서 ReactorKit을 사용한지 딱 1년이 되는 날입니다. ReactorKit은 반응형 단방향 앱을 위한 프레임워크로, StyleShare와 Kakao를 비롯한 여러 기업에서 사용하고 있는 기술입니다.StyleShare의 iOS 프로젝트 첫 커밋은 2011년 8월 23일입니다. 그 뒤로 약 7년간 크고 작은 기능을 추가하며 굉장히 큰 코드베이스를 가지게 되었습니다. 특히 2015년에는 스토어 기능을 런칭하면서 기존 서비스 만큼이나 많은 코드를 작성했습니다. 서비스 복잡도는 점점 높아졌고, 지속 가능한 코드베이스를 위해 많은 개선이 필요했습니다.ReactorKit은 많은 부분에 있어서 StyleShare가 가진 고민을 해결해주었습니다. Flux와 Reactive Programming의 개념을 결합하여 만들어진 ReactorKit에서는 사용자 인터랙션과 뷰 상태가 관찰 가능한 스트림을 통해 단방향으로 전달됩니다. 뷰와 비즈니스 로직을 분리할 수 있게 되면서 모듈간 결합도가 낮아지고 테스트하기 쉬워졌습니다. 또한, 자칫 복잡해질 수 있는 비동기 코드를 일관되게 작성할 수 있게 되었습니다.이 글에서는 ReactorKit의 기본 개념과 테스트를 위한 기법을 소개 합니다.데이터 흐름ReactorKit에는 뷰(View)와 리액터(Reactor)라는 개념이 존재합니다. 뷰는 상태를 표현합니다. 뷰 컨트롤러나 셀도 모두 뷰에 해당합니다. 뷰는 사용자 인터랙션을 추상화하여 리액터에 전달하고, 리액터에서 전달받은 상태를 각각의 뷰 컴포넌트에 바인드합니다. 뷰는 비즈니스 로직을 수행하지 않습니다.반대로, 리액터는 뷰의 상태를 관리합니다. 뷰에서 액션을 전달받으면 비즈니스 로직을 수행한 뒤 상태를 변경하여 다시 뷰에 전달합니다. 리액터는 UI 레이어에서 독립적이기 때문에 비교적 테스트하기 쉽습니다.ViewView 프로토콜을 적용하면 뷰를 정의할 수 있습니다. DisposeBag 속성과 bind(reactor:) 메서드를 필수로 정의해야 합니다.import ReactorKit import RxSwift class UserViewController: UIViewController, View { var disposeBag = DisposeBag() func bind(reactor: UserViewReactor) { } }<iframe width="700" height="250" data-src="/media/78a16e327ba4eb073cc5bdbb703c81f9?postId=c7b52fbb131a" data-media-id="78a16e327ba4eb073cc5bdbb703c81f9" data-thumbnail="https://i.embed.ly/1/image?url=https://avatars2.githubusercontent.com/u/931655?s=400&v=4&key=a19fcc184b9711e1b4764040d3dc5c07" class="progressiveMedia-iframe js-progressiveMedia-iframe" allowfullscreen="" frameborder="0" src="https://medium.com/media/78a16e327ba4eb073cc5bdbb703c81f9?postId=c7b52fbb131a" style="display: block; position: absolute; margin: auto; max-width: 100%; box-sizing: border-box; transform: translateZ(0px); top: 0px; left: 0px; width: 700px; height: 236.984px;">이 프로토콜을 정의하면 reactor 속성이 자동으로 생성됩니다. 이 속성에 새로운 값이 지정되면 bind(reactor:) 메서드가 자동으로 호출됩니다. 이곳에는 사용자 인터랙션을 리액터에 바인드하거나, 리액터의 상태를 각각의 뷰 컴포넌트에 바인드하는 코드를 작성합니다.func bind(reactor: UserViewReactor) { // Action self.followButton.rx.tap .map { Reactor.Action.follow } .bind(to: reactor.action) .disposed(by: self.disposeBag) // State reactor.state.map { $0.isFollowing } .distinctUntilChanged() .bind(to: self.followButton.rx.isSelected) .disposed(by: self.disposeBag) }<iframe width="700" height="250" data-src="/media/6a6d5aa66b156cae7d4475f6ed13efb0?postId=c7b52fbb131a" data-media-id="6a6d5aa66b156cae7d4475f6ed13efb0" data-thumbnail="https://i.embed.ly/1/image?url=https://avatars2.githubusercontent.com/u/931655?s=400&v=4&key=a19fcc184b9711e1b4764040d3dc5c07" class="progressiveMedia-iframe js-progressiveMedia-iframe" allowfullscreen="" frameborder="0" src="https://medium.com/media/6a6d5aa66b156cae7d4475f6ed13efb0?postId=c7b52fbb131a" style="display: block; position: absolute; margin: auto; max-width: 100%; box-sizing: border-box; transform: translateZ(0px); top: 0px; left: 0px; width: 700px; height: 325px;">Reactor리액터를 정의하기 위해서는 Reactor 프로토콜을 사용합니다. 사용자 인터랙션을 표현하는 Action과 뷰의 상태를 표현하는 State, 그리고 상태를 변경하는 가장 작은 단위인 Mutation을 클래스 내부에 필수로 정의해야 합니다. 또한 가장 첫 상태를 나타내는 initialState가 필요합니다.import ReactorKit import RxSwift final class UserViewReactor: Reactor { enum Action { case follow } enum Mutation { case setFollowing(Bool) } enum State { var isFollowing: Bool } let initialState: State = State(isFollowing: false) }<iframe width="700" height="250" data-src="/media/572f53fb442c67060d2a69f90a42a07b?postId=c7b52fbb131a" data-media-id="572f53fb442c67060d2a69f90a42a07b" data-thumbnail="https://i.embed.ly/1/image?url=https://avatars2.githubusercontent.com/u/931655?s=400&v=4&key=a19fcc184b9711e1b4764040d3dc5c07" class="progressiveMedia-iframe js-progressiveMedia-iframe" allowfullscreen="" frameborder="0" src="https://medium.com/media/572f53fb442c67060d2a69f90a42a07b?postId=c7b52fbb131a" style="display: block; position: absolute; margin: auto; max-width: 100%; box-sizing: border-box; transform: translateZ(0px); top: 0px; left: 0px; width: 700px; height: 435px;">Action이나 State와 달리 Mutation은 리액터 클래스 밖으로 노출되지 않습니다. 대신, 클래스 내부에서 Action과 State를 연결하는 역할을 수행합니다. Action이 리액터에 전달되면 두 단계를 거쳐서 뷰의 상태를 변경합니다.mutate() 함수에서는 Action 스트림을 Mutation 스트림으로 변환하는 역할을 합니다. 이곳에서 네트워킹이나 비동기로직 등의 사이드 이펙트를 처리합니다. 그 결과로 Mutation을 방출하면 그 값이 reduce() 함수로 전달됩니다. reduce() 함수는 이전 상태와 Mutation을 받아서 다음 상태를 반환합니다.func mutate(action: Action) -> Observable { switch action { case .follow: return UserService.follow() .map { Mutation.setFollowing(true) } .catchErrorJustReturn(Mutation.setFollowing(false)) case .unfollow: return UserService.unfollow() .map { Mutation.setFollowing(false) } .catchErrorJustReturn(Mutation.setFollowing(true)) } } func reduce(state: State, mutation: Mutation) -> State { var newState = state switch mutation { case let setFollowing(isFollowing): newState.isFollowing = isFollowing } return newState }<iframe width="700" height="250" data-src="/media/dc8fbdce8314a7eba99be944241c5432?postId=c7b52fbb131a" data-media-id="dc8fbdce8314a7eba99be944241c5432" data-thumbnail="https://i.embed.ly/1/image?url=https://avatars2.githubusercontent.com/u/931655?s=400&v=4&key=a19fcc184b9711e1b4764040d3dc5c07" class="progressiveMedia-iframe js-progressiveMedia-iframe" allowfullscreen="" frameborder="0" src="https://medium.com/media/dc8fbdce8314a7eba99be944241c5432?postId=c7b52fbb131a" style="display: block; position: absolute; margin: auto; max-width: 100%; box-sizing: border-box; transform: translateZ(0px); top: 0px; left: 0px; width: 700px; height: 522.984px;">테스팅테스트를 위해 가장 먼저 고민하게 되는 것은 ‘무엇을 테스트할 것인가’에 대한 것입니다. ReactorKit을 사용하면 뷰와 로직이 분리되어 상대적으로 쉽게 해답을 얻을 수 있습니다.View사용자 인터랙션이 발생했을 때 Action이 리액터로 잘 전달되는지리액터의 상태가 바뀌었을 때 뷰의 컴포넌트 속성이 잘 변경되는지ReactorAction을 받았을 때 원하는 State로 잘 변경되는지뷰 테스팅리액터의 stub 기능을 이용하면 뷰를 쉽게 테스트할 수 있습니다. stub 기능을 활성화하면 리액터가 받은 Action을 모두 기록하고, mutate()와 reduce()를 실행하는 대신 외부에서 상태를 설정할 수 있게 됩니다.func testAction_refresh() { // 1. Stub 리액터를 준비합니다. let reactor = MyReactor() reactor.stub.isEnabled = true // 2. Stub된 리액터를 주입한 뷰를 준비합니다. let view = MyView() view.reactor = reactor // 3. 사용자 인터랙션을 발생시킵니다. view.refreshControl.sendActions(for: .valueChanged) // 4. Reactor에 액션이 잘 전달되었는지를 검증합니다. XCTAssertEqual(reactor.stub.actions.last, .refresh) } func testState_isLoading() { // 1. Stub 리액터를 준비합니다. let reactor = MyReactor() reactor.stub.isEnabled = true // 2. Stub된 리액터를 주입한 뷰를 준비합니다. let view = MyView() view.reactor = reactor // 3. 리액터의 상태를 임의로 설정합니다. reactor.stub.state.value = MyReactor.State(isLoading: true) // 4. 그 때 뷰 컴포넌트의 속성이 잘 변하는지를 검증합니다. XCTAssertEqual(view.activityIndicator.isAnimating, true) }<iframe width="700" height="250" data-src="/media/9e5e0349766c69076a5081cbd680645b?postId=c7b52fbb131a" data-media-id="9e5e0349766c69076a5081cbd680645b" data-thumbnail="https://i.embed.ly/1/image?url=https://avatars2.githubusercontent.com/u/931655?s=400&v=4&key=a19fcc184b9711e1b4764040d3dc5c07" class="progressiveMedia-iframe js-progressiveMedia-iframe" allowfullscreen="" frameborder="0" src="https://medium.com/media/9e5e0349766c69076a5081cbd680645b?postId=c7b52fbb131a" style="display: block; position: absolute; margin: auto; max-width: 100%; box-sizing: border-box; transform: translateZ(0px); top: 0px; left: 0px; width: 700px; height: 721px;">리액터 테스팅리액터는 뷰에 비해서 상대적으로 테스트하기 쉽습니다. Action이 전달되었을 때 비즈니스 로직을 수행하여 State가 바뀌는지를 확인하면 됩니다.func testBookmark() { // 1. 리액터를 준비합니다. let reactor = MyReactor() // 2. 리액터에 액션을 전달합니다. reactor.action.onNext(.toggleBookmarked) // 3. 리액터의 상태가 변경되는지를 검증합니다. XCTAssertEqual(reactor.currentState.isBookmarked, true) } func testUnbookmark() { // 1. 리액터를 준비합니다. 액션을 미리 한 번 전달해서 테스트 환경을 만들어둡니다. let reactor = MyReactor() reactor.action.onNext(.toggleBookmarked) // 2. 리액터에 액션을 한 번 더 전달합니다. reactor.action.onNext(.toggleBookmarked) // 3. 리액터의 상태가 변경되는지를 검증합니다. XCTAssertEqual(reactor.currentState.isBookmarked, false) }<iframe width="700" height="250" data-src="/media/32af3eac8c1c9646bf95ea1442ad8ff4?postId=c7b52fbb131a" data-media-id="32af3eac8c1c9646bf95ea1442ad8ff4" data-thumbnail="https://i.embed.ly/1/image?url=https://avatars2.githubusercontent.com/u/931655?s=400&v=4&key=a19fcc184b9711e1b4764040d3dc5c07" class="progressiveMedia-iframe js-progressiveMedia-iframe" allowfullscreen="" frameborder="0" src="https://medium.com/media/32af3eac8c1c9646bf95ea1442ad8ff4?postId=c7b52fbb131a" style="display: block; position: absolute; margin: auto; max-width: 100%; box-sizing: border-box; transform: translateZ(0px); top: 0px; left: 0px; width: 700px; height: 522.984px;">마치며ReactorKit은 지금까지 CocoaPods에서 약 3만 7천회 다운로드 되었고, 약 730개 앱에서 사용되고 있습니다. 최근에는 Wantedly에서 사용하며 일본에서도 많은 호응을 얻고 있습니다. 공개된지 1년밖에 되지 않았지만 굉장히 좋은 평을 받으며 성장하고 있는 프레임워크입니다. 만약 새로운 프로젝트를 시작하거나, StyleShare와 비슷한 고민을 하고 계신다면 ReactorKit을 강력하게 추천합니다.ReactorKit GitHublet’Swift 2017 ReactorKit 발표 영상let’Swift 2017 ReactorKit 발표 자료#스타일쉐어 #개발팀 #개발자 #경험공유 #인사이트
조회수 3462

빅데이터 '분석가' '전문가'가 부족한 이유...

업계에서는 대기업이나 공공기관 등의 데이터 분석 수요가 커지면서 빅데이터를 다루거나 데이터 분석가들을 찾는 기업이 늘어난다고 하는 기사나 이야기들이 떠돌아다닌다.한국정보화진흥원에서 발간한 '2015년 빅데이터 시장 현황조사'보고서에 의하면 빅데이터 공급기업과 수요기업 모두 빅데이터 분석가가 필요하다고 내다보고, 많은 데이터 분석가가 필요하다고 이야기했다.분야도 금융을 비롯하여 통신, 커머스 등을 아우르고, IT 관련부서뿐만 아니라, 현업이라고 불리는 마케팅이나 영업도 포함된 관계에서의 데이터 활용을 위해서 빅데이터 '분석가'가 필요하다고 이야기를 한다.죄송하지만.. 한국형 환경에서는 '빅데이터 분석가'나 '전문가'는 그다지 필요 없을 것 같다.1. 변화하지 않는 기업어차피 정해져 있는 프로세서, 내부 R&R과 내부 혁신을 하기 위한 인사이트를 찾고, 데이터 변수를 찾는다고 하더라도 굳이 기업 내부의 변화를 일으키지 않을 것이기 때문에 '진정한 데이터 분석가'는 해당 기업에 무의미할 것이다.정말, 전문가라면 '내부 혁신'에 대한 키워드들을 뽑아줄 텐데... 이런 이야기는 '컨설팅'업체에서도 하지 않고, 내부에서도 '금기'시 해야 할 단어들이 대부분이다.만일, 대기업인 중요 키워드가 '오너'의 키가 문제라고 지적한다면... 아마도, 해당 부서나 관련자들은 움직이지도 못할 것이다.죄송하지만, '내부 혁신'이 불가능하고, '오너'중심의 대기업은 데이터 분석가가 필요하지 않다. 다만, '오너'의 생각을 읽고서 적당하게 마사지된 '데이터'를 보여줄 '외부 데이터 분석'서비스 업체만 필요할 뿐이다.그래서, 국내에서는 데이터 분석 서비스 업체 정도가 적당하다.2. 기업과 조직에 데이터가 없다.프로세스 하단에서 동작하는 수많은 로그들을 추적 감시, 감사하는 시스템이 가동되고 있어야 하며, 고객 서비스를 하는 서비스 집단에서도 하단에서 아이디어가 상단으로 올라가는 환경들이 이미 가동되고 있어야 한다. 데이터의 대부분은 그런 인사이트를 증명하는 근거가 되기 때문이다.이미, 중요한 움직임을 보이고 있을 때에만 '의미 있는 정보'를 추출할 데이터들이 축적되는데... 사실상, 의미 없이 마사지된 '보고서'들만 존재한다.원천적으로 의미 있는 데이터를 추출할 데이터가 있어야 하는데.. 대부분이 왜곡된 정보들이거나, 특정 힘에 의해서 데이터들이 왜곡돼 있다면, 해당 기업과 조직은 데이터가 없다고 봐야 한다.3. 오랜 경험을 축적한 실전 전문가들이 일찍 퇴직한다.빅데이터를 통해서 단지 현황만을 보여주는 것이 아니라, 기업의 미래나 새로운 먹거리를 유도할 수 있는 인사이트를 추출하기 위해서는 해당 도메인이나 해당 마켓에 익숙하고 경험이 풍부한 전문가들이 같이 있어야 한다. 실제, 데이터가 의미하는 방향성이나 수치, 지수가 어떤 것을 의미하는지 읽어 줄 수 있는 것은 데이터 전문가들이 하는 일이 아니다.해당 업무와 해당 도메인의 전문가가 그 '수치'를 읽어 줄 수 있는 것이다.대부분의 기업에서 '실전'이거나 '실제 업무'에 익숙한 전문가나 경험이 축적된 사람들은 하청업체이거나 이미 퇴직한 경험이 풍부한 사람들이다.해당 기업에서는 아무리 데이터가 분석되어도 어떤 의미인지 판독해줄 사람이 없다.4. IT기술 전문가가 필요한 것이 아니다.빅데이터나 머신러닝과 같은 지식화 인사이트는 절대 IT기술이나 주변의 소프트웨어 설루션으로 만들어지는 것이 아니다. 기업 내부에 축적된 '지식'을 기반으로 '사람'을 기준으로 데이터가 만들어진다. 데이터 분석 전문가는 단지, 그것의 가치를 '판정'해줄 수 있는 기준을 마련해줄 뿐이다.대부분의 '한국형'조직들은 데이터 거버넌스 조직도 없으며, 제대로 된 인사시스템이 가동되지 않고 있다. 슬프지만, 빅데이터 전문가들은 내부에서 영입하는 것이 아니라, 내부에서 자생적으로 생성되는 것이다.자생적으로 빅데이터 전문가가 생성되지 않는 조직은 이미, 지식화가 불가능한 형태이기 때문에, 너무 무리하지 말고, 현재 환경에서 연착륙하는 것을 고려하는 것이 최선일 것이다.역시, '한국형'에서는 굳이 '빅데이터 분석가'가 필요한 것이 아니라, '빅데이터 분석가 코스프레'를 하는 사람이 필요한 것 아닌가?오너가 이야기하는 'A'를 'A'처럼 써줄 수 있는 코스프레가 가능한 사람이면 충분한 것 아닌가 한다.
조회수 3240

우아한 설계의 첫걸음, ES7의 decorator

하루가 멀다 하고 신기술이 쏟아지는 요즘 자바스크립트 또한 계속해서 새로운 모습으로 바뀌고 있습니다. ECMAScript 2015(이하 ES6)에 새롭게 등장한 Arrow function, Class, Generator 등이 그중 하나라 할 수 있습니다. 오늘은 ECMAScript 2016(이하 ES7)에서 새롭게 제안된 Decorator에 대해 알아보려 합니다.Decorator란?ES7 스펙 명세(링크)에는 Decorator를 아래와 같이 설명하고 있습니다.선언된 클래스와 그 프로퍼티들을 디자인 시간에 변경할 수 있는 편리한 문법위 문장만 봐서는 도대체 Decorator가 어떤 역할을 하는지 감이 오지 않습니다. 백문이 불여일견이라고 예제를 통해 Decorator를 어떻게 활용할 수 있는지 알아보겠습니다. 아래 코드는 Decorator를 이용해 설계한 클래스 코드의 일부입니다.@withSuperEngine class Car {     ...   @readOnly  manufacturer = 'ZOYI'   ... } 클래스와 클래스의 프로퍼티가 어떤 성질을 가지고 있는지 한눈에 보이시나요? Car는 슈퍼 엔진을 가지고 있고 manufacturer는 변경할 수 없는 값이라는 것을 소설을 읽는 것처럼 쉽게 이해할 수 있습니다. 이처럼 Decorator를 이용하면 코드를 우아하게 작성할 수 있습니다. 그렇다면 어떻게 Decorator를 정의하고 사용할 수 있을까요?Decorator는 최종적으로 채택된 스펙이 아니기 때문에 babel과 함께 사용해야 합니다. babel 설정은 링크에서 확인할 수 있습니다.Decorator의 선언 및 사용방법Decorator는 사실 함수입니다. 함수를 선언한 뒤 ‘@’ 키워드를 이용해 선언된 함수를 Decorator로 사용할 수 있습니다. @withSuperEngine, @readonly, @say.hello, @hello(...) 등이 사용 가능한 Decorator의 호출 형태입니다. Decorator는 클래스를 꾸밀지, 클래스의 프로퍼티를 꾸밀지에 따라 선언하는 방법이 달라집니다.클래스 프로퍼티의 Decorator먼저 클래스 프로퍼티의 Decorator를 정의하고 사용하는 방법에 대해 알아보겠습니다. 이 경우에는 프로퍼티의 descriptor를 인자로 받아 새로운 descriptor를 반환하는 형태를 가집니다. (descriptor에서 설정할 수 있는 여러 값은 링크를 확인해주세요.)그럼 이제 readonly 역할을 하는 Decorator를 작성하고 테스트를 해 보도록 하겠습니다.function readonly(target, property, descriptor) {     descriptor.writable = false   return descriptor } class Car {     @readonly   manufacturer = 'ZOYI' } const myCar = new Car()   myCar.manufacturer = ‘JOY’ // 새로운 값을 할당하려고 한다면 에러가 납니다. 또 다른 예제로 클래스의 프로퍼티를 열거할 때 열거 대상에서 제외하는 Decorator를 작성해 보겠습니다.function nonenumerable(target, property, descriptor) {     descriptor.enumerable = false   return descriptor } class Car {     @nonenumerable  acceleration = 10 manufacturer = 'ZOYI' } const myCar = new Car()   for (let key in myCar) {     console.log(key)  // manufacturer 만 출력이 된다. acceleration는 열거 대상에서 제외된다. } 단 몇 줄만으로 우리는 클래스의 프로퍼티를 읽기 전용으로 만든다던지 열거 대상에서 제외했습니다. 참 편리하지 않나요? Decorator의 활용은 여기서 끝나지 않습니다. 메모이제이션을 하는 메서드를 만들수 있고 클래스에 자동으로 바인드된 메서드로 만들 수도 있습니다.Decorator는 제안된 지 얼마 안 됐지만 많은 사람들이 활발히 연구 중입니다. github에는 지금도 계속해서 Decorator에 관련된 라이브러리들이 올라오고 있습니다. 그중 core-decorators.js는 미리 정의된 유용한 Decorator 패키지를 제공합니다.클래스의 Decorator클래스의 Decorator는 타겟 클래스의 생성자를 인자로 받습니다. 사용자는 인자로 받은 생성자를 입맛에 맞게 바꾼 뒤 반환을 해 주면 됩니다.function setAnimalSound(sound) {     return (target) => {     target.prototype.sound = sound     return target   } } @setAnimalSound('oink') class Pig {     say() {     return this.sound   } } @setAnimalSound('quack') class Duck {     say() {     return this.sound   } } const pig = new Pig()   console.log(pig.say()) // ‘oink’ 출력 const duck = new Duck()   console.log(duck.say()) // ‘quack’ 출력 위 코드처럼 오리나 돼지의 울음소리를 클래스 내부에서 정의하지 않고 클래스 Decorator를 사용해서 정의할 수 있습니다.(사실 이런 코드는 설계 관점에서 봤을 때 바람직하지 않지만 Decorator를 사용할 수 있는 여러 방법 중에 하나라고 봐주시면 감사하겠습니다.)클래스 Decorator는 클래스의 생성자를 바꾸는 것에 국한되지 않고 완전히 다른 클래스의 생성자로 바꿔치기도 할 수 있습니다. 아래 코드는 그 예제를 보여줍니다.function withBus(target) {     return class Bus {     say() {       return 'I am bus'     }   } } @withBus class Car {     say() {     return 'I am car'   } } const car = new Car()   console.log(car.say()) // ‘I am bus’ 출력 이런 구현 방식은 특정 상황에서 클래스 자체를 하이재킹 함으로써 전통적인 분기문 예외 처리가 아닌 보편적인 프로그래밍을 할 수 있게 도와줍니다.클래스 Decorator는 Cross-Cutting-Concern(전체 설계에서 빈번하게 나오는 관심사를 쉽게 모듈화 시키지 못하는 상황)이나 React에서 컴포넌트 하이재킹을 쉽게 해결해줄 수 있는 방법을 제공합니다. 이런 상황을 어떻게 효율적으로 처리하는지에 대해서는 Decorator를 소개하는 글의 취지에 맞지 않아 다음에 연재할 글에서 다룰 예정입니다.마무리이상으로 ES7에 새롭게 제안된 클래스 및 클래스 프로퍼티에 사용할 수 있는 Decorator에 대해서 알아봤습니다. Decorator는 Java, Python과 같은 언어에서 이미 존재하는 문법이기 때문에 이런 설계가 기존에 없던 새로운 방법은 아닙니다. 하지만 오랫동안 ES5에 머물던 자바스크립트가 ES6, ES7 그리고 최근에는 ES8까지 빠르게 변하고 있는 스펙 속에 다른 언어의 장점을 품는 것은 그 자체로 상당히 도전적인 변화라 생각합니다. Decorator 문법은 클래스와 그 파라미터를 꾸밀 수 있는 것에 멈추지 않고 함수의 파라미터에도 꾸밀 수 있게 드래프트 버전이 나온 상태입니다. 자바스크립트에서 Decorator를 이용한 우아한 설계가 어디까지 발전할 수 있는지, 그리고 향후 자바스크립트의 행보가 기대됩니다.#조이코퍼레이션 #개발자 #개발팀 #인사이트 #경험공유 #일지
조회수 1130

비트윈의 HBase 스키마 해부 - VCNC Engineering Blog

비트윈에서는 HBase를 메인 데이터베이스로 이용하고 있습니다. 유저 및 커플에 대한 정보와 커플들이 주고받은 메시지, 업로드한 사진 정보, 메모, 기념일, 캘린더 등 서비스에서 만들어지는 다양한 데이터를 HBase에 저장합니다. HBase는 일반적인 NoSQL과 마찬가지로 스키마를 미리 정의하지 않습니다. 대신 주어진 API를 이용해 데이터를 넣기만 하면 그대로 저장되는 성질을 가지고 있습니다. 이런 점은 데이터의 구조가 바뀔 때 별다른 스키마 변경이 필요 없다는 등의 장점으로 설명되곤 하지만, 개발을 쉽게 하기 위해서는 데이터를 저장하는데 어느 정도의 규칙이 필요합니다. 이 글에서는 비트윈이 데이터를 어떤 구조로 HBase에 저장하고 있는지에 대해서 이야기해 보고자 합니다.비트윈에서 HBase에 데이터를 저장하는 방법Thrift를 이용해 데이터 저장: Apache Thrift는 자체적으로 정의된 문법을 통해 데이터 구조를 정의하고 이를 직렬화/역직렬화 시킬 수 있는 기능을 제공합니다. 비트윈에서는 서버와 클라이언트가 통신하기 위해 Thrift를 이용할 뿐만 아니라 HBase에 저장할 데이터를 정의하고 데이터 저장 시 직렬화를 위해 Thrift를 이용합니다.하나의 Row에 여러 Column을 트리 형태로 저장: HBase는 Column-Oriented NoSQL로 분류되며 하나의 Row에 많은 수의 Column을 저장할 수 있습니다. 비트윈에서는 Column Qualifier를 잘 정의하여 한 Row에 여러 Column을 논리적으로 트리 형태로 저장하고 있습니다.추상화된 라이브러리를 통해 데이터에 접근: 비트윈에서는 HBase 클라이언트 라이브러리를 직접 사용하는 것이 아니라 이를 래핑한 Datastore라는 라이브러리를 구현하여 이를 이용해 HBase의 데이터에 접근합니다. GAE의 Datastore와 인터페이스가 유사하며 실제 저장된 데이터들을 부모-자식 관계로 접근할 수 있게 해줍니다.트랜잭션을 걸고 데이터에 접근: HBase는 일반적인 NoSQL과 마찬가지로 트랜잭션을 제공하지 않지만 비트윈에서는 자체적으로 제작한 트랜잭션 라이브러리인 Haeinsa를 이용하여 Multi-Row ACID 트랜잭션을 걸고 있습니다. Haeinsa 덕분에 성능 하락 없이도 데이터 무결성을 유지하고 있습니다.Secondary Index를 직접 구현: HBase에서는 데이터를 Row Key와 Column Qualifier를 사전식 순서(lexicographical order)로 정렬하여 저장하며 정렬 순서대로 Scan을 하거나 바로 임의 접근할 수 있습니다. 하지만 비트윈의 어떤 데이터들은 하나의 Key로 정렬되는 것으로는 충분하지 않고 Secondary Index가 필요한 경우가 있는데, HBase는 이런 기능을 제공하지 않고 있습니다. 비트윈에서는 Datastore 라이브러리에 구현한 Trigger을 이용하여 매우 간단한 형태의 Secondary Index를 만들었습니다.비트윈 HBase 데이터 구조 해부페이스북의 메시징 시스템에 관해 소개된 글이나, GAE의 Datastore에 저장되는 구조를 설명한 글을 통해 HBase에 어떤 구조로 데이터를 저장할지 아이디어를 얻을 수 있습니다. 비트윈에서는 이 글과는 약간 다른 방법으로 HBase에 데이터를 저장합니다. 이에 대해 자세히 알아보겠습니다.전반적인 구조비트윈에서는 데이터를 종류별로 테이블에 나누어 저장하고 있습니다. 커플과 관련된 정보는 커플 테이블에, 유저에 대한 정보는 유저 테이블에 나누어 저장합니다.각 객체와 관련된 정보는 각각의 HBase 테이블에 저장됩니다.또한, 관련된 데이터를 하나의 Row에 모아 저장합니다. 특정 커플과 관련된 사진, 메모, 사진과 메모에 달린 댓글, 기념일 등의 데이터는 해당 커플과 관련된 하나의 Row에 저장됩니다. Haeinsa를 위한 Lock Column Family를 제외하면, 데이터를 저장하기 위한 용도로는 단 하나의 Column Family만 만들어 사용하고 있습니다.각 객체의 정보와 자식 객체들은 같은 Row에 저장됩니다.또한, 데이터는 기본적으로 하나의 Column Family에 저장됩니다.이렇게 한 테이블에 같은 종류의 데이터를 모아 저장하게 되면 Region Split하는 것이 쉬워집니다. HBase는 특정 테이블을 연속된 Row들의 집합인 Region으로 나누고 이 Region들을 여러 Region 서버에 할당하는 방식으로 부하를 분산합니다. 테이블을 Region으로 나눌 때 각 Region이 받는 부하를 고려해야 하므로 각 Row가 받는 부하가 전체적으로 공평해야 Region Split 정책을 세우기가 쉽습니다. 비트윈의 경우 커플과 관련된 데이터인 사진이나 메모를 올리는 것보다는 유저와 관련된 데이터인 메시지를 추가하는 트래픽이 훨씬 많은데, 한 테이블에 커플 Row와 유저 Row가 섞여 있다면 각 Row가 받는 부하가 천차만별이 되어 Region Split 정책을 세우기가 복잡해집니다. RegionSplitPolicy를 구현하여 Region Split 정책을 잘 정의한다면 가능은 하지만 좀 더 쉬운 방법을 택했습니다.또한, 한 Row에 관련된 정보를 모아서 저장하면 성능상 이점이 있습니다. 기본적으로 한 커플에 대한 데이터들은 하나의 클라이언트 요청을 처리하는 동안 함께 접근되는 경우가 많습니다. HBase는 같은 Row에 대한 연산을 묶어 한 번에 실행시킬 수 있으므로 이 점을 잘 이용하면 성능상 이득을 얻을 수 있습니다. 비트윈의 데이터 구조처럼 특정 Row에 수많은 Column이 저장되고 같은 Row의 Column들에 함께 접근하는 경우가 많도록 설계되어 있다면 성능 향상을 기대할 수 있습니다. 특히 Haeinsa는 한 트랜잭션에 같은 Row에 대한 연산은 커밋시 한 번의 RPC로 묶어 처리하므로 RPC에 드는 비용을 최소화합니다. 실제 비트윈에서 가장 많이 일어나는 연산인 메시지 추가 연산은 그냥 HBase API를 이용하여 구현하는 것보다 Haeinsa Transaction API를 이용해 구현하는 것이 오히려 성능이 좋습니다.Column Qualifier의 구조비트윈은 커플들이 올린 사진 정보들을 저장하며, 또 사진들에 달리는 댓글 정보들도 저장합니다. 한 커플을 Root라고 생각하고 커플 밑에 달린 사진들을 커플의 자식 데이터, 또 사진 밑에 달린 댓글들을 사진의 자식 데이터라고 생각한다면, 비트윈의 데이터들을 논리적으로 트리 형태로 생각할 수 있습니다. 비트윈 개발팀은 Column Qualifier를 잘 정의하여 실제로 HBase에 저장할 때에도 데이터가 트리 형태로 저장되도록 설계하였습니다. 이렇게 트리 형태로 저장하기 위한 Key구조에 대해 자세히 알아보겠습니다.Column Qualifier를 설계할 때 성능을 위해 몇 가지 사항들을 고려해야 합니다. HBase에서는 한 Row에 여러 Column이 들어갈 수 있으며 Column들은 Column Qualifier로 정렬되어 저장됩니다. ColumnRangeFilter를 이용하면 Column에 대해 정렬 순서로 Scan연산이 가능합니다. 이 때 원하는 데이터를 순서대로 읽어야 하는 경우가 있는데 이를 위해 Scan시, 최대한 Sequential Read를 할 수 있도록 설계해야 합니다. 또한, HBase에서 데이터를 읽어올 때, 실제로 데이터를 읽어오는 단위인 Block에 대해 캐시를 하는데 이를 Block Cache라고 합니다. 실제로 같이 접근하는 경우가 빈번한 데이터들이 최대한 근접한 곳에 저장되도록 설계해야 Block Cache의 도움을 받을 수 있습니다.비트윈에서는 특정 커플의 사진이나 이벤트를 가져오는 등의 특정 타입으로 자식 데이터를 Scan해야하는 경우가 많습니다. 따라서 특정 타입의 데이터를 연속하게 저장하여 최대한 Sequential Read가 일어나도록 해야 합니다. 이 때문에 Column Qualifier가 가리키는 데이터의 타입을 맨 앞에 배치하여 같은 타입의 자식 데이터들끼리 연속하여 저장되도록 하였습니다. 만약 가리키는 데이터의 타입과 아이디가 Parent 정보 이후에 붙게 되면 사진 사이사이에 각 사진의 댓글 데이터가 끼어 저장됩니다. 이렇게 되면 사진들에 대한 데이터를 Scan시, 중간중간 저장된 댓글 데이터들 때문에 완벽한 Sequential Read가 일어나지 않게 되어 비효율적입니다.이렇게 특정 타입의 자식들을 연속하게 모아 저장하는 묶음을 컬렉션이라고 합니다. 컬렉션에는 컬렉션에 저장된 자식들의 개수나 새로운 자식을 추가할 때 발급할 아이디 등을 저장하는 Metadata가 있습니다. 이 Metadata도 특정 Column에 저장되므로 Metadata를 위한 Column Qualifier가 존재합니다. 이를 위해 Column Qualifier에는 Column Qualifier가 자칭하는 데이터가 Metadata인지 표현하는 필드가 있는데, 특이하게도 메타데이터임을 나타내는 값이 1이 아니라 0입니다. 이는 Metadata가 컬렉션의 맨 앞쪽에 위치하도록 하기 위함입니다. 컬렉션을 읽을 때 보통 맨 앞에서부터 읽는 경우가 많고, 동시에 Metadata에도 접근하는 경우가 많은데, 이 데이터가 인접하게 저장되어 있도록 하여 Block Cache 적중이 최대한 일어나도록 한 것입니다.Datastore 인터페이스비트윈에서는 이와 같은 데이터 구조에 접근하기 위해 Datastore라는 라이브러리를 구현하여 이를 이용하고 있습니다. HBase API를 그대로 이용하는 것보다 좀 더 쉽게 데이터에 접근할 수 있습니다. GAE의 Datastore와 같은 이름인데, 실제 인터페이스도 매우 유사합니다. 이 라이브러리의 인터페이스에 대해 간단히 알아보겠습니다.Key는 Datastore에서 HBase에 저장된 특정 데이터를 지칭하기 위한 클래스입니다. 논리적으로 트리 형태로 저장된 데이터 구조를 위해 부모 자식 관계를 이용하여 만들어 집니다.Key parentKey = new Key(MType.T_RELATIONSHIP, relId); Key photoKey = new Key(parentKey, MType.T_PHOTO, photoId); // 특정 커플 밑에 달린 사진에 대한 키 Datastore는 Key를 이용해 Row Key와 Column Qualifier를 만들어 낼 수 있습니다. Datastore는 이 정보를 바탕으로 HBase에 새로운 데이터를 저장하거나 저장된 데이터에 접근할 수 있는 메서드를 제공합니다. 아래 코드에서 MUser 클래스는 Thrift로 정의하여 자동 생성된 클래스이며, Datastore에서는 이 객체를 직렬화 하여 HBase에 저장합니다.MUser user = new MUser(); user.setNickname("Alice"); user.setGender(Gender.FEMALE); user.setStatus("Hello World!"); Key userKey = new Key(MType.T_USER, userId); getDatastore().put(userKey, user); user = getDatastore().get(userKey); getDatastore().delete(userKey); 또한, Datastore는 Key를 범위로 하여 Scan연산이 할 수 있도록 인터페이스를 제공합니다. Java에서 제공하는 Try-with-resource문을 이용하여 ResultScanner를 반드시 닫을 수 있도록 하고 있습니다. 내부적으로 일단 특정 크기만큼 배치로 가져오고 더 필요한 경우 더 가져오는 식으로 구현되어 있습니다.try (CloseableIterable> entries = getDatastore().subSibling(fromKey, fromInclusive, toKey, toInclusive)) { for (KeyValue entry : entries) { // do something } } Secondary Index 구현 방법HBase는 데이터를 Row Key나 Column Qualifier로 정렬하여 저장합니다. 이 순서로만 Sequential Read를 할 수 있으며 Key값을 통해 특정 데이터를 바로 임의 접근할 수 있습니다. 비트윈에서는 특정 달에 해당하는 이벤트들을 읽어오거나 특정 날짜의 사진들의 리스트를 조회하는 등 id 순서가 아니라 특정 값을 가지는 데이터를 순서대로 접근해야 하는 경우가 있습니다. 이럴 때에도 효율적으로 데이터에 접근하기 위해서는 id로 정렬된 것 외에 특정 값으로 데이터를 정렬할 수 있어야 합니다. 하지만 HBase에서는 이와 같은 Secondary Index 같은 기능을 제공하지 않습니다. 비트윈 개발팀은 이에 굴하지 않고 Secondary Index를 간단한 방법으로 구현하여 사용하고 있습니다.구현을 간단히 하기 위해 Secondary Index를 다른 데이터들과 마찬가지로 특정 타입의 데이터로 취급하여 구현하였습니다. 따라서 Index에 대해서도 Column Qualifier가 발급되며, 이때, Index에 해당하는 id를 잘 정의하여 원하는 순서의 Index를 만듭니다. 이런 식으로 원하는 순서로 데이터를 정렬하여 저장할 수 있으며 이 인덱스를 통해 특정 필드의 값의 순서대로 데이터를 조회하거나 특정 값을 가지는 데이터에 바로 임의 접근할 수 있습니다. 또한, Index에 실제 데이터를 그대로 복사하여 저장하여 Clustered Index처럼 동작하도록 하거나, Reference만 저장하여 Non-Clustered Index와 같이 동작하게 할 수도 있습니다. Datastore 라이브러리에는 특정 데이터가 추가, 삭제, 수정할 때 특정 코드를 실행할 수 있도록 Trigger 기능이 구현되어 있는데, 이를 통해 Index를 업데이트합니다. 데이터의 변경하는 연산과 Index를 업데이트하는 연산이 하나의 Haeinsa 트랜잭션을 통해 원자적으로 일어나므로 데이터의 무결성이 보장됩니다.못다 한 이야기각 테이블의 특정 Row의 Column들에 대한 Column Qualifier외에도 Row에 대한 Row Key를 정의 해야 합니다. 비트윈에서는 각 Row가 표현하는 Root객체에 대한 아이디를 그대로 Row Key로 이용합니다. 새로운 Root객체가 추가될 때 발급되는 아이디는 랜덤하게 생성하여 객체가 여러 Region 서버에 잘 분산될 수 있도록 하였습니다. 만약 Row Key를 연속하게 발급한다면 특정 Region 서버로 연산이 몰리게 되어 성능 확장에 어려움이 생길 수 있습니다.데이터를 저장할 때 Thrift를 이용하고 있는데, Thrift 때문에 생기는 문제가 있습니다. 비트윈에서 서버를 업데이트할 때 서비스 중지 시간을 최소화하기 위해 롤링 업데이트를 합니다. Thrift 객체에 새로운 필드가 생기는 경우, 롤링 업데이트 중간에는 일부 서버에만 새로운 Thift가 적용되어 있을 수 있습니다. 업데이트된 서버가 새로운 필드에 값을 넣어 저장했는데, 아직 업데이트가 안 된 서버가 이 데이터를 읽은 후 데이터를 다시 저장한다면 새로운 필드에 저장된 값이 사라지게 됩니다. Google Protocol Buffer의 경우, 다시 직렬화 할 때 정의되지 않은 필드도 처리해주기 때문에 문제가 없지만, Thrift의 경우에는 그렇지 않습니다. 비트윈에서는 새로운 Thrift를 적용한 과거 버전의 서버를 먼저 배포한 후, 업데이트된 서버를 다시 롤링 업데이트를 하는 식으로 이 문제를 해결하고 있습니다.
조회수 2249

비트윈의 스티커 시스템 구현 이야기 - VCNC Engineering Blog

 비트윈에는 커플들이 서로에게 감정을 더욱 잘 표현할 수 있도록 스티커를 전송할 수 있는 기능이 있습니다. 이를 위해 스티커 스토어에서 다양한 종류의 스티커를 제공하고 있으며 사용자들은 구매한 스티커를 메시지의 첨부파일 형태로 전송을 할 수 있습니다. 저희가 스티커 시스템을 구현하면서 맞딱드린 문제와 이를 해결한 방법, 그리고 프로젝트를 진행하면서 배운 것들에 대해 소개해 보고자 합니다.스티커 시스템 아키텍처비트윈에서 스티커 기능을 제공하기 위해 다양한 구성 요소들이 있습니다. 전체적인 구성은 다음과 같습니다.비트윈 서버: 이전에 소개드렸었던 비트윈의 서버입니다. 비트윈의 채팅, 사진, 기념일 공유 등 제품내의 핵심이 되는 기능을 위해 운영됩니다. 스티커 스토어에서 구매한 스티커는 비트윈 서버를 통해 상대방에게 전송할 수 있습니다.스티커 스토어 서버: 스티커를 구매할 수 있는 스토어를 서비스합니다. 스티커 스토어는 웹페이지로 작성되어 있고 아이폰, 안드로이드 클라이언트와 유기적으로 연동되어 구매 요청 등을 처리합니다. 처음에는 Python과 Flask를 이용하여 구현하려 하였으나 결국엔 서버 개발자들이 좀 더 익숙한 자바로 구현하기로 결정하였습니다. Jetty와 Jersey를 사용하였고, HTML을 랜더링하기 위한 템플릿 엔진으로는 Closure Template을 이용하였습니다. ORM으로는 Hibernate/JPA, 클라이언트와 웹페이지간 연동을 위해서 Cordova를 이용하였습니다. EC2에서 운영하고 있으며 데이터베이스로는 RDS에서 제공하는 MySQL을 사용합니다. 이미 존재하는 솔루션들을 잘 활용하여 최대한 빨리 개발 할 수 있도록 노력을 기울였습니다.스티커 다운로드 서버: 스티커는 비트윈에서 정의한 특수한 포맷의 파일 형태로 제공됩니다. 기본적으로 수 많은 사용자가 같은 스티커 파일을 다운로드 받습니다. 따라서 AWS에서 제공하는 CDN인 CloudFront을 이용하며, 실제 스티커 파일들은 S3에서 호스팅합니다. 그런데 스티커 파일들은 디바이스의 해상도(DPI)에 따라 최적화된 파일들을 내려줘야하는 이슈가 있었습니다. 이를 위해 CloudFront와 S3사이의 파일 전송에 GAE에서 운영중인 간단한 어플리케이션이 관여합니다. 이에 대해서는 뒷편에서 좀 더 자세히 설명하도록 하겠습니다.구현상 문제들과 해결 방법들적정 기술에 대해 고민하다스티커 스토어 서버를 처음 설계할때 Flask와 SQLAlchemy를 이용하여 구현하고자 하였습니다. 개발팀 내부적으로 웹서버를 만들때 앞으로 Python과 Flask를 이용해야겠다는 생각이 있었기 때문이며, 일반적으로 Java보다는 Python으로 짜는 것이 개발 효율이 더 좋다는 것은 잘 알려진 사실이기도 합니다. 하지만 Java에 익숙한 서버 개발자들이 Python의 일반적인 스타일에 익숙하지 않아 Python다운 코드를 짜기 어려웠고, 오히려 개발하는데 비용이 더 많이 들어갔습니다. 그래서 개발 중에 다시 웹 서버는 자바로 짜게 되었고, 여러가지 스크립트들만 Python으로 짜고 있습니다. 실제 개발에 있어서 적절한 기술의 선택은 실제 프로젝트에 참여하는 개발자들의 능력에 따라 달라져야한다는 것을 알게되었습니다.스티커 파일 용량과 변환 시간을 고려하다사용자는 스티커 스토어에서 여러개의 스티커가 하나로 묶인 스티커 묶음을 구매하게 됩니다. 구매 완료시 여러개의 스티커가 하나의 파일로 압축되어 있는 zip파일을 다운로드 받게 됩니다. zip파일내의 각 스티커 파일에는 스티커를 재생하기 위한 스티커의 이미지 프레임들과 메타데이터에 대한 정보들이 담겨 있습니다. 메타데이터는 Thrift를 이용하여 정의하였습니다.스티커 zip파일 안에는 여러개의 스티커 파일이 들어가 있으며, 스티커 파일은 다양한 정보를 포함합니다카카오톡의 스티커의 경우 애니메이션이 있는 것은 배경이 불투명하고 배경이 투명한 경우에는 애니메이션이 없습니다. 하지만 비트윈 스티커는 배경이 투명하고 고해상도의 애니메이션을 보여줄 수 있어야 했습니다. 배경이 투명한 여러 장의 고해상도 이미지를 움직이게 만드는 것은 비교적 어려운 점이 많습니다. 여러 프레임의 이미지들의 배경을 투명하게 하기 위해 PNG를 사용하면 JPEG에 비해 스티커 파일의 크기가 너무 커집니다. 파일 크기가 너무 커지면 당시 3G 환경에서 다운로드가 너무 오래 걸려 사용성이 크게 떨어지기 때문에 무작정 PNG를 사용할 수는 없었습니다. 이에 대한 해결책으로 투명 기능을 제공하면서도 파일 크기도 비교적 작은 WebP를 이용하였습니다. WebP는 구글이 공개한 이미지 포맷으로 화질 저하를 최소화 하면서도 이미지 파일 크기가 작다는 장점이 있습니다. 각 클라이언트에서 스티커를 다운 받을때는 WebP로 다운 받지만, 다운 받은 이후에는 이미지 로딩 속도를 위해 로컬에 PNG로 변환한 스티커 프레임들을 캐싱합니다.그런데 출시 된지 오래된 안드로이드나 iPhone 3Gs와 같이 CPU성능이 좋지 않은 단말에서 WebP 디코딩이 지나치게 오래 걸리는 문제가 있었습니다. 이런 단말들은 공통적으로 해상도가 낮은 디바이스였고, 이 경우에는 특별히 PNG로 스티커 파일을 만들어 내려줬습니다. 이미지의 해상도가 낮기 때문에 파일 크기가 크지 않았고, 다운로드 속도 문제가 없었기 때문입니다.좀 더 나은 주소 포맷을 위해 GAE를 활용하다기본적으로 스티커는 여러 사용자가 같은 스티커 파일을 다운받아 사용하기 때문에 CDN을 이용하여 배포하는 것이 좋습니다. CDN을 이용하면 스티커 파일이 전 세계 곳곳에 있는 엣지 서버에 캐싱되어 사용자들이 가장 최적의 경로로 파일을 다운로드 받을 수 있습니다. 그래서 AWS의 S3와 CloudFront를 사용하여 스티커 파일을 배포하려고 했습니다. 또한, 여러 해상도의 디바이스에서 최적의 스티커를 보여줘야 했습니다. 이 때문에 다양한 해상도로 만들어진 스티커 파일들을 S3에 올려야 했는데 클라이어트에서 스티커 파일을 다운로드시 주소 포맷을 어떻게 가져가야 할지가 어려웠습니다. S3에 올리는 경우 파일와 디렉터리 구조 형태로 저장되기 때문에 아래와 같은 방법으로 저장이 가능합니다.http://dl.sticker.vcnc.co.kr/[dpi_of_sticker]/[sticker_id].sticker하지만, 이렇게 주소를 가져가는 경우 클라이언트가 자신의 해상도에 맞는 적절한 스티커의 해상도를 계산하여 요청해야 합니다. 이것은 클라이언트에서 서버에서 제공하는 스티커 해상도 리스트를 알고 있어야 한다는 의미이며, 이러한 정보들은 최대한 클라이언트에 가려 놓는 것이 유지보수에 좋습니다. 클라이언트는 그냥 자신의 디스플레이 해상도를 전달하기만 하고, 서버에서 적절히 계산하여 알맞은 해상도의 스티커 파일을 내려주는 것이 가장 좋습니다. 이를 위해 스티커 다운로드 URL을 아래와 같은 형태로 디자인하고자 하였습니다.http://dl.sticker.vcnc.co.kr/[sticker_id].sticker?density=[dpi_of_device]하지만 S3와 CloudFront 조합으로만 위와 같은 URL 제공은 불가능하며 따로 다운로드 서버를 운영해야 합니다. 그렇다고 EC2에 따로 서버를 운영하는 것은 안정적인 서비스 운영을 위해 신경써야할 포인트들이 늘어나는 것이어서 부담이 너무 컸습니다. 그래서, 아래와 같이 GAE를 사용하기로 하였습니다.GAE는 구글에서 일종의 클라우드 서비스(PaaS)로 구글 인프라에서 웹 어플리케이션을 실행시켜 줍니다. GAE에 클라이언트에서 요청한 URL을 적절한 S3 URL로 변환해주는 어플리케이션을 만들어 올렸습니다. 일종의 Rewrite Engine 역할을 하는 것입니다. 서비스의 안정성은 GAE가 보장해주고, S3와 CloudFront의 안정성은 AWS에서 보장해주기 때문에 크게 신경쓰지 않아도 장애 없는 서비스 운영이 가능합니다. 또한 CloudFront에서 스티커 파일을 최대한 캐싱 하며 따라서 GAE를 통해 새로 요청을 하는 경우는 거의 없기 때문에 GAE 사용 비용은 거의 발생하지 않습니다. GAE에는 클라이언트에서 보내주는 해상도를 보고 적당한 해상도의 스티커 파일을 내려주는 아주 간단한 어플리케이션만 작성하면 되기 때문에 개발 비용도 거의 들지 않았습니다.토큰을 이용해 보안 문제를 해결하다실제 스티커를 구매한 사용자만 스티커를 사용할 수 있어야 합니다. 스티커 토큰을 이용해 실제 구매한 사용자만 스티커를 전송할 수 있도록 구현하였습니다. 사용자가 스티커 스토어에서 스티커를 구매하게 되면 각 스티커에 대한 토큰을 얻을 수 있습니다. 스티커 토큰은 다음과 같이 구성됩니다.토큰 버전, 스티커 아이디, 사용자 아이디, 유효기간, 서버의 서명서버의 서명은 앞의 네 가지 정보를 바탕으로 만들어지며 서버의 서명과 서명을 만드는 비밀키는 충분히 길어서 실제 비밀키를 알지 못하면 서명을 위조할 수 없습니다. 사용자가 자신이 가지고 있는 스티커 토큰과 그에 해당하는 스티커를 비트윈 서버로 보내게 되면, 비트윈 서버에서는 서명이 유효한지 아닌지를 검사합니다. 서명이 유효하다면 스티커를 전송이 성공하며, 만약 토큰이 유효하지 않다면 스티커의 전송을 허가하지 않습니다.못다 한 이야기비트윈 개발팀에게 스티커 기능은 개발하면서 우여곡절이 참 많았던 프로젝트 중에 하나 입니다. 여러 가지 시도를 하면서 실패도 많이 했었고 덕분에 배운 것도 참 많았습니다. 기술적으로 크게 틀리지 않다면, 빠른 개발을 위해서 가장 익숙한 것으로 개발하는 것이 가장 좋은 선택이라는 알게 되어 스티커 스토어를 Python 대신 Java로 구현하게 되었습니다. 현재 비트윈 개발팀에서 일부 웹사이트와 스크립트 작성 용도로 Python을 사용하고 있지만 Python을 잘하는 개발자가 있다면 다양한 프로젝트들를 Python으로 진행할 수 있다고 생각합니다. 팀내에 경험을 공유할 수 있는 사람이 있다면 피드백을 통해 좋은 코드를 빠른 시간안에 짤 수 있고 뛰어난 개발자는 언어와 상관없이 컴퓨터에 대한 깊이 있는 지식을 가지고 있을 것이기 때문입니다.네 그렇습니다. 결론은 Python 개발자를 모신다는 것입니다.
조회수 1160

Team Profile: Meet Jungkap

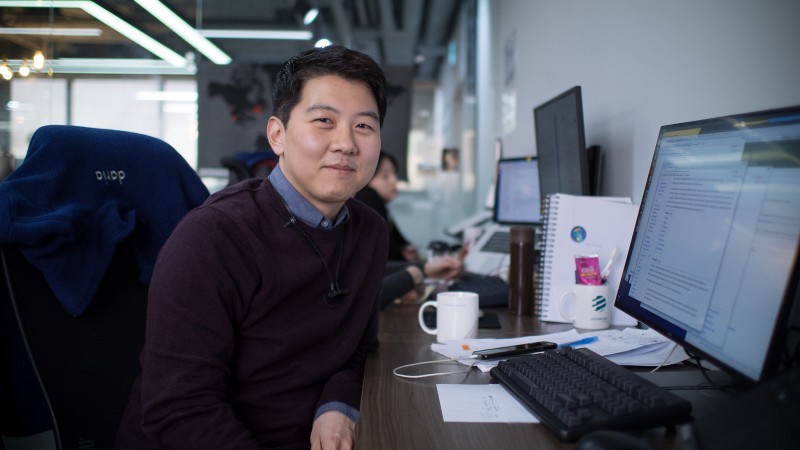
As a yet minuscule startup, each member holds a significant power over the overall atmosphere of the team. And in our ultimate quest to make big waves in the data world, we need to make sure that the people at the helm are at least kind of cool. We think we’ve done a pretty good job so far in assembling a society of unique but equally driven members.So we bring you this seven-part series, one of each devoted to interviewing each of our members in detail, to give you an in-depth glimpse into the people responsible for bringing you the future of machine learning with Daria. Plus, we peppered the interviews with questions from Dr. Aron’s “The 36 Questions that Lead to Love”*, cherry picked to make work appropriate and concise, but interesting.(*actually falling in love with our members highly discouraged)Jungkap, the most recent addition to our team, made the move from sunny Santa Clara to Seoul, a city that is slowly freezing over as you read this. But he is used to the cold, Jungkap assures us, having spent his doctorate years in the apocalyptic winters of Michigan. When he’s not busy helping build Daria’s machine learning engine, Jungkap devotes his time to re-exploring Korea and taking care of his cats Jolie and Brad (named so before the tragic dissolve of Brangelina). Learn more about him here!Tell us about your role at XBrain.JP: I joined the team as a machine learning engineer, and my main task is to develop our machine learning engine. I have the task of researching and finding solutions to obstacles that hinder people from using automated machine learning technology with ease.What does a typical work day look like for you, morning to evening?JP: I get to work at about 9:15 AM (*the earliest, we note, out of any of the members), and check the Slack messages and emails I got overnight. Since I concentrate the best in the morning, I take a look at relevant articles and dissertations then. Since I didn’t major in machine learning at school, there’s a lot I still have quite a bit to learn, learning’s still a big part of my work process. After I’ve warmed up a bit, I study the code that’s already been written, and develop the parts that need to be developed. Then I have lunch with the team, which is a part of our culture that I really enjoy — a set meal time and a chance to have a conversation with other members. Today I did investigation into an issue we had with the machine learning engine, and worked on how to solve that problem based on my discoveries. I think I’ll be working on constructing that idea into actuality, with a lot of validation, tests, trial and error.What are the parts of your job that you enjoy the most?JP:I enjoy enhancing and optimizing processes, and actually seeing improvement after I’ve worked on something. I’m working on improving the system that we have right now, but a long-term project we have in mind is developing technology of XBrain’s own, and figuring out the needs of our customers. In order to do that, I’m spending a lot of time looking into any issues that we have with our current technology, hoping to get insight from the process.What are the least enjoyable/most challenging parts of your job?JP:The most challenging, rather than the least enjoyable, is issue definition. There are four types of situations to what can happen: either I find a problem that’s already been found, or something that’s so insignificant that no one cares, something that’s unsolvable, and, finally, an issue that’s both important and solvable. The fourth is what we’re going after, and the process is long and arduous, but I do enjoy it to a certain extent.Pick one item on your desk that tells us something about you.JP:I don’t have much stuff on my desk, which is something I also noticed about some of the Silicon Valley companies I visited while I was working in the States, like Twitter or LinkedIn. Most engineers’ desks just had computers on them, and I appreciate that sort of simplicity.Jungkap keeps things on his desk simpleWhat made you go into machine learning?JP:I was on the user end of machine learning technology in grad school and at work thereafter, and felt that the process of utilizing and understanding tools was too complex and difficult. I thought that I might find it fulfilling to optimize this process myself by becoming a machine learning engineer myself.Why XBrain?JP:First off, I really liked how the team was set up, people-wise. I was also struck by the competency of the members and the company culture, which suited me well. The values that XBrain pursues, and the ideas that it had about the future of machine learning technology was in line with my own. Not to see it simply as a source of profit, but as something that could potentially bring a lot of people a great deal of help.As our most recent member, what’s a vision you have for our team?JP:It’s not so much a vision as a direction we should be heading in — despite how machine learning is such a huge buzzword now, I think it’s still in the process of research and development. A lot of work needs to be done before it can start having a real impact in the world. What our role is, then, is to look far ahead and start with the basics.Recommend a movie for our next Cinema Society, please.JP:Downsizing, which hasn’t come out in Korean theaters yet, but I think it presents a lot of points for discussion.If you could sum up XBrain in three words or less?Serious, but quirky.If you could have dinner with any XBrain member, who would it be and why?JP: JY — we haven’t really gotten a chance to share a meal, and I feel like he’d have some interesting storiesWhat can you tell us about the JP 10 years from now?JP:He will probably be a more seasoned machine learning engineer, from his 10 years of research and studying. I’m a novice engineer now, but I’d like to be in a more senior position then, mentoring younger engineers.Given the choice of anyone in the world, whom would you want as a dinner guest?JP:Carl Sagan, who first got me interested in science and technology. In my head, he’s this benevolent father figure who would offer to mentor me.Would you like to be famous? In what way?JP:No…What would constitute a “perfect” day for you?JP:I think a “perfect” day is a day that’s yet to come. Is that too weird to publish?If you were able to live to the age of 90 and retain either the mind or body of a 30-year-old for the last 60 years of your life, which would you want?JP:The body, definitely. Minds can mature — bodies not so much.For what in your life do you feel most grateful?JP:Probably soundness of mind and body.If you could wake up tomorrow having gained any one quality or ability, what would it be?JP:Speedier comprehension upon reading something?What is the greatest accomplishment of your life?JP: Forging strong relationships with good people.What, if anything, is too serious to be joked about?JP:It depends on the audience, I think. Anything that they might consider offensive, or a weak spot, is off limits.Your house, containing everything you own, catches fire. After saving your loved ones and pets, you have time to safely make a final dash to save any one item. What would it be? Why?JP: My hard drive — it has everything on it.#엑스브레인 #팀원소개 #팀원인터뷰 #기업문화 #조직문화 #팀원자랑 #머신러닝 #머신러닝엔지니어
조회수 1587

스타일쉐어에서 이미지 분류하기 (시작 편) feat.ML

안녕하세요.스타일쉐어에서 백엔드 개발을 하고 있는 김동현입니다.작년 11월 스타일쉐어에서 뷰티에 관련된 사진들을 따로 모아서 보여줄 피드.바로 뷰티피드 라는 것을 만들었습니다. 하지만 피드를 만드는 과정이 순탄치 만은 않았는데요.그간의 과정과 얻었던 경험들을 공유하고자 합니다.들어가기에 앞서혹시 설명을 하다 보면 스타일쉐어에서만 사용되는 단어가 있을 수 있다는 생각이 들어 단어에 대한 공유를 먼저 드리고자 합니다.스타일쉐어에서는 이를 “피드”라 칭합니다.스타일쉐어에서는 이를 “스타일”이라 칭합니다.여러 가지 카테고리 중에서 왜 뷰티인가요?기존의 서비스에서는 유저들이 올리는 스타일에 대한 카테고리가 없어서 유저들이 보고 싶어 하는 스타일들을 쏙쏙 뽑아서 보여줄 수 없는 상황이었지만 “내가 보고 싶은 것들만 볼 수 있었으면 좋겠다”라는 유저들의 니즈는 계속 올라가고 있었습니다.서비스 특성상 1020 유저들이 많이 있었고 하루 동안 올라오는 스타일에 대해서 사람이 직접 카테고리를 하나하나 나눠봤을 때 가장 활발하게 대화가 이루어지고 반응이 좋고 충성도도 높은 카테고리가 바로 뷰티였습니다.뷰티만이라도 따로 보여줄 수 있도록 해보자그럼 어떻게 뷰티에 관련된 게시물들을 뽑아낼 건가요?올라오는 스타일들 중에서 뷰티라는 속성을 찾아내어 분류하는 방법으로 두 가지의 제안이 나왔습니다.1. 사람이 직접 뽑아낸다.2. 요즘 뜨고 있는 딥러닝을 이용해서 뽑아낸다.처음엔 사람이 직접 모니터링 해볼까? 라는 이야기가 나왔었습니다.당장이라도 시작 할 수 있다는 점과 높은 정확도를 가졌다는 장점이 있기 때문이였죠.하지만 주말 관계없이 4000~6000개씩 올라오는 스타일들을 상시 모니터링하고 모두 검토해야 하는 상황이 너무 막막하게 느껴졌습니다. 관련 업무를 하시는 분의 업무 만족도는 낮을 것이 당연하기도 했지만 그럴만한 인적자원이 충분하지 않았습니다.그래서 요즘 뜨고 있는 딥러닝을 이용해보자는 방향으로 일이 진행되었습니다. 게다가 요즘 딥러닝으로 Image Classification 하는데에 있어서 정확도가 사람을 넘어섰다는 이야기도 결정에 한몫을 했답니다.딥러닝으로 분류하기로 결정했다! 근데 트레이닝 셋은?딥러닝을 하시는 분들이 애용하는 사이트인 캐글만 가보아도 문제와 트레이닝 셋이 잘 정리되어있기에 개발자는 어떻게 하면 잘 예측할 수 있을까에 대한 고민만 했으면 되었었습니다. 하지만 당연하게도 실제 필드에서 처리해야 하는 문제와 그에 대한 트레이닝 셋은 존재하지 않았습니다.우선 딥러닝으로 분류하기로 결정을 하였으니 서비스에서 뷰티라는 카테고리 안에 넣을 소카테고리를 나누었고 다음과 같았습니다.* 눈 화장 관련* 입술 화장 관련* 얼굴 화장 관련* 헤어* 화장품* 발색* 네일그래도 태양 아래 새로운 것은 없다 라는 말처럼 비슷한 것들이 존재할까 하고 찾아보았으나…https://www.kaggle.com/openfoodfacts/openbeautyfactshttp://www.antitza.com/makeup-datasets.htmlㅇ…없잖아?!그렇습니다. 공개된 것은 없던 새로운 것이었습니다. 위의 소카테고리들을 모으는 방법을 모색해야 했습니다.위에서 언급했듯이 잉여 인적자원이 없었기 때문에 몇만 개의 데이터를 모을만한 데이터를 모으는 일은 저를 포함해서 개발자 2명이서 진행을 했었습니다.그래서 결국 뷰티 피드는…성.공.적.다행히도 잘 마무리되었습니다. 화자 되고 있는 딥러닝 기술을 실제로 사용해볼 수 있어서 좋았고 팀원들도 이게 되는구나, 다른 것도 해볼 수 있겠다 라는 피드백을 많이 받았고 저 또한 개발을 하면서도 이게 된다고? 하는 반응이 제일 많았던 것 같습니다. 물론 앞으로 모델을 계속 개선해나가야겠지만요.사실 딥러닝을 거의 처음 공부하는 수준에 가까웠고 초반에 우왕좌왕 하기도 많이 했었는데 믿고 기다려줬던 스타일쉐어 팀원 분들 덕분에 잘 마무리될 수 있었던 것 같습니다.분류와 트레이닝 셋에 대한 좀 더 자세한 글은 다음 포스팅 (분류 편)에서 찾아뵙겠습니다.#스타일쉐어 #개발팀 #개발자 #개발후기 #경험공유 #인사이트
조회수 2433

블로그 운영 방법에서 엿보는 VCNC의 개발문화

VCNC에서 엔지니어링 블로그를 시작하고 벌써 새로운 해를 맞이하였습니다. 그동안 여러 글을 통해 VCNC 개발팀의 이야기를 들려드렸습니다. 이번에는 엔지니어링 블로그 자체를 주제로 글을 적어보고자 합니다. 저희는 워드프레스나 텀블러와 같은 일반적인 블로깅 도구나 서비스를 사용하지 않고 조금은 개발자스럽다고 할 수 있는 특이한 방법으로 엔지니어링 블로그를 운영하고 있습니다. 이 글에서는 VCNC 개발팀이 엔지니어링 블로그를 운영하기 위해 이용하는 방법들을 소개하고자 합니다. 그리고 블로그를 운영하기 위해 방법을 다루는 중간중간에 개발팀의 문화와 일하는 방식들에 대해서도 간략하게나마 이야기해보고자 합니다.블로그에 사용하는 기술들Jekyll: Jekyll은 블로그에 특화된 정적 사이트 생성기입니다. GitHub의 Co-founder 중 한 명인 Tom Preston-Werner가 만들었으며 Ruby로 작성되어 있습니다. Markdown을 이용하여 글을 작성하면 Liquid 템플릿 엔진을 통해 정적인 HTML 파일들을 만들어 줍니다. VCNC 엔지니어링 블로그는 워드프레스같은 블로깅 도구를 사용하지 않고 Jekyll을 사용하고 있습니다.Bootstrap: 블로그 테마는 트위터에서 만든 프론트엔드 프레임워크인 Bootstrap을 이용하여 직접 작성되었습니다. Bootstrap에서 제공하는 다양한 기능들을 가져다 써서 블로그를 쉽게 만들기 위해 이용하였습니다. 덕분에 큰 공을 들이지 않고도 Responsive Web Design을 적용할 수 있었습니다.S3: S3는 AWS에서 제공되는 클라우드 스토리지 서비스로서 높은 가용성을 보장합니다. 일반적으로 파일을 저장하는 데 사용되지만, 정적인 HTML을 업로드하여 사이트를 호스팅하는데 사용할 수도 있습니다. 아마존의 CTO인 Werner Vogels 또한 자신의 블로그를 S3에서 호스팅하고 있습니다. VCNC Engineering Blog도 Jekyll로 만들어진 HTML 파일들을 아마존의 S3에 업로드 하여 운영됩니다. 일단 S3에 올려두면 운영적인 부분에 대한 부담이 많이 사라지기 때문에 S3에 올리기로 하였습니다.CloudFront: 브라우저에서 웹페이지가 보이는 속도를 빠르게 하려고 아마존의 CDN서비스인 CloudFront를 이용합니다. CDN을 이용하면 HTML파일들이 전 세계 곳곳에 있는 Edge 서버에 캐싱 되어 방문자들이 가장 가까운 Edge를 통해 사이트를 로딩하도록 할 수 있습니다. 특히 CloudFront에 한국 Edge가 생긴 이후에는 한국에서의 응답속도가 매우 좋아졌습니다.s3cmd: s3cmd는 S3를 위한 커맨드 라인 도구입니다. 파일들을 업로드하거나 다운로드 받는 등 S3를 위해 다양한 명령어를 제공합니다. 저희는 블로그 글을 s3로 업로드하여 배포하기 위해 s3cmd를 사용합니다. 배포 스크립트를 실행하는 것만으로 s3업로드와 CloudFront invalidation이 자동으로 이루어지므로 배포 비용을 크게 줄일 수 있었습니다.htmlcompressor: 정적 파일들이나 블로그 글 페이지들을 s3에 배포할 때에는 whitespace 등을 제거하기 위해 htmlcompressor를 사용합니다. 또한 Google Closure Compiler를 이용하여 javascript의 길이도 줄이고 있습니다. 실제로 서버가 내려줘야 할 데이터의 크기가 줄어들게 되므로 로딩속도를 조금 더 빠르게 할 수 있습니다.블로그 관리 방법앞서 소개해 드린 기술들 외에도 블로그 글을 관리하기 위해 다소 독특한 방법을 사용합니다. 개발팀의 여러 팀원이 블로그에 올릴 주제를 결정하고 서로의 의견을 교환하기 위해 여러 가지 도구를 이용하는데 이를 소개하고자 합니다. 이 도구들은 개발팀이 일할 때에도 활용되고 있습니다.글감 관리를 위해 JIRA를 사용하다.JIRA는 Atlassian에서 만든 이슈 관리 및 프로젝트 관리 도구입니다. VCNC 개발팀에서는 비트윈과 관련된 다양한 프로젝트들의 이슈 관리를 위해 JIRA를 적극적으로 활용하고 있습니다. 제품에 대한 요구사항이 생기면 일단 백로그에 넣어 두고, 3주에 한 번씩 있는 스프린트 회의에서 요구사항에 대한 우선순위를 결정합니다. 그 후 개발자가 직접 개발 기간을 산정한 후에, 스프린트에 포함할지를 결정합니다. 이렇게 개발팀이 개발에 집중할 수 있는 환경을 가질 수 있도록 하며, 제품의 전체적인 방향성을 잃지 않고 모두가 같은 방향을 향해 달릴 수 있도록 하고 있습니다.VCNC 개발팀이 스프린트에 등록된 이슈를 얼마나 빨리 해결해 나가고 있는지 보여주는 JIRA의 차트.조금만 생각해보시면 어느 부분이 스프린트의 시작이고 어느 부분이 끝 부분인지 아실 수 있습니다.위와 같은 프로젝트 관리를 위한 일반적인 용도 외에도 엔지니어링 블로그 글 관리를 위해 JIRA를 사용하고 있습니다. JIRA에 엔지니어링 블로그 글감을 위한 프로젝트를 만들어 두고 블로그 글에 대한 아이디어가 생각나면 이슈로 등록할 수 있게 하고 있습니다. 누구나 글감 이슈를 등록할 수 있으며 필요한 경우에는 다른 사람에게 글감 이슈를 할당할 수도 있습니다. 일단 글감이 등록되면 엔지니어링 블로그에 쓰면 좋을지 어떤 내용이 포함되면 좋을지 댓글을 통해 토론하기도 합니다. 글을 작성하기 시작하면 해당 이슈를 진행 중으로 바꾸고, 리뷰 후, 글이 발행되면 이슈를 해결한 것으로 표시하는 식으로 JIRA를 이용합니다. 누구나 글감을 제안할 수 있게 하고, 이에 대해 팀원들과 토론을 하여 더 좋은 글을 쓸 수 있도록 돕기 위해 JIRA를 활용하고 있습니다.JIRA에 등록된 블로그 글 주제들 중 아직 쓰여지지 않은 것들을 보여주는 이슈들.아직 제안 단계인 것도 있지만, 많은 주제들이 블로그 글로 발행되길 기다리고 있습니다.글 리뷰를 위해 Pull-request를 이용하다.Stash는 Attlassian에서 만든 Git저장소 관리 도구입니다. GitHub Enterprise와 유사한 기능들을 제공합니다. Jekyll로 블로그를 운영하는 경우 이미지를 제외한 대부분 콘텐츠는 평문(Plain text)으로 관리 할 수 있게 됩니다. 따라서 VCNC 개발팀이 가장 자주 사용하는 도구 중 하나인 Git을 이용하면 별다른 시스템의 도움 없이도 모든 변경 내역과 누가 변경을 했는지 이력을 완벽하게 보존할 수 있습니다. 저희는 이런 이유로 Git을 이용하여 작성된 글에 대한 변경 이력을 관리하고 있습니다.또한 Stash에서는 GitHub와 같은 Pull request 기능을 제공합니다. Pull request는 자신이 작성한 코드를 다른 사람에게 리뷰하고 메인 브랜치에 머지해 달라고 요청할 수 있는 기능입니다. 저희는 Pull request를 활용하여 상호간 코드 리뷰를 하고 있습니다. 코드 리뷰를 통해 실수를 줄이고 개발자 간 의견 교환을 통해 더 좋은 코드를 작성하며 서로 간 코드에 대해 더 잘 이해하도록 노력하고 있습니다. 새로운 개발자가 코드를 상세히 모른다 해도 좀 더 적극적으로 코드를 짤 수 있고, 업무에 더 빨리 적응하는데에도 도움이 됩니다.어떤 블로그 글에 대해 리뷰를 하면서 코멘트로 의견을 교환하고 있습니다.코드 리뷰 또한 비슷한 방법을 통해 이루어지고 있습니다.업무상 코드 리뷰 뿐만 아니라 새로운 블로그 글을 리뷰하기 위해 Pull request를 활용하고 있습니다. 어떤 개발자가 글을 작성하기 위해서 가장 먼저 하는 것은 블로그를 관리하는 Git 리포지터리에서 새로운 브랜치를 따는 것입니다. 해당 브랜치에서 글을 작성하고 작성한 후에는 새로운 글 내용을 push한 후 master 브랜치로 Pull request를 날립니다. 이때 리뷰어로 등록된 사람과 그 외 개발자들은 내용에 대한 의견이나 첨삭을 댓글로 달 수 있습니다. 충분한 리뷰를 통해 발행이 확정된 글은 블로그 관리자에 의해 master 브랜치에 머지 되고 비로소 발행 준비가 끝납니다.스크립트를 통한 블로그 글 발행 자동화와 보안준비가 끝난 새로운 블로그 글을 발행하기 위해서는 일련의 작업이 필요합니다. Jekyll을 이용해 정적 파일들을 만든 후, htmlcompressor 통해 정적 파일들을 압축해야 합니다. 이렇게 압축된 정적 파일들을 S3에 업로드 하고, CloudFront에 Invalidation 요청을 날리고, 구글 웹 마스터 도구에 핑을 날립니다. 이런 과정들을 s3cmd와 Rakefile을 이용하여 스크립트를 실행하는 것만으로 자동으로 이루어지도록 하였습니다. VCNC 개발팀은 여러 가지 업무 들을 자동화시키기 위해 노력하고 있습니다.또한, s3에 사용하는 AWS Credential은 IAM을 이용하여 블로그를 호스팅하는 s3 버킷과 CloudFront에 대한 접근 권한만 있는 키를 발급하여 사용하고 있습니다. 비트윈은 특히 커플들이 사용하는 서비스라 보안에 민감합니다. 실제 비트윈을 개발하는데에도 보안에 많은 신경을 쓰고 있으며, 이런 점은 엔지니어링 블로그 운영하는데에도 묻어나오고 있습니다.맺음말VCNC 개발팀은 엔지니어링 블로그를 관리하고 운영하기 위해 다소 독특한 방법을 사용합니다. 이 방법은 개발팀이 일하는 방법과 문화에서 큰 영향을 받았습니다. JIRA를 통한 이슈 관리 및 스프린트, Pull request를 이용한 상호간 코드 리뷰 등은 이제 VCNC 개발팀의 문화에 녹아들어 가장 효율적으로 일할 수 있는 방법이 되었습니다. 개발팀을 꾸려나가면서 여러가지 시행 착오를 겪어 왔지만, 시행 착오에 대한 반성과 여러가지 개선 시도를 통해 계속해서 더 좋은 방법을 찾아나가며 지금과 같은 개발 문화가 만들어졌습니다. 그동안 그래 왔듯이 앞으로 더 많은 개선을 통해 꾸준히 좋은 방법을 찾아 나갈 것입니다.네 그렇습니다. 결론은 저희와 함께 고민하면서 더 좋은 개발문화를 만들어나갈 개발자를 구하고 있다는 것입니다.저희는 언제나 타다 및 비트윈 서비스를 함께 만들며 기술적인 문제를 함께 풀어나갈 능력있는 개발자를 모시고 있습니다. 언제든 부담없이 [email protected]로 이메일을 주시기 바랍니다!
조회수 1799

결전! CodeShip Pro vs Travis-CI

데일리의 Java 백엔드 개발자는 Docker 기반의 CodeShip Pro를 애용하는데 최근에 빌드가 급격히 느려지는 문제를 겪었다. 빌드가 느려진 원인은 다양하지만 그 중 일부는 CodeShip Pro의 캐싱 방식, 더 정확히는 도커의 캐싱 방식과 관련이 있다.CodeShip Pro는 pom.xml 또는 build.gradle 을 보고 빌드에 필요한 라이브러리를 미리 가져와서 캐싱하기를 권장한다.# We're using the official Maven 3 image from the Docker Hub (https://hub.docker.com/_/maven/). # Take a look at the available versions so you can specify the Java version you want to use. FROM maven:3 # INSTALL any further tools you need here so they are cached in the docker build WORKDIR /app # Copy the pom.xml into the image to install all dependencies COPY pom.xml ./ # Run install task so all necessary dependencies are downloaded and cached in # the Docker image. We're running through the whole process but disable # testing and make sure the command doesn't fail. RUN mvn install clean --fail-never -B -DfailIfNoTests=false # Copy the whole repository into the image COPY . ./예전에는 이 방식이 문제가 안 됐는데 최근 들어 캐시 적중률이 급격히 낮아졌다. 여러 애플리케이션이 공유하는 라이브러리를 몇 개 추가했는데 그 중 하나가 빈번히 업데이트되는 게 문제다. pom.xml 파일을 자주 수정하는데 그 말인즉 COPY pom.xml ./ 줄부터 다시 빌드해야 한다는 뜻이다. 그러므로 RUN mvn install clean --fail-never -B -DfailIfNoTests=false 을 실행하는 횟수가 많고 평균 빌드시간이 장난 아니게 늘어난다.CodeShip Pro에서 이 문제를 해결하는 방법은 비교적 간단하다. pom.xml 파일을 둘로 쪼개면 된다. 자주 수정하는 `pom.xml` 파일부터 빌드하면 빌드 시간을 종전처럼 끌어내릴 수 있다.COPY pom-not-frequently-changed.xml ./ RUN mvn -f=pom-not-frequently-changed.xml install clean --fail-never -B -DfailIfNoTests=falseCOPY pom.xml ./ RUN mvn install clean --fail-never -B -DfailIfNoTests=false하지만 CodeShip Pro가 이와 유사한 문제로 여러 번 문제가 된 터라 Travis-CI로 옮기면 어떤 장단점이 있는지 확인해보았다.장점Travis-CI는 커밋과 푸시를 한 해당 브랜치 뿐 아니라 머징할 브랜치 등에서도 빌드를 돌린다.CodeShip보다 캐싱 정책을 수립하기 쉽다.캐시 적중률 문제가 덜하므로 빌드 시간이 좀더 안정적으로 유지된다.현재 머신 사양으로는 약 1분 가량 빌드가 빠르다.빌드 과정을 한 눈에 이해하기 쉽다.Cron 빌드를 지원한다. 시간이 지나면서 의존성 문제 등으로 빌드가 깨졌을 때 조기에 조치할 수 있다.단점Travis-CI는 로컬에서 CI 환경과 동일한 빌드환경을 제공하지 않는다..travis.yml 파일을 수정하고 테스트하려면 git push 를 반복해야 한다.테스트를 돌리는 리눅스 환경과 실제 서버가 작동하는 도커 리눅스 환경이 같지 않다.돈으로 더 좋은 머신을 도입할 수 없다.빌드 환경을 이전하기는 그리 어렵지 않다. 하지만 장단점이 명확하다 보니 어느 게 꼭 좋다 말하기 힘들다. 상황에 따라 결정하는 수밖에.#데일리 #데일리호텔 #개발 #개발자 #개발도구 #도입후기 #일지 #인사이트 #조언
조회수 2046

MobX + React 10분 튜토리얼

* 이 글은 MobX의 MobX and React 튜토리얼을 번역한 글입니다.** 오역 및 오탈자가 있을 수 있습니다. 발견하시면 제보해주세요!개요MobX은 간단하고 확장 가능하며 테스트를 거친 상태 관리 솔루션입니다. 이 튜토리얼은 10분 안에 MobX의 중요한 컨셉들을 모두 소개합니다. MobX는 독립적인 라이브러리지만 대부분의 사람들은 React와 함께 사용합니다. 그래서 이 튜토리얼은 MobX와 React의 조합에 중점을 두고 설명합니다.The core idea상태는 각 애플리케이션의 핵심입니다. 버그를 만드는 관리가 되지 않는 애플리케이션을 만드는 가장 빠른 방법은 주변의 로컬 변수들과 동기화 되지 않는 상태나 일관성 없는 상태를 만드는 것입니다. 그래서 많은 상태 관리 솔루션들이 상태를 변할 수 없게 만드는 식으로 상태를 수정할 수 있는 방법들을 제한하려고 합니다. 하지만 이 방법은 새로운 문제들을 생성합니다. 데이터를 표준화 해야 하고 참조 무결성이 보장되지 않으며 프로토타입과 같은 유용한 컨셉들을 활용하지 못하게 됩니다.MobX는 일관성 없는 상태를 만들 수 없도록 주요 문제를 해결하여 상태 관리를 간단하게 만들었습니다. 이를 위한 전략은 간단합니다. 애플리케이션 상태로부터 파생될 수 있는 모든 것들을 자동으로 파생되도록 하는 것입니다.개념적으로 MobX는 애플리케이션을 스프레드시트로 간주합니다.1. 가장 먼저 애플리케이션 상태가 있습니다. 애플리케이션의 모델을 채우는 객체, 배열, 원시, 참조의 그래프입니다. 이 값들은 애플리케이션의 "데이터 셀"입니다.2. 둘째로 파생 값이 있습니다. 기본적으로 애플리케이션으로부터 자동으로 계산될 수 있는 모든 값들입니다. 이 파생 값이나 계산된 값들은 완료되지 않은 todo들의 수와 같이 간단한 값부터 todo의 시각적 HTML 표현과 같은 복잡한 내용까지 다양합니다. 스프레드시트 용어로는 애플리케이션의 공식이나 차트가 있습니다.3. 리액션은 파생 값과 매우 비슷합니다. 주된 차이점은 값을 생성하지 않는 함수라는 점입니다. 대신 자동으로 특정 작업들을 수행시킵니다. 대체로 I/O와 관련된 작업입니다. 리액션은 적당할 때에 자동으로 DOM이 업데이트되거나 네트워크 요청을 하도록 만듭니다.4. 마지막으로 액션이 있습니다. 액션은 상태를 변경하는 모든 것들을 말합니다. MobX는 모든 사용자의 액션으로 발생하는 상태 변화들이 전부 자동으로 파생 값과 리액션으로 처리되도록 합니다. 동기화되고 결함이 없습니다.간단한 todo store이론은 충분합니다. 위의 내용을 유심히 읽는 것보다 실제 예시를 보는 것이이해하기 아마도 더 쉽습니다. 아주 간단한 ToDo store을 가지고 시작해봅시다. 아래의 모든 코드 블록들은 수정이 가능하므로 run code  버튼을 클릭하여 실행시킬 수 있습니다. 아래의 코드는  todo 목록이 포함된 매우 직관적인 TodoStore입니다. MobX는 아직 포함되지 않았습니다.우리는 todos 목록이 있는 todoStore 인스턴스를 이제 막 만들었습니다. 어떤 객체들로 todoStore을 채울 시간입니다. 변경 사항들을 보기 위해 각 변화 이후에 todoStore.report를 호출하고 로그를 남깁니다. 레포트는 의도적으로 항상 첫 번째 할 일만 출력합니다. 이 때문에 예시가 좀 인위적이지만 아래에서 볼 수 있듯이 MobX의 의존성 추적이 동적임을 잘 보여줍니다.결과:반응형으로 만들기지금까지 이 코드에서 특별한 것은 아무것도 없었습니다. 그러나 report를 명시적으로 호출할 필요가 없다면 어떨까요? 각 상태가 변할 때마다 report가 호출되길 원한다고 선언할 수 있습니까? 그러면 report에 영향을 줄 수도 있는 모든 코드에서 report를 호출해야 합니다. 최신의 report가 출력되기를 원하지만 그것을 모두 작성하고 싶지는 않습니다.운이 좋게도 이것은 MobX가 여러분을 위해 동작하는 것입니다. 자동으로 상태에 연관되어 있는 코드를 실행합니다. 그래서 report 함수는 스프레드시트의 차트와 같이 자동으로 업데이트 됩니다. 이를 위해 TodoStore를 관찰할 수 있어야 MobX가 모든 변경 사항들을 추적할 수 있습니다. 이를 수행하도록 클래스를 변경해봅시다.또한 completedTodosCount 속성은 자동으로 todo 목록에서 파생될 수 있습니다. @observable과 @computed 데코레이터를 사용하여 객체에서 관찰할 수 있는 속성들을 생성할 수 있습니다.이게 끝입니다! 시간에 따라 변할 수 있는 값들을 MobX에게 알려주기 위해 @observable를 표시했습니다. 계산은 상태로부터 파생될 수 있는 것들을 확인하기 위해 @computed를 사용하여 표시됩니다.pendingRequrests와 assignee 속성들은 지금까지 사용되지 않았지만 앞으로 이 튜토리얼에서 사용됩니다. 이 페이지의 모든 예시들을 짧게 만들기 위해 ES6와 JSX 그리고 데코레이터를 사용합니다. MobX의 모든 데코레이터들은 ES5 부분들을 가지고 있으니 걱정하지 마세요.생성자에 report를 출력하는 작은 함수를 만들고 autorun으로 감쌌습니다. Autorun은 한 번 동작되는 리액션을 만들고 함수 안에서 사용되는 관찰 가능한 모든 데이터들이 변경될 때마다 자동으로 다시 실행합니다. report는 관찰 가능한 todos 속성을 사용하기 때문에 적절할 때 레포트를 출력합니다. 이것은 다음 리스트에서 설명됩니다. 실행 버튼을 눌러보세요:report은 자동으로 동시에 중간 값을 빼먹지 않고 출력하였습니다. 유심히 로그를 보면 새로운 로그에서는 4번째 줄이 없는 것을 발견할 수 있습니다. 뒤의 데이터가 변경되는 것으로 report가 실제로 변경되지 않기 때문입니다. 반면에 첫 번째 할일의 이름이 바뀐 것은 report에서 실제로 사용되는 이름이기 때문에 report를 업데이트 하였습니다. 이것은 todos 배열이 autorun에 의해 관찰되는 것이 아니라 todo 아이템들 안에 있는 개별적인 속성을 관찰하고 있다는 것을 잘 설명해줍니다.반응형 React 만들기지금까지 바보 같은 report를 반응형으로 만들었습니다. 이제 이 store에서 반응형 유저 인터페이스를 만들 시간입니다. React 컴포넌트들은 이름값을 못하고 반응형이 아닙니다. mobx-react 패키지의 @observer 데코레이터는 React 컴포넌트 render 함수를 autorun으로 감싸 자동으로 상태에 따라 컴포넌트가 동기되도록 만듭니다. 개념적으로 이전에 report를 가지고 했던 것과 다르지 않습니다.다음 코드는 몇 개의 React 컴포넌트를 정의합니다. 이 안의 MobX는 @observer 데코레이터 뿐입니다. 이것으로 충분히 데이터가 변경될 때 각 컴포넌트가 개별적으로 다시 렌더링하도록 만들 수 있습니다. 더이상 setState를 호출할 필요가 없으며 설정이 필요한 셀렉터나 상위 컴포넌트를 사용하는 상태의 적절한 부분을 찾을 필요도 없습니다. 기본적으로 모든 컴포넌트들은 더 똑똑해졌지만 아직 부족합니다.아래의 코드를 보기 위해 run code 버튼을 클릭하세요. 코드는 수정이 가능하므로 자유롭게 동작시킬 수 있습니다. 예를 들어 @observer 호출을 모두 지우거나 TodoView의 데코레이터만 지워보세요. 오른쪽의 미리보기에서 숫자들은 컴포넌트가 렌더링될 때마다 표시합니다. 다음 코드는 다른 작업을 수행하지 않고 데이터를 변경해야 한다는 것을 잘 보여줍니다. MobX는 자동으로 store의 상태에 따라 유저 인터페이스의 적절한 부분들을 다시 파생하고 업데이트합니다.참조 사용하기 지금까지 관찰가능한 객체(프로토타입과 일반 객체 둘 다)와 배열, 원시를 만들었습니다. MobX에서 참고를 다루는 방법에 대해 궁금하지 않나요? 상태가 그래프를 형성할 수 있나요? 이전 코드에서는 todos의 assignee 속성이 있는 것을 알았을 것입니다. 또 다른 "store"을 생성하여 assignee에 포함되는 사람들의 값을 전달하고 그들에게 할일이 할당해줍시다.두 개의 독립적인 store이 있습니다. 하나는 사람들이 있고 하나는 할 일들이 있습니다. 사람 store의 사람을 assignee에 할당하기 위해 참조를 할당했습니다. 변경사항들은 TodoView에 의해 자동으로 선택됩니다. MobX를 사용하면 데이터를 표준화할 필요가 없고 업데이트될 컴포넌트들을 지정하기 위해 셀렉터를 작성할 필요가 없습니다. 실제로 데이터가 어디에 저장되는지는 중요하지 않습니다. 오랫동안 객체들은 관찰가능하게 만들어졌고 MobX는 그것들을 추적할 수 있습니다. 실제 JavaScript 참조가 동작합니다. MobX는 파생과 관련이 있으면 자동으로 그것들을 추적합니다. 테스트 해보기위해 다음의 인풋 박스에 이름을 변경해보세요. (먼저 위의 Run code 버튼을 클릭했는지 확인해보세요)위의 인풋 박스의 HTML은 간단합니다:비동기 액션작은 Todo 애플리케이션에 있는 모든 것들은 상태로부터 파생되기 때문에 언제 상태가 변화하는지는 중요하지 않습니다. 비동기 액션을 만드는 것은 매우 수월합니다. 새로운 할일 아이템을 비동기적으로 로드하려면 아래의 버튼을 여러번 클릭하세요.코드는 매우 직관적입니다. UI가 현재 로딩되는 상태를 반영하도록 store의 pendingRequests 속성을 업데이트하는 것으로 시작합니다. 로딩이 끝날 때 store의 todos를 업데이트하고 pendingReqeust 카운터를 증가시킵니다. 이 스니펫을 이전 TodoList 정의와 비교하여 pendingRequests 속성이 어떻게 사용되는지 확인하세요.개발자 도구mobx-react-devtools 패키지는 화면의 오른쪽 최상단에서 찾을 수 있고 모든 Mobx+ReactJS 애플리케이션 내에서 사용할 수 있는 개발자 도구를 제공합니다. 첫 번째 버튼을 클릭하면 각 다시 렌더링되는 @observer 컴포넌트가 표시됩니다. 두 번째 버튼을 클릭하고 미리보기에서 해당 컴포넌트 중 하나를 클릭하면 해당 컴포넌트의 종속성 트리가 표시되므로 주어진 순간에 관찰중인 데이터 조각을 정확하게 검사할 수 있습니다.결론끝났습니다! 관용구는 없습니다. 완전한 UI를 형성하는 간단하고 선언적인 컴포넌트들입니다. 그리고 상태로부터 완전하고 반응형으로 파생됩니다. 여러분의 애플리케이션에서 mobx와 mobx-react를 사용하기 시작할 준비가 되었습니다. 지금까지 배운 것들을 짧게 요약하였습니다:1. MobX가 객체들을 관찰할 수 있도록 @observable 데코레이터 또는 observable(객체 혹은 배열)을 사용하세요.2. @computed 데코레이터는 상태로부터 자동으로 파생되는 함수를 만들기 위해 사용될 수 있습니다.3. 관찰 가능한 상태에 의존하는 함수들을 자동으로 실행하기 위해 autorun을 사용하세요. 로깅하거나 네트워크 요청하기에 유용합니다.4. React 컴포넌트를 진짜 반응형으로 만들기 위해 mobx-react 패키지의 @observer 데코레이터를 사용하세요. 자동으로 효율적으로 업데이트합니다. 심지어 많은 양의 데이터가 있는 아주 복잡한 애플리케이션에서도 사용됩니다.위의 수정 가능한 코드 블록을 사용하여 조금만 더 만져보면 MobX가 모든 변경 사항에 어떻게 반응하는지 기본적인 느낌을 얻을 수 있습니다. 예를 들어 언제 호출되는지 보기 위해 report 함수에 로그를 추가하거나 report를 출력하지 않고 이것이 TodoList 렌더링에 어떤 영향을 주는지 확인하세요. 아니면 특정 상황에서만 출력하세요...MobX는 상태 컨테이너가 아닙니다사람들은 종종 MobX를 Redux의 대안으로 사용합니다. MobX는 기술적인 문제를 해결하는 라이브러리일 뿐이며 아키텍처나 상태 컨테이너가 아닙니다. 그러한 의미에서 위의 예시들이 고안된 것으로 메서드에서 로직을 캡슐화하거나 store나 컨트롤러에서 구성하는 것과 같은 적절한 엔지니어링 기법을 사용하는 것이 좋습니다. 또는 HackerNesw의 누군가는 이렇게 말했습니다:"MobX는 많은 곳에서 언급되었지만 나는 마냥 좋다고 말할 수 없습니다. MobX로 작성하는 것은 컨트롤러/디스패처/액션/슈퍼바이저 또는 다른 형태의 데이터 흐름을 관리하여 애플리케이션의 요구 사항을 패턴화할 수 있습니다."#트레바리 #개발자 #안드로이드 #앱개발 #MobX #React #백엔드 #인사이트 #경험공유
조회수 5064

웹서버 로그 수집과 모니터링 설정

우리는 고객이 무엇에 관심 있어 하고 무엇에 관심 없어하는지, 어떤 것을 보았을 때 클릭해 들어가고 어떤 것을 보았을 때 사이트에서 이탈하는지 궁금해 합니다. 이러한 정보를 얻기 위해 봐야 할 것은 역시 웹서버의 접속 로그입니다.처음에는 매일 생성되는 로그 파일을 일일이 파싱해서 원하는 정보를 DB에 쌓는 방법을 이용했지만, 이러한 방식은 한계가 있었습니다. 저장할 수 있는 데이터의 양에 심각한 제한이 있었고, 따라서 처음에 얻고자 했던 데이터 이상의 것을 새로 추출할 수도 없었습니다.그래서 지금은 웹서버 로그를 하둡(Hadoop) 클러스터에 쌓고 있습니다. Google Analytics 같은 외부 분석툴을 사용하기도 하지만, 아무래도 데이터를 우리 손에 직접 들고 있는 것이 더 유연한 분석을 제공할 수 있지요. 클러스터에서 로그를 분석하려면 가장 먼저 로그 수집 시스템을 만들어야 합니다.이번 포스팅에서는 이 로그 수집 시스템이 어떻게 만들어져 있는지, 그리고 그보다 더 중요한 시스템의 모니터링을 어떻게 하고 있는지 설명하려고 합니다.Flume 에이전트 설정하기Apache FlumeApache Flume은 로그와 같은 데이터의 흐름(streaming)을 제어할 수 있게 해주는 도구입니다. 단순하면서도 확장성 높은 구조로 되어 있기 때문에 많은 시스템에서 채택하는 도구가 되었고, 리디북스에서도 Flume 을 사용하게 되었습니다.Flume 의 기본 구조는 단순합니다.기본적인 에이전트 구성 (이미지 출처: Apache Flume 홈페이지)에이전트(agent)는 Source, Channel, Sink 로 이루어진 자바 프로세스이다.소스(source)는 외부에서 이벤트를 입력받아 채널(channel)로 전달하고, 채널은 이벤트를 저장하고 있다가 싱크(sink)로 전달한다. 싱크는 이벤트를 외부로 출력한다.한 에이전트의 Sink와 다른 에이전트의 Source가 같은 타입이면, 에이전트 간에 이벤트를 전달할 수 있다.굉장히 간단하지만 강력한 모델입니다. Flume 은 Avro, Thrift, Exec, HDFS, Kafka 등 다양한 라이브러리를 적용한 소스와 싱크를 미리 제공하고 있기 때문에, 사용자는 자기 입맛에 맞게 이를 조합해서 시스템을 구성할 수 있습니다.예를 들면 아래와 같습니다.좀 더 복잡한 에이전트 구성 (이미지 출처: Apache Flume 홈페이지)초기 에이전트 구성: Avro를 통해 클러스터에 로그 전송저희가 맨 처음 설정한 Flume 에이전트의 구성은 다음과 같습니다.초기 에이전트 구성각 웹서버ExecSource: exec 명령으로 실행된 프로세스의 표준 출력을 이벤트로 입력받음. (tail -F <로그파일>)MemoryChannel: 메모리상의 큐(queue)로 구현된 채널AvroSink: 클러스터에 상의 에이전트가 실행하는 Avro RPC 서버로 이벤트를 전송하둡 클러스터AvroSource: 웹서버의 에이전트가 Avro RPC 로 보내는 이벤트를 수신MemoryChannelHDFSSink: HDFS 상의 지정된 경로의 파일에 이벤트 내용을 출력각 웹서버에는 에이전트가 하나씩 실행되어서, 로그 파일에 새로 추가되는 로그를 클러스터에 전송합니다. 클러스터 상의 에이전트는 단 한 개 존재하는데, 웹서버로부터 전송받은 로그를 HDFS(Hadoop File System) 에 파일로 출력하는 역할을 합니다. 웹서버 에이전트와 클러스터 에이전트 간의 통신은 Avro RPC 로 하게 하였습니다. Flume 에서 기본적으로 AvroSource 와 AvroSink 를 구현하여 제공해 주는 것을 이용했습니다.사실은 클러스터 상의 에이전트가 Avro 서비스를 통해 데이터를 모아 주지 않고, 웹서버 상의 에이전트가 HDFSSink 를 이용해서 직접 클러스터에 파일을 쓰게 하더라도 대부분의 경우는 상관없습니다. 하지만 리디북스의 경우는 그렇게 할 수 없었는데, 왜냐하면 웹서버와 하둡 클러스터가 서로 다른 네트워크 상에 있기 때문입니다.리디북스의 웹서버는 국내 IDC에 존재하지만 하둡 클러스터는 Miscrosoft Azure 클라우드 내의 가상머신으로 실행되고 있습니다. 따라서 하둡의 네임노드(namenode)가 인식하는 각 노드의 사설 IP 주소를 웹서버들이 쉽게 접근할 수 없습니다. 이를 우회하는 다양한 방법을 시도해 보았지만 최종적으로는 Avro 서비스를 중간에 두어 해결하였습니다.모니터링 알람 설정하기JSON 리포팅 사용다음은 에이전트 프로세스를 모니터링하는 문제가 있었습니다. 예기치 않은 에러로 에이전트가 종료되어서 로그가 수집되지 않고 있는데 며칠 동안 모르고 있어서는 안되겠지요.Flume 에서는 모니터링 인터페이스도 여러가지를 제공하고 있는데, 그 중 가장 이용하기 간편한 것은 HTTP 를 통한 JSON reporting 이었습니다. 에이전트 자체가 HTTP 서비스로 작동해서, 특정 포트로 요청을 보내면 에이전트의 상태를 JSON 으로 정리하여 응답을 주게 되어 있습니다. 에이전트 실행시에 옵션 몇 개만 추가하면 바로 설정할 수 있기 때문에 매우 간단합니다.Health 페이지를 이용한 모니터링그런데 이 리포팅이 제대로 나오지 않으면 어떻게 알림을 받을 수 있을까요? 각 서버마다 JSON 리포팅을 요청해서 응답이 제대로 오지 않으면 이메일을 보내는 스크립트를 만들어서 cron 으로 5분마다 실행하는 방법도 있습니다. 하지만 이 스크립트가 제대로 동작하지 않거나, 이게 실행되는 서버가 다운되면?결국 스스로를 믿지 못하고 택한 방법은 외부 서비스 Pingdom을 이용하는 것이었습니다. 단, 외부 서비스가 각각의 웹서버에 직접 접근하여 리포팅을 요청하는 방식은 보안상 문제가 될 수 있어서 아래와 같이 보완하였습니다.웹 서비스 상에 health 페이지 구현. 이 페이지는 각 웹서버의 에이전트의 JSON reporting 포트로 요청을 보내서, 결과를 종합해서 다시 JSON 으로 보여줌.모든 에이전트가 정상적으로 리포트를 보내면 {“status”: “OKAY”} 를, 아니면 {“status”: “ERROR”} 를 보여줌.이 health 페이지의 내용을 모니터링하도록 Pingdom 설정. {“status”: “OKAY”} 가 응답에 없으면 알람 메일이 오도록 함.{ "status": "OKAY", "metrics": { "192.168.0.101": { "SOURCE.log_src": { ... }, "SINK.avro_sink": { "BatchCompleteCount": 562110, "ConnectionFailedCount": 294, "EventDrainAttemptCount": 56246850, "ConnectionCreatedCount": 31, "Type": "SINK", "BatchEmptyCount": 16, "ConnectionClosedCount": 30, "EventDrainSuccessCount": 56243927, "StopTime": 0, "StartTime": 1459135471379, "BatchUnderflowCount": 610 }, "CHANNEL.mem_channel": { ... } }, "192.168.0.102": { ... } } }Health 페이지의 Json내용JSON 리포팅의 문제이렇게 설정해 놓고, 며칠간 로그가 HDFS 상에 잘 수집되는 것을 확인하고 만족해 했습니다. 그런데 며칠간 신경을 쓰지 않은 사이, 다시 에이전트를 확인해 보니 모든 웹서버 에이전트가 죽어 있었습니다. HDFS에 로그도 쌓이지 않았구요.확인해 보니, MemoryChannel 의 설정 문제였습니다. byteCapacity 값을 실수로 너무 작게 설정해서, 채널 큐가 메모리 부족으로 터져나간 것이죠. 해당 문제는 byteCapacity 값을 늘려서 간단하게 해결했습니다.문제는 알람이 오지 않았다는 것이었습니다. 문제를 재현해 본 결과, 채널이 터져서 에이전트 실행이 중단되어도, 에이전트 프로세스는 죽지 않고 ExecSource 에서 실행한 자식 프로세스(tail -F)만 죽어 있었습니다. 이렇게 되면 JSON 리포팅도 정상적으로 나오기 때문에, 결국 JSON 리포팅으로는 이런 유형의 에러를 잡지 못한다는 결론이 나왔습니다.클러스터에 모니터링 설정하기결국 웹서버상에서 모니터링하는것 보다는 데이터를 최종 전달받는 하둡 클러스터 상에서 모니터링하는 것이 안정적이라 판단하였습니다. 다행히도, 하둡 클러스터에서 사용할 수 있는 꽤나 좋은 모니터링 도구가 이미 있었습니다.CDH 의 알람 트리거리디북스에서는 기본 하둡 패키지가 아닌, Cloudera에서 제공하는 하둡 배포판인 Cloudera CDH를 사용하고 있습니다. CDH는 클러스터 상에서 사용되는 서비스마다 각종 테스트를 자동으로 실행하여, 테스트가 통과되지 않을 때마다 메일로 알람을 보내줍니다. 그리고 웬만한 필수 테스트는 기본적으로 설정되어 있지만, 사용자가 커스텀 서비스를 직접 제작할 수도 있습니다. CDH가 각 에이전트의 소스, 채널, 싱크마다 초당 전송한 이벤트 개수 등의 측정치(metric)을 모두 기록하고 있기 때문에, 이 값들이 일정 수준 이상/이하가 될 때마다 알람이 트리거되도록 설정할 수 있습니다.CDH의 알람 트리거 편집 화면웹서버마다 알람 설정하기그런데 이것으로 끝이 아닙니다. 클러스터 에이전트는 각 서버에서의 트래픽이 모두 모이는 곳이기 때문에, 여기에서 모니터링을 하는 것은 웹서버 상에서 모니터링하는 것보다 기준이 애매해집니다.10대의 웹서버 중에 한 대만 문제가 생겼을 경우, 클러스터 에이전트가 받는 트래픽은 0으로 줄어드는 것이 아니라 90%로 줄어듭니다. 알람을 트리거하는 역치(threshold)를 평소 트래픽의 90%로 잡아야 한다는 것이지요. 그런데 트래픽이라는 것이 원래 날짜와 시간에 따라 달라지기 때문에, 이 역치값을 고정된 값으로 정할 수가 없습니다. 트래픽이 높은 때를 기준으로 하면, 트래픽이 낮아지는 새벽 시간마다 가짜 알람(false alarm)이 오게 되겠지요. 그렇다고 트래픽이 낮은 때를 기준으로 하면, 트래픽이 높은 때 웹서버 에이전트가 죽더라도 새벽이 될 때까지 알 수 없습니다.결국 클러스터 단에서도 각 웹서버마다 트래픽을 구분해 주어야 한다는 결론이 나옵니다. 다행히 한 에이전트가 여러 개의 채널과 싱크를 가질 수 있고, 이벤트 헤더의 내용에 따라 소스가 어느 채널로 이벤트를 보낼지 결정해 주는 채널 셀렉터 (Channel Selector)라는 것이 있습니다.웹서버 에이전트의 소스에서는 각 이벤트 헤더에 자기 호스트명을 달아 준다. (Interceptor 는 각 이벤트에 원하는 헤더를 달아주는 역할을 한다. HostInterceptor 이용)클러스터 에이전트는 1개의 소스와, 웹서버 대수만큼의 채널 및 싱크가 있다.클러스터의 소스는 이벤트의 host 헤더를 보고 그에 해당하는 채널로 이벤트를 전달한다. (MultiplexingSelector 사용)각 채널은 자신에게 대응되는 싱크에 이벤트를 전달하고, 싱크는 각자의 HDFS 경로에 이벤트를 파일로 출력한다.최종 에이전트 구성: 채널 셀렉터로 트래픽 나누기최종적으로 나온 에이전트의 구성은 다음과 같습니다.최종 에이전트 구성그리고 에이전트 설정 파일은 아래와 같이 작성했습니다.... log_to_avro.sources.log_src.type = exec log_to_avro.sources.log_src.command = tail -F /path/to/log/file log_to_avro.sources.log_src.restart = true log_to_avro.sources.log_src.channels = mem_channel log_to_avro.sources.log_src.interceptors = ts_ic host_ic # 호스트 인터셉터 설정 log_to_avro.sources.log_src.interceptors.ts_ic.type = timestamp # 이벤트 헤더에 timestamp 삽입 (날짜별 구분을 위해) log_to_avro.sources.log_src.interceptors.host_ic.type = host # 이벤트 헤더에 호스트명 삽입 (호스트별 구분을 위해) log_to_avro.sources.log_src.interceptors.host_ic.useIP = true # 호스트명 대신에 IP 사용 log_to_avro.channels.mem_channel.type = memory log_to_avro.channels.mem_channel.capacity = 10000 log_to_avro.channels.mem_channel.transactionCapacity = 10000 log_to_avro.channels.mem_channel.byteCapacityBufferPercentage = 20 log_to_avro.channels.mem_channel.byteCapacity = 10485760 log_to_avro.sinks.avro_sink.type = avro log_to_avro.sinks.avro_sink.channel = mem_channel log_to_avro.sinks.avro_sink.hostname = hostname.of.cluster.agent log_to_avro.sinks.avro_sink.port = 4141 ...웹서버 에이전트 설정파일... avro_to_hdfs.sources.avro_src.type = avro avro_to_hdfs.sources.avro_src.bind = 0.0.0.0 avro_to_hdfs.sources.avro_src.port = 4141 avro_to_hdfs.sources.avro_src.channels = c_101 c_102 avro_to_hdfs.sources.avro_src.selector.type = multiplexing # Multiplexing Selector 설정 avro_to_hdfs.sources.avro_src.selector.header = host # 호스트 이름으로 채널 나누기 avro_to_hdfs.sources.avro_src.selector.mapping.192.168.0.101 = c_101 # 192.168.0.101 에서 온 이벤트는 c_101 채널로 avro_to_hdfs.sources.avro_src.selector.mapping.192.168.0.102 = c_102 # 192.168.0.102 에서 온 이벤트는 c_102 채널로 # 채널 c_101 설정 avro_to_hdfs.channels.c_101.type = memory avro_to_hdfs.channels.c_101.capacity = 10000 avro_to_hdfs.channels.c_101.transactionCapacity = 10000 avro_to_hdfs.channels.c_101.byteCapacityBufferPercentage = 20 avro_to_hdfs.channels.c_101.byteCapacity = 10485760 # 싱크 k_101 설정 avro_to_hdfs.sinks.k_101.type = hdfs avro_to_hdfs.sinks.k_101.channel = c_101 avro_to_hdfs.sinks.k_101.hdfs.fileSuffix = .log.gz avro_to_hdfs.sinks.k_101.hdfs.path = hdfs://namenode/path/to/logs/dir/%Y%m%d/%{host} # 날짜별, 호스트별로 다른 디렉토리에 avro_to_hdfs.sinks.k_101.hdfs.rollSize = 104857600 avro_to_hdfs.sinks.k_101.hdfs.rollInterval = 7200 avro_to_hdfs.sinks.k_101.hdfs.rollCount = 0 avro_to_hdfs.sinks.k_101.hdfs.fileType = CompressedStream avro_to_hdfs.sinks.k_101.hdfs.codeC = gzip # 채널 c_102 설정 avro_to_hdfs.channels.c_102.type = memory avro_to_hdfs.channels.c_102.capacity = 10000 avro_to_hdfs.channels.c_102.transactionCapacity = 10000 avro_to_hdfs.channels.c_102.byteCapacityBufferPercentage = 20 avro_to_hdfs.channels.c_102.byteCapacity = 10485760클러스터 에이전트 설정파일p.s. Flume 설정 파일은 변수 또는 외부 파일 include 등을 지원하지는 않아서, 위와 같이 반복되는 설정을 여러 번 써 주어야 합니다.호스트마다 CDH 알람 트리거 설정그리고 CDH 상에서도 웹서버 호스트의 개수만큼 알람 트리거를 만들어 줍니다. 초당 이벤트 개수가 0에 가깝게 떨어지면 알람이 오도록 해 주면 됩니다. 채널/싱크 중 어느 것을 기준으로 해도 크게 상관은 없는데, 저희는 싱크가 초당 이동완료한 이벤트 개수를 기준으로 했습니다.CDH에서의 알람 트리거 상태 화면이렇게 해 놓으면 또 한가지 좋은 점은, CDH가 알아서 차트를 그려 주기 때문에, 웹서버마다 트래픽 추이를 한눈에 볼 수 있다는 것입니다.HDFSSink의 초당 이벤트 개수 그래프맺음말지금까지 Apache Flume 과 CDH 를 사용해 로그 수집 시스템을 구성하고 모니터링을 설정한 후기를 살펴 보았습니다. 이 과정에서 느낀 점들을 한번 정리해 보겠습니다.첫째, 일견 간단해 보이는 기능이었지만 의외로 많은 시행착오를 거쳐야 했습니다. 아무리 간단해 보이더라도 각자의 상황에 맞추어 시스템을 설계하는 데에는 그에 맞는 고민을 거쳐야 합니다.둘째, 처음에는 로그가 일단 수집되게 하는 것이 가장 중요하다고 생각했는데, 실제로 겪어보니 모니터링이 훨씬 어렵고 중요한 문제라는 것을 알게 되었습니다. 어떤 기능이 일단 실행되도록 설정을 해 놓더라도, 그것이 매일 문제없이 실행됨을 보장받는 것은 또 다른 문제입니다.셋째, Health 페이지와 Pingdom을 이용한 웹서버 측의 모니터링은 JSON 리포팅의 문제 때문에 큰 쓸모가 없게 되었습니다. 하지만 꽤 유용한 테크닉이라는 생각이 들고, 어딘가에서는 비슷하게 이용할 수 있을 것 같습니다.마지막으로 CDH 쓰면 좋습니다. 많은 것들이 편해집니다.P.S. 리디북스 데이터팀에서는 이러한 로그 시스템을 함께 고민하고 만들어나갈 분들을 찾고 있습니다. 많은 관심 부탁드립니다.#리디북스 #개발 #서버 #서버개발 #모니터링 #로그 #Flume #CDH #로그수정 #인사이트

기업문화 엿볼 때, 더팀스

로그인

/