스토리 홈

인터뷰

피드

뉴스

조회수 5168

Gradle Dependency 분리하기

본 포스팅은 아래 코드를 보시면 좀 더 이해하기 쉽습니다.build.gradledependencies-variable.gradledependencies-classpath.gradledependencies-app.gradleGradle 의 역할Gradle 은 이제 안드로이드 개발에 있어서 그 중심이 되는 빌드 환경입니다. 안드로이드 빌드에 대한 기본 설정 뿐만 아니라 빌드에 필요한 Task 를 지정하거나 의존성을 추가할 수 있습니다.특히 의존성에서 일반적인 서비스들은 다양한 오픈소스를 활용하게 됩니다. 네트워크 라이브러리, 이미지 라이브러리, DI 라이브러리, Support 라이브러리,Play-Service 라이브러리 등등 이젠 프로젝트를 시작함에 있어서 기본적으로 10개 이상의 라이브러리를 추가하게 됩니다. 이러한 라이브러리들이 많아질수록 필연적으로 빌드 스크립트가 길어지게 됩니다. 이는 나중에 빌드에 관련된 코드를 추가/수정할 때 유지보수에 영향을 끼치게 됩니다.Gradle 의존성 분리하기토스랩에서는 꽤 많은 숫자의 라이브러릴 사용하고 있습니다. 테스트용 라이브러리들까지 포함해서 60여개의 라이브러리를 쓰고 있습니다. 이러한 라이브러리 코드들이 1개의 빌드 스크립트 안에 포함되어 진다면 라이브러리의 버전을 변경하거나 수정하는 작업을 할 때에는 불가피하게 시간이 소요될 수 밖에 없습니다.그에 따라 Gradle 에서 라이브러리들을 변수화 해서 분리하는 작업을 하였습니다.1. 라이브러리 변수화 하기ext { retrofit = 'com.squareup.retrofit2:retrofit:2.1.0' retrofit2_gson = 'com.squareup.retrofit2:converter-gson:2.1.0' retrofit2_rxjava2 = 'com.jakewharton.retrofit:retrofit2-rxjava2-adapter:2.1.0' } 가장 간단한 변수화였습니다. 하지만 Retrofit 은 관련 라이브러리들이 함께 수반되기 때문에 버전명을 다시 분리하였습니다.2. 라이브러리 버전 변수화 하기ext { retrofit_version = '2.1.0' retrofit = "com.squareup.retrofit2:retrofit:$retrofit_version" retrofit2_gson = "com.squareup.retrofit2:converter-gson:$retrofit_version" retrofit2_rxjava2 = "com.jakewharton.retrofit:retrofit2-rxjava2-adapter:$retrofit_version" } 하지만 버전명과 라이브러리이름이 함께 있는 것이 깔끔해보이진 않습니다. 그래서 아래와 같이 바꿨습니다.3. 라이브러리 이름과 버전의 분리ext { retrofit = '2.1.0' } ext.dependencies = [ retrofit2 : "com.squareup.retrofit2:retrofit:$ext.retrofit", retrofit2_gson : "com.squareup.retrofit2:converter-gson:$ext.retrofit", retrofit2_rxjava2 : "com.jakewharton.retrofit:retrofit2-rxjava2-adapter:$ext.retrofit_rxjava2", ] 실제에는 다음과 같이 사용하면 됩니다.dependencies { compile rootProject.ext.dependencies.retrofit2 compile rootProject.ext.dependencies.retrofit2_gson compile rootProject.ext.dependencies.retrofit2_rxjava2 } 이제 라이브러리를 변수화 해서 분리를 하였습니다.이제 변수로 지정한 라이브러리들은 build.gradle 파일안에 존재하게 됩니다.// build.gradle ext { retrofit = '2.1.0' } ext.dependencies = [ retrofit2 : "com.squareup.retrofit2:retrofit:$ext.retrofit", retrofit2_gson : "com.squareup.retrofit2:converter-gson:$ext.retrofit", retrofit2_rxjava2 : "com.jakewharton.retrofit:retrofit2-rxjava2-adapter:$ext.retrofit_rxjava2", ] buildscript { // blah blah } 라이브러리가 3개뿐이니 깔끔해보이는군요. 하지만 토스랩의 라이브러리는 60여개 입니다. 변수명도 60여개라는 말이죠. 그래서 라이브러리 변수들만 파일을 분리하기로 했습니다.4. 라이브러리 변수를 파일로 분리하기// dependencies-variable.gradle ext { retrofit = '2.1.0' } ext.dependencies = [ retrofit2 : "com.squareup.retrofit2:retrofit:$ext.retrofit", retrofit2_gson : "com.squareup.retrofit2:converter-gson:$ext.retrofit", retrofit2_rxjava2 : "com.jakewharton.retrofit:retrofit2-rxjava2-adapter:$ext.retrofit_rxjava2", ] // build.gradle apply from :'dependencies-variable.gradle' buildscript { // blah blah } 이제 좀 교통정리가 되어가는 기분이네요.하지만 app 의 build.gradle 을 보았습니다.// app 의 build.gradle apply plugin: 'com.android.application' dependencies { // 라이브러리 60개 compile rootProject.ext.dependencies.library.retrofit2 compile rootProject.ext.dependencies.library.retrofit2_gson compile rootProject.ext.dependencies.library.retrofit2_rxjava2 } android { // 중략 } 뭔가 잘못되어 가고 있습니다. 여전히 dependencies 가 큰 부분을 차지하고 있습니다.5. app.dependencies 분리하기이제 dependencies 를 분리할 차례입니다.// dependencies-app.gradle repositories { jcenter() } dependencies { compile fileTree(dir: 'libs', include: ['*.jar']) compile rootProject.ext.dependencies.library.retrofit2 compile rootProject.ext.dependencies.library.retrofit2_gson compile rootProject.ext.dependencies.library.retrofit2_rxjava2 compile rootProject.ext.dependencies.library.okhttp3 compile rootProject.ext.dependencies.library.okhttp3_logging compile rootProject.ext.dependencies.library.stetho_okhttp3 } // app 의 build.gradle apply from: 'dependencies-app.gradle' 이제 dependencies 와 관련된 스크립트가 분리되었습니다.하지만 저 apply from 이 항상 app 의 build.gradle 에 따라 붙어야 하는 것이 아쉽습니다. 그래서 buildscript 에 아예 추가하기로 하엿습니다.6. 빌드 스크립트에 dependencies 추가 동작하기먼저 빌드 스크립트용 스크립트를 만들겠습니다.// dependencies-classpath.gradle rootProject.buildscript.repositories { jcenter() } rootProject.buildscript.dependencies { classpath rootProject.ext.dependencies.classpath.android } 그리고 buildscript 가 시작될 때 모든 dependencies 스크립트가 인식할 수 있게 하겠습니다. 인식할 스크립트는 다음과 같습니다.dependencies-variable.gradle - 라이브러리 변수 저장dependencies-classpath.gradle - 빌드용 스크립트 저장dependencies-app.gradle - 라이브러리 추가 스크립트 저장rootProject 의 build.gradle 를 아래와 같이 변경합니다.// rootProject 의 build.gradle buildscript { apply from: "dependencies-variable.gradle" apply from: "dependencies-classpath.gradle" } apply from: 'dependencies-app.gradle' 위와 같이 변경을 하면 빌드스크립트가 동작하는 시점에 변수를 인식하고 빌드용 스크립트를 인식합니다.하지만 앱용 라이브러리 추가 스크립트는 아직 준비가 덜 되었습니다. “app” 프로젝트가 인식이 된 시점에 라이브러리가 추가되어야 하기때문에 처음 만들었던 스크립트로는 한계가 있습니다.그래서 아래와 같이 변경하겠습니다.// dependencies-app.gradle rootProject.allprojects { project -> if (project.name == 'app') { project.afterEvaluate { repositories { jcenter() } dependencies { compile fileTree(dir: 'libs', include: ['*.jar']) compile rootProject.ext.dependencies.library.retrofit2 compile rootProject.ext.dependencies.library.retrofit2_gson compile rootProject.ext.dependencies.library.retrofit2_rxjava2 } } } } afterEvaluate 는 프로젝트의 인식이 완료되면 동작이 되는 함수이기 때문에 모든 것이 끝나고 dependencies 가 추가되는 것으로 이해하시면 됩니다.정리위의 과정을 거침으로써 gradle 파일은 좀 더 나뉘었지만 app 의 build.gradle 은 안드로이드 프로젝트 그 자체에 집중 할 수 있도록 하였습니다.이렇게 나누었던 본래의 목적은 의존성 라이브러리와 코드 품질 관리용 스크립트가 1개의 스크립트 파일에 담겨지면서 관리하는 데 있어서 큰 문제가 발생하게 되었습니다. 그에 따라 각각을 나누고 그 목적에 맞도록 각가의 파일 만들었습니다.라이브러리의 변수용 파일buildscript 용 classpath 를 관리하는 파일본 프로젝트의 라이브러리 의존성 관리 파일참고 소스Github : https://github.com/ZeroBrain/DataBind-MVVM-Sample#토스랩 #잔디 #JANDI #개발 #개발후기 #인사이트
조회수 1277

레진 기술 블로그 - AWS Auto Scalinging Group 을 이용한 배포

레진코믹스의 서버 시스템은 잘 알려진대로 Google AppEngine에서 서비스되고 있지만, 이런저런 이유로 인해 최근에는 일부 컴포넌트가 Amazon Web Service에서 서비스되고 있습니다. AWS 에 새로운 시스템을 셋업하면서, 기존에 사용하던 PaaS인 GAE에서는 전혀 고민할 필요 없었던, 배포시스템에 대한 고민이 필요했습니다. 좋은 배포전략과 시스템은 안정적으로 서비스를 개발하고 운영하는데 있어서 필수적이죠.초기에는 Beanstalk을 이용한 운영에서, Fabric 을 이용한 배포 등의 시행착오 과정을 거쳤으나, 현재는 (스케일링을 위해 어차피 사용할 수밖에 없는) Auto Scaling Group을 이용해서 Blue-green deployment로 운영 중입니다. ASG는 여러 특징 덕분에 배포에도 유용하게 사용할 수 있습니다.ASG를 이용한 가장 간단한 배포는, Instance termination policy 를 응용할 수 있습니다. 기본적으로 ASG가 어떤 인스턴스를 종료할지는 AWS Documentation 에 정리되어 있으며, 추가적으로 다음과 같은 방식을 선택할 수 있습니다.OldestInstanceNewestInstanceOldestLaunchConfigurationClosestToNextInstanceHour여기서 주목할 건 OldestInstance 입니다. ASG가 항상 최신 버전의 어플리케이션으로 스케일아웃되게 구성되어 있다면, 단순히 인스턴스의 수를 두배로 늘린 뒤 Termination policy 를 OldestInstance 로 바꾸고 원래대로 돌리면 구버전 인스턴스들부터 종료되면서 배포가 끝납니다. 그러나 이 경우, 배포 직후 모니터링 과정에서 문제가 발생할 경우 기존의 인스턴스들이 이미 종료된 상태이기 때문에 롤백을 위해서는 (인스턴스를 다시 생성하면서) 배포를 다시 한번 해야 하는 반큼 빠른 롤백이 어렵습니다.Auto scaling lifecycle 을 이용하면, 이를 해결하기 위한 다른 방법도 있습니다. Lifecycle 은 다음과 같은 상태 변화를 가집니다.기본적으로,ASG의 인스턴스는 InService 상태로 진입하면서 (설정이 되어 있다면) ELB에 추가됩니다.ASG의 인스턴스는 InService 상태에서 빠져나오면서 (설정이 되어 있다면) ELB에서 제거됩니다.이를 이용하면, 다음과 같은 시나리오로 배포를 할 수 있습니다.똑같은 ASG 두 개를 구성(Group B / Group G)하고, 그 중 하나의 그룹으로만 서비스를 운영합니다.Group B가 라이브 중이면 Group G의 인스턴스는 0개입니다.새로운 버전을 배포한다면, Group G의 인스턴스 숫자를 Group B와 동일하게 맞춰줍니다.Group G가 InService로 들어가고 ELB healthy 상태가 되면, Group B의 인스턴스를 전부 Standby로 전환합니다.롤백이 필요하면 Standby 상태인 Group B를 InService 로 전환하고 Group G의 인스턴스를 종료하거나 Standby로 전환합니다.문제가 없다면 Standby 상태인 Group B의 인스턴스를 종료합니다.이제 훨씬 빠르고 안전하게 배포 및 롤백이 가능합니다. 물론 실제로는 생각보다 손이 많이 가는 관계로(특히 PaaS인 GAE에 비하면), 이를 한번에 해주는 스크립트를 작성해서 사용중입니다. 대략 간략하게는 다음과 같습니다. 실제 사용중인 스크립트에는 dry run 등의 잡다한 기능이 많이 들어가 있어서 걷어낸 pseudo code 입니다. 스크립트는 사내 PyPI 저장소를 통해 공유해서 사용 중입니다.def deploy(prefix, image_name, image_version): '''Deploy specified Docker image name and version into Auto Scaling Group''' asg_names = get_asg_names_from_tag(prefix, 'docker:image:name', image_name) groups = get_auto_scaling_groups(asg_names) # Find deployment target set future_set = set(map(lambda g: g['AutoScalingGroupName'].split('-')[-1], filter(lambda g: not g['DesiredCapacity'], groups))) if len(future_set) != 1: raise ValueError('Cannot specify target auto scaling group') future_set = next(iter(future_set)) if future_set == 'green': current_set = 'blue' elif future_set == 'blue': current_set = 'green' else: raise ValueError('Set name shoud be green or blue') # Deploy to future group future_groups = filter(lambda g: g['AutoScalingGroupName'].endswith(future_set), groups) for group in future_groups: asg_client.create_or_update_tags(Tags=[ { 'ResourceId': group['AutoScalingGroupName'], 'ResourceType': 'auto-scaling-group', 'PropagateAtLaunch': True, 'Key': 'docker:image:version', 'Value': image_version, } ]) # Set capacity, scaling policy, scheduled actions same as current group set_desired_capacity_from(current_set, group) move_scheduled_actions_from(current_set, group) move_scaling_policies(current_set, group) # Await ELB healthy of instances in group await_elb_healthy(future_groups) # Entering standby for current group for group in filter(lambda g: g['AutoScalingGroupName'].endswith(current_set), groups): asg_client.enter_standby( AutoScalingGroupName=group['AutoScalingGroupName'], InstanceIds=list(map(lambda i: i['InstanceId'], group['Instances'])), ShouldDecrementDesiredCapacity=True ) def rollback(prefix, image_name, image_version): '''Rollback standby Auto Scaling Group to service''' asg_names = get_asg_names_from_tag(prefix, 'docker:image:name', image_name) groups = get_auto_scaling_groups(asg_names) def filter_group_by_instance_state(groups, state): return filter( lambda g: len(filter(lambda i: i['LifecycleState'] == state, g['Instances'])) == g['DesiredCapacity'] and g['DesiredCapacity'], groups ) standby_groups = filter_group_by_instance_state(groups, 'Standby') inservice_groups = filter_group_by_instance_state(groups, 'InService') # Entering in-service for standby group for group in standby_groups: asg_client.exit_standby( AutoScalingGroupName=group['AutoScalingGroupName'], InstanceIds=list(map(lambda i: i['InstanceId'], group['Instances'])) ) # Await ELB healthy of instances in standby group await_elb_healthy(standby_groups) # Terminate instances to rollback for group in inservice_groups: asg_client.set_desired_capacity(AutoScalingGroupName=group['AutoScalingGroupName'], DesiredCapacity=0) current_set = group['AutoScalingGroupName'].split('-')[-1] move_scheduled_actions_from(current_set, group) move_scaling_policies(current_set, group) 몇 가지 더…Standby 로 돌리는 것 이외에 Detached 상태로 바꾸는 것도 방법입니다만, 인스턴스가 ASG에서 제거될 경우, 자신이 소속된 ASG를 알려주는 값인 aws:autoscaling:groupName 태그가 제거되므로 인스턴스나 ASG가 많아질 경우 번거롭습니다.cloud-init 를 어느 정도 최적화해두고 ELB healthcheck 를 좀 더 민감하게 설정하면, ELB 에 투입될 때까지 걸리는 시간을 상당히 줄일 수 있긴 하므로, 단일 ASG로 배포를 하더라도 롤백에 걸리는 시간을 줄일 수 있습니다. 저희는 scaleout 시작부터 ELB에서 healthy 로 찍힐 때까지 70초 가량 걸리는데, 그럼에도 불구하고 아래의 이유 때문에 현재의 방식으로 운영중입니다.같은 방식으로 단일 ASG로 배포를 할 수도 있지만, 배포중에 혹은 롤백 중에 scaleout이 돌면서 구버전 혹은 롤백 버전의 인스턴스가 투입되어버리면 매우 귀찮아집니다. 이를 방지하기 위해서라도 (Blue-green 방식의) ASG 두 개를 운영하는게 안전합니다.같은 이유로, 배포 대상의 버전을 S3나 github 등에 기록하는 대신 ASG의 태그에 버전을 써 두고 cloud-init 의 user-data에서 그 버전으로 어플리케이션을 띄우게 구성해 두었습니다. 이 경우 인스턴스의 태그만 확인해도 현재 어떤 버전이 서비스되고 있는지 확인할 수 있다는 장점도 있습니다.다만 ASG의 태그에 Tag on instance 를 체크해 두더라도, cloud-init 안에서 이를 조회하는 경우는 주의해야 합니다. ASG의 태그가 인스턴스로 복사되는 시점은 명확하지 않습니다. 스크립트 실행 중에 인스턴스에는 ASG의 태그가 있을 수도, 없을 수도 있습니다.굳이 인스턴스의 Lifecycle 을 Standby / InService 로 전환하지 않고도 ELB 를 두 개 운영하고 route 53 에서의 CNAME/ALIAS swap 도 방법이지만, DNS TTL은 아무리 짧아도 60초는 걸리고, JVM처럼 골치아픈 동작 사례도 있는만큼 선택하지 않았습니다.물론 이 방법이 최선은 절대 아니며(심지어 배포할때마다 돈이 들어갑니다!), 현재는 자원의 활용 등 다른 측면에서의 고민 때문에 새로운 구성을 고민하고 있습니다. 이건 언젠가 나중에 다시 공유하겠습니다. :)
조회수 911

[Buzzvil Culture] Strategy Talk for Engineer Hiring : How we hire engineers

 버즈빌에서는 전사 차원에서 고민하고 있는 회사의 현안과 전략적 방향성에 대해 모두와 함께 공유하고 의견을 나눈다는 취지 하에 한 달에 한 번 Strategy Talk을 진행하고 있습니다. Strategy Talk의 주제는 매 달의 화두와 고민에 맞게 진행되고 있는데요. 지난 번에 버즈빌 블로그를 통해 소개드렸던 Machine Learning(AI) 부터 프로덕트 로드맵, 시장 동향, 그리고 회사의 비전과 미션 등 다양한 주제로 진행되고 있습니다. 이번 달, Strategy Talk은 ‘버즈빌의 Engineer Hiring Strategy’ 라는 주제로 진행되었습니다. 이번 세션은 버즈빌의 Product side를 총괄하고 있는 Young의 주도하에 진행되었는데요. 세션을 통하여 왜 버즈빌이 더 많은 엔지니어가 필요한지에 대한 배경부터 어떤 방법들을 통해 채용을 해 나갈 것인지, 나아가 버즈빌이 어떤 모습으로 변해갈 것인지에 대한 내용을 공유하고 함께 논의하는 시간을 가졌습니다.새로운 개발자들을 대규모 채용하는 것이 어떤 의미가 있을까요? 기본적으로 새로운 사업을 만들어가며 공격적으로 성장하고 현재 리소스의 한계 때문에 진행하지 못하고 있는 기존 Product의 개선 작업들을 진행 하기 위해서는 당연히 충분한 개발자들이 합류하는 것이 필요합니다. 뿐만아니라 다양한 경험을 가진 더 많은 개발자를 채용하는 것은 ‘버즈빌의 개발문화’와도 큰 연관이 있습니다. 버즈빌은 좋은 개발문화를 가지고 있기로 유명합니다. 수평 / 자율 / 성장 삼박자가 고루 갖추어진 환경이라고 할 수 있는데요. 개발팀의 개발자들 모두가 동등한 Software Engineer로 일하고 있고 그만큼 개발 과정에서 의견 교환이 자유롭게 일어납니다. 누군가의 일방적인 지시가 아닌 모두가 최적이라고 합의할 수 있는 방향으로 개발을 진행해 나가고 있습니다. 뿐만아니라 개발 과정에서 각각의 엔지니어가 본인의 업무를 맡아 주도적으로 처리해 나가며 자신이 맡은 이슈에 대해 주인의식을 가지고 일하고 있습니다. 따라서 특정 개발 방향이 주어져서 틀에 박힌 개발을 해야한다거나 다른 사람의 눈치를 보면서 맞춰가는 개발을 해야하는 건 버즈빌의 개발문화와는 거리가 멀다고 할 수 있습니다. 그리고 개인의 성장을 위해 여러가지 지원을 하고 있는데요. 업무를 진행하는 과정중에 필요하다면 AWS의 다양한 서비스를 포함한 여러가지 툴들을 자유롭게 사용해 볼 수 있습니다. 외부에서 열리는 세미나 / 강연등에 참여하는 것을 독려하며 회사에서 관련비용을 지원하기도 합니다. 이러한 개발문화를 가지고 있기에 버즈빌은 개발자들이 자신의 역량을 100% 발휘할 수 있고 새로운 것들을 배워가며 성장해 나가기에는 최적의 조건을 가지고 있다고 할 수 있습니다. (버즈빌에 개발문화에 대한 보다 자세한 내용은 여기를 참고해 주세요!)이러한 버즈빌의 개발 문화를 유지하고 더 나아가 발전시켜 나가기 위해서도 다양한 경험을 가진 많은 엔지니어들이 합류하는 것이 긍정적인 영향을 미치리라 생각합니다. 지금도 내부적으로 개발자들이 돌아가면서 기술 관련 세미나를 진행하면서 서로의 노하우와 새로운 기술에 대한 논의들을 하고는 있지만 더 많은 개발자들이 합류 하면서 이런 기회 들을 더욱 확장해 나갈 수 있음은 물론 관심사가 맞는 개발자들 끼리 모여 관련 주제로 스터디 모임을 진행한다거나 새로운 사업모델 발굴을 위해서 버즈빌의 자원들을 활용하여 새로운 프로젝트들도 진행해 볼 수 있을 것입니다.
조회수 1903

네이버 신디케이션 — Rails

블로그에 새 글이 올라올 때, naver에 사이트 등록을 한다. 네이버 신디케이션 API를 이용하면 자동으로 등록된다.Wordpress에는 네이버 신디케이션 plugin이 존재한다. Rails gem을 찾아보니 애석하게도 없었다. 직접 만들면서 알게 되었다. 딱히 gem을 만들 만한 일도 아니더라.네이버 신디케이션을 이용하려면 우선 네이버 웹마스터 도구를 이용해야 한다. 해당 url이 자기 것이라는 인증과정만 거치면 바로 사용할 수 있다.작동방법은 대강 이렇다.네이버 신디케이션 API를 이용해서, 새로운 글이 생성되었음을 알린다. (혹은 글이 지워졌음을)네이버 크롤링 봇, Yeti가 와서 크롤링 해간다.API를 이용할 때 미리 약속된 format으로 만들어야 되는데, ATOM feed와 구조가 거의 같다. 다만 네이버가 정한 룰 때문에 (꼭 이름/저자/업데이트날짜 이런 순서를 지켜야 한다.)Rails에서 제공하는 atom_feed helper를 그대로 이용할 수 없다. 그러나 format만 살짝 바꾸면 되기 때문에 atom_feed helper를 이용해서, feed를 만드는 방법을 알려주는 Railscast가 늘 그렇듯 엄청 도움이 된다.(요즘 새로운 episode가 안올라오고 있는데… 힘내시라는 의미에서 예전에 유료결제 해드렸다)atom_feed helper의 코드를 그대로 가져와서 formating만 바꾼 naver_atom_feed helper를 만들었다. 별다른 건 없고, feed option 초기화 부분과 제일 마지막에 나와야 되는 link 부분을 주석처리한게 전부다.module NaverSyndicationHelper def naver_atom_feed(options = {}, █) ... feed_opts = {} //feed_opts = {"xml:lang" => options[:language] || "en-US", "xmlns" => 'http://www.w3.org/2005/Atom'} ... xml.feed(feed_opts) do xml.id... // xml.link... // xml.link... yield ActionView::Helpers::AtomFeedHelper::AtomFeedBuilder.new(xml, self, options) end end end새로만든 naver_atom_feed helper를 이용해서, feed부분만 완성한 code이다.naver_atom_feed({xmlns: "http://webmastertool.naver.com", id: 'http://ikeaapart.com'}) do |feed| feed.title "이케아아파트" feed.author do |autor| autor.name("이케아아파트") end feed.updated Link.maximum(:updated_at) feed.link(:rel => 'site', :href => (request.protocol + request.host_with_port), :title => '이케아아파트')이제 entry쪽을 만들어야 되는데, 네이버가 지정한 순서에 맞아야지만 신디케이션 서버에 전달할 수 있다. 정말 이상한 형식이다. 아무튼 그래서 Rails에서 제공하는 entry method를 사용하지 못한다. 이번엔 AtomFeedBuilder class에 naver_entry method를 만들었다.#config/initializers/feed_entry_extentions.rbmodule ActionView module Helpers module AtomFeedHelper class AtomFeedBuilder def naver_entry(record, options = {}) @xml.entry do @xml.id... # if options[:published]... # @xml.published(...) # end # if options[:updated]... # @xml.updated(...) # end # @xml.link(..) ...이번에도 순서 때문에 주석처리 한 것 밖에 없다. naver_entry method를 이용해서 완성된 코드가 아래 코드이다.# views/links/show.atom.buildernaver_atom_feed({xmlns: "http://webmastertool.naver.com", id: 'http://ikeaapart.com'}) do |feed| feed.title "이케아아파트" feed.author do |autor| autor.name("이케아아파트") end feed.updated Link.maximum(:updated_at) feed.link(:rel => 'site', ...) feed.naver_entry(@link, {id: link_url(@link)}) do |entry| entry.title(@link.title) entry.author do |author| author.name("이케아아파트") end entry.updated(@link.updated_at.xmlschema) entry.published(@link.created_at.xmlschema) entry.link(:rel => 'via', :href => (request.protocol + request.host_with_port)) entry.content(@link.contents) end end이제 새 글이 만들어 질 때, 이 atom 파일 주소를 네이버 신디케이션 API로 보내주면 된다. 참고로 Rails에서는 어떤 view파일을 사용할지 알아서 해주니, controller에 따로 ‘response_to’ 를 이용해서 format을 나눠줄 필요는 없고, 이름만 잘 맞춰주면 된다. (위 파일명은 show.atom.builder 이다)네이버 신디케이션 API에 핑을 보내는 code이다. 네이버가 지정해 놓은 header를 설정해 줘야 되고, 신디케이션 인증 토큰을 받아서 header에 넣어줘야 된다. 신디케이션 토큰은 네이버 웹마스터 페이지에서 볼 수 있다.require 'net/http' ... header = {"User-Agent"=>"request", "Host"=>"apis.naver.com", "Progma"=>"no-cache", "Content-type"=>"application/x-www-form-urlencoded", "Accept"=>"*/*", "Authorization"=>"Bearer " + ENV["NAVER_SYNDICATION_TOKEN"]} uri = URI.parse('https://apis.naver.com/crawl/nsyndi/v2') http = Net::HTTP.new(uri.host, uri.port) http.use_ssl = true args = {ping_url: link_url(link_id, format: "atom")} uri.query = URI.encode_www_form(args)request = Net::HTTP::Post.new(uri.request_uri, header) http.request(request)네이버 신디케이션 페이지에서 핑이 제대로 도달하는지 바로 확인해 볼 수 있다.#티엘엑스 #TLX #BA #BusinessAnalyst #비즈니스애널리스트 #꿀팁 #인사이트 #조언
조회수 1855

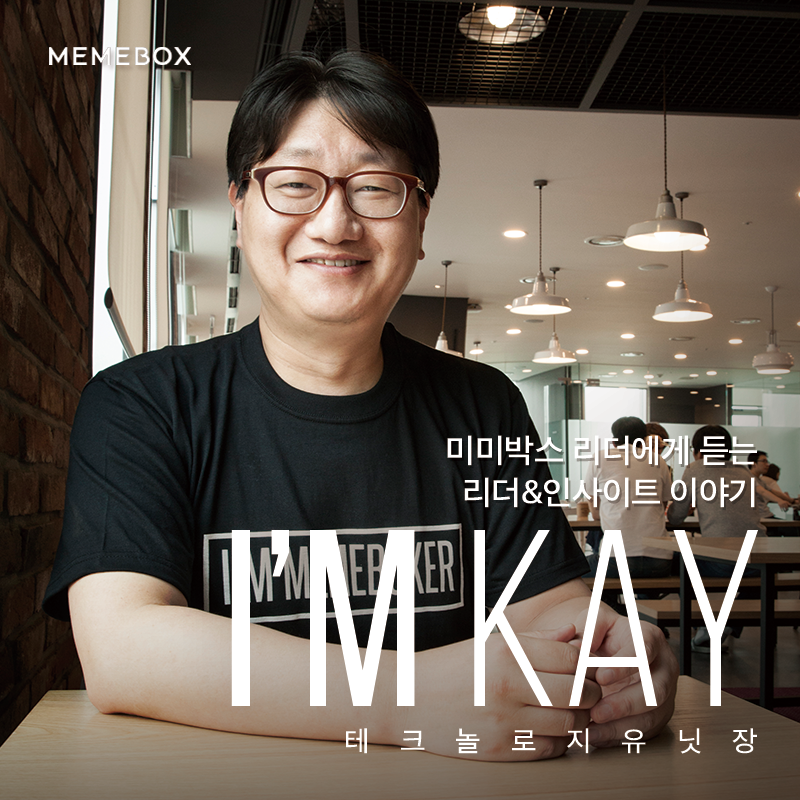
[인터뷰]미미박스의 TECHNOLOGY를 이끄는 CTO KAY를 만나다

안녕하세요. Ava입니다.여러분에게 더 건강하고, 아름다운 라이프스타일을 제공하기 위해 노력하는 미미박스 뒤에는여러분의 니즈를 만족시키고 안정된 서비스를 제공하기 위한 개발이끊임없이 진행되고 있습니다.오늘은 미미박스 TECHNOLOGY UNIT를이끌고 계신 김종광 CTO(이하 KAY) 님을 소개해드리겠습니다.KAY는 대기업과 IT기업에서 앱 개발과 웹 개발을 진행했던 커리어를 갖고 계신데요. 경력과 전문성 뿐만 아니라 개발자들이 상상할 수 있는 문화를 강조하며 만들어나가고 있습니다.항상 푸근한 아빠 미소로 미미박서의 질문과 제안을 받아주고,열린 리더의 모습을 보여주시는 KAY를 소개합니다.김종광 (Kay) 한국기술교육대학교 전기전자공학 석사전) NC소프트전) SK communicationsUNIT1. KAY를 소개해주세요.Q. 안녕하세요. 항상 아빠 미소를 짓고 계신 KAY~KAY를 소개해주세요.A. 처음에 미미박스에 모바일 앱 개발 총괄로 입사했어요. 지금은 개발 UNIT 전체를 맡고 있고요. 세 가지의 주 업무가 있는데요. 개발 전체 프로젝트를 leading 하고 다른 팀과 연관된 업무에 대해서 지원하는 일과, 새로운 개발자를 충원하는 업무를 하고 있습니다.Q. 미미박스에 입사하시게 된 계기는 무엇인가요? A. 처음에는 지인이 추천해서 미미박스를 알게 되었어요. 그 후에 미미박스에 대해 조사를 해봤죠. 비즈니스 모델, 성장 가능성을 봤을 때 '될 것 같다'는 생각을 가졌어요. 그리고 몇 번 찾아갔었는데 회사 분위기가 활기차고 재밌었어요. 그리고 일하는 사람들 중에 아는 사람들이 4~5명 정도 더 있었어요. 이분들과 다른 구성원들을 보면서 '이 친구들이랑 같이 일하면 즐겁게 일할 수 있겠다'라는 생각이 들었죠.Q. 여러 조직에서 있으셨던 만큼 개발 업무 자체에 대한 이유도 있을 것 같아요. A. 보통 기업에서는 개발자의 역할이 상당히 제한되어있어요. 업무에 대한 의사결정 권한이 거의 없죠. TOP-DOWN 방식으로 내려온 것들을 그냥 해야 하는 경우가 많거든요. 개발자들은 다들 알 거예요. 만들면서 '이거 안될 것 같다.'라는 감이 있는데, 느낌상으로 안될 것 같은 것을 만드니까 의욕이 생기지 않는 경우가 있었어요. 효과성보다는 어떤 서비스를 오픈했다는 것 자체가 실적이 되는 경우가 많거든요. Q. 그런 경우가 있군요. 그렇다면 미미박스 내에서는 개발 업무에 대해 어떤 식으로 의사결정이 이루어지나요?A. 업무에 대한 의사결정은 반반인 것 같아요. 우선 TECHNOLOGY UNIT 내부에서 프로젝트를 진행하는 것이 있어요. '이렇게 하면 회사와 서비스에 도움이 되겠다. 매출도 좋아질 것 같다. 사람들도 좋아할 것 같다'이런 의견을 내고 직접 만들 수 있고요. 서비스를 같이 진행하는 마케팅팀이나 플랫폼 운영팀에서 요청이 들어오면 그 요청에 대해 저희가 납득하고 하면 좋겠다고 생각하는 업무에 대해서 일정을 짜고 진행해요. 각 요소 별로 개발 측면의 논의도 많이 하고 실제 만드는 사람의 의견이 많이 반영됩니다. Q. 직접 만들고 구축하는 사람들의 의견은 정말 중요한 것 같아요.TECHNOLOGY UNIT을 이끌고 있는 UNIT 장님으로서 KAY의 하루 스케줄은 어떻게 되나요?A. 출근 후, 오전에는 집중 개발 업무를 하고 있어요. 제가 플랫폼 개발 팀장도 겸임하고 있거든요. 오후부터는 대부분 팀미팅이나 프로젝트 미팅을 많이 합니다. 프로젝트의 진행사항을 체크하고, 개발이 어려운 부분과 개발하면서 중요하게 생각하는 부분에 대해서 토론하죠. 그리고 새로운 개발 인력들 채용을 위해 면접을 많이 봅니다.Q. TECHNOLOGY UNIT 내부에서 소통과 역량 강화를 위해 주기적으로 여는 세션이 있다고 들었는데 소개해주세요!A. 일주일에 한 번씩 주니어 개발자를 대상으로 스터디를 진행하고 있습니다. 저는 스터디를 leading 하고 멘토 역할을 하고 있고요.이런 시간을 만들게 된 이유는 소통의 장을 만들고 개발자들의 역량을 키우기 위해서입니다.주니어 개발자들이 시니어 개발자들 앞에서 의견을 내는 것에 대해서 소극적인 면이 있어요. 틀릴까 봐 의견을 쉽게 못 내죠. 그래서 주니어 개발자들끼리 모여서 얘기할 공간을 만들어 주는 것이 중요하다고 생각했어요. 서로 의견을 내고 토론하면서 개발에 대한 역량도 쌓고 의견을 내는 훈련도 할 수 있죠.그리고 DATA UNIT의 협조를 받아서 빅데이터 관련 스터디를 진행하고 있어요. 그래서 개발자들 중 관심 있는 사람이들 모여서 빅데이터 관련 LOGIC을 만들어보고, 아이디어를 실현시켜보는 작은 프로젝트를 그룹별로 진행하고 있어요.앞으로는 이런 세션들을 발전시켜 세미나를 열 예정이에요. 그래서 각 개발자들이 적어도 1년에 2번 이상은 주제 발표할 수 있도록 환경을 만들려고 합니다. 개발 업무는 집중도가 높아서 건조해질 위험이 있어요. 집중하다 보면 일에 치여서 자기계발이 어려워질 수 있기 때문에 계속 자기계발하는 분위기를 만들어가려고 합니다. 전사적으로도 그런 분위기가 계속 만들어지면 좋겠어요.Q. 건조하긴요! 제가 보기엔 개발팀들이 가장 활발하고 참여도도 높은 것 같은데요! 열려있는 분들도 많고요.A. 개발팀이 아닌 팀들이랑 많이 소통하라고 조언을 많이 해요. 미미투게더(2개 이상 팀이 함께 회식하면 회식비를 지원해주는 기업문화 제도)를 할 때도 개발팀 내부에서만 하지 말고 무조건 다른 팀들과 함께하라고 하고 있어요. 새로운 아이디어를 나눌 수 있고 인간관계가 힘이 될 때가 많기 때문에 다른 팀들이랑 얘기를 많이 나누는 게 필요하죠. UNIT2. TECHNOLOGY UNIT을 소개해주세요.Q. TECHNOLOGY UNIT을 소개해주세요.A. TECHNOLOGY UNIT에서는 지금 미미박스에서 서비스하는 모든 PRODUCT, 플랫폼, 모바일 앱, PC 웹, 내부 직원들이 쓰는 모든 것들을 개발하고 있습니다. 대부분의 기업에서는 계약직이나 파견직의 고용형태로 진행하는 경우도 있는데, 저희는 모든 구성원이 정직원으로 개발 업무를 하고 있습니다.Q. TECHNOLOGY UNIT의 분위기는 어떤가요?A. 개발자라는 직무를 하는 사람들은 생각 자체가 자유로워야 합니다. 경직되어있으면 좋은 아이디어가 떠오르지 않죠. 그래서 TECHNOLOGY UNIT은 최소한의 규제나 룰을 두고 자유롭게 활동하게 하고 있어요. 특별한 일이 아니면 회의 소집도 지양하고 있어요.다양하게 상상하려면 경직되지 않고, 룰에 집착하지 않는 문화를 만들어야 하기 때문이에요. 그래야 본인의 의견도 편하게 이야기할 수 있죠. 구성원들을 보면 시니어 개발자들은 적응을 잘해요. 주니어 개발자들이 아직 조금 경직되어있긴 해요.지금 신입 공채 2기를 뽑고 있는데요. 보통은 스타트업에서 입사 후 바로 투입될 수 있는 사람을 뽑아요. 하지만 저는 확신이 있어서 저희 미미박스의 DNA를 가지고 처음부터 함께할 수 있는 신입을 뽑고 싶어요. 미미박스의 DNA를 가지고 더 성장하게 되면 저희 개발 조직에 기둥이 될 수 있을 거라고 생각합니다. <채용공고 보러 가기 클릭>Q. KAY와 함께 하는 구성원들이 점점 부러워지네요. 정말 구성원들의 성장에 많은 비중을 두고 여러 계획을 실천하는 것 같아요. 미미박스에는 여성 개발자도 점점 많아지는 것 같은데 재미있는 에피소드 있나요?A. 먼저 여성 개발자들의 비중이 점점 늘어나고 있어요. 우리가 여성 고객을 위한 서비스를 많이 하고 있잖아요. 그 감성을 같이 공유할 수 있는 사람이 많아지면 기술적인 부분뿐 아니라 감성적인 부분에서도 큰 시너지가 나죠. 실제로 웹페이지에 제품 가격이 잘못 올라간 적이 있어요. 저희 남성 개발자들이 그 데이터를 먼저 보는데 '이게 맞는 가격인가' 의심하는 사람이 아무도 없었어요. 그때 여성 개발자분이 '이 제품이 이 가격이 아닐 텐데? 문제를 제기했고 다행히 수정할 수 있었죠. Q. 그래도 남성 개발자들의 화장품 가격에 대한 감이 점점 정확해질 것 같아요. 호호KAY 님이 UNIT을 운영하시면서 가장 보람을 느끼신 적은 언제인가요?A. 고객들이 많이 와서 저희 서비스를 이용해 주실 때 보람을 느낍니다. 저희 UNIT 자체에서도 무언가를 만들어가고 있다는 것을 느끼고, 실제로 좋은 반응을 얻었을 때 기분이 정말 좋아요. Q. 점점 더 많은 분들이 미미박스를 찾아주신다는 게 느껴져요! 앞으로의 목표는 무엇인가요?A. 첫 번째는 글로벌로 플랫폼을 옮기는 것입니다. 저희 내부에서 개발한 플랫폼과 서비스가 점점 확대돼서 미미박스가 해외에 진출할 때마다 플랫폼을 그대로 이동시켜 글로벌화하는 것이 첫 번째 목표고요. 두 번째는 앞으로 온라인을 넘어 오프라인에 대한 서비스도 진행할 예정이에요. 현재 미미박스 플랫폼과 오프라인 요소의 연계성을 찾고 최고의 고객 경험을 만드는 것이죠. 일반적인 O2O 서비스를 넘어 대부분의 고객이 여성이기 때문에 IT 기술 자체가 숨어있고, 알아서 돌아가게 만드는 서비스를 만들 것입니다.미미박스는 뷰티에 대해서 많은 강점과 다양성을 가지고 있기 때문에 이런 것들을 통해 저희만 할 수 있는 서비스를 만들고 싶어요. 마지막은 Data-driven 방식을 더욱 견고히 가져가는 것이에요. 축적되어있는 경험과 데이터를 통해서 고객 맞춤형 서비스에 대한 역량을 강화하는 것이죠. Q. 글로벌 플랫폼, O2O 서비스, Data-driven 앞으로의 TECHNOLOGY UNIT이 만들어낼 것들이 기대돼요. 두근두근. 마지막으로 KAY가 TECHNOLOGY UNIT을 리드하면서 가장 집중하는 3가지가 무엇인지 궁금합니다. A. 가장 중요한 것은 우리 개발자들의 커리어를 관리해주는 것이에요. 이분들이 미미박스에 와서 자기의 역량이 발전하지 않고 정체되다면 제가 역할을 제대로 못했다는 뜻이거든요.그래서 구성원들이 고생을 하든 뭘 하든 해가 갈수록 성장할 수 있도록 관리하는 것에 집중하고 있어요. 두 번째는 우리가 TECH 조직이기 때문에 서비스가 아주 정상적으로 운영되는 것이 목표에요. 단순한 장애를 없애는 것뿐만 아니라 계속 플랫폼이 발전하면서 문제가 없게 만들어야 하죠. 매출, 데이터가 계속 쌓이면서 안정적인 서비스를 만드는 것, 기본적인 것 같지만 가장 중요한 것 같아요. 마지막으로는 Align이에요. 개발팀이 성장할 수 있는 서비스, 개발 역량을 강화시키다며 보면 회사의 목표에 Align 되는 것을 놓칠 수 있어요. 그렇기 때문에 개발자들이 관심 있는 것들과 회사의 목표를 Align시켜서 시너지 효과를 낼 수 있도록 집중하고 있습니다.UNIT2. TECHNOLOGY UNIT으로서 어떤 사람과 일하고 싶나요?Q. TECHNOLOGY UNIT에서 일하기 위하여 갖추어야 할 역량은 어떤 것이 있나요?A. 첫 번째로 성장 가능성을 봅니다. 성장 가능성에는 여러 가지 의미가 있지만 적극적이고, 새로운 지식에 대한 욕구가 항상 강한 사람이어야 합니다. 배우고 싶은 열망, 해보고 싶다는 열망을 가지고 실제 구체적으로 실행해본 경험이 있고, 뭔가를 해본 사람이 성장 가능성이 있는 사람이라고 생각합니다. 제가 면접을 볼 때마다 항상 물어보는 것이 '5년 후 계획, 5년 후 모습은 어떨 것 같아요?'에요. 면접자가 적극적으로 대답하면 '그것을 위해 어떤 실행계획이 있는지' 물어보죠.두 번째로는 스타트업 마인드 FIT이 맞는 것이에요. 저도 미미박스에 처음 왔을 때 힘들었어요. 갖춰져 있는 게 없었거든요. 하나부터 열까지 하려면 뭔가 어디서 걸리는 거예요. 큰 회사는 세팅이 다 되어있는데 말이죠. 그래서 뭔가를 하려면 그 업무뿐 아니라 처음부터 다 찾고 만들어야 해요. 이렇게 만들어가는 걸 좋아하는 사람이 있어요. 준비가 안되어있다고 불평하는 것이 아니라 부족한 환경에서 할 거리가 많은 것을 반기는 사람들. 이런 사람들은 '이것저것 해봐야지~' 신나있어요. 이런 마인드 FIT을 많이 봅니다.Q. 스타트업 마인드 FIT 정말 공간되는 말인 것 같아요. 저도 갖춰져있는 틀에서 무언가를 하는 것보다 이것저것 찾아서 만드는 걸 좋아하거든요! 그런 분들이 많이 오시면 재밌는 일이 많이 벌어질 것 같아요. 우리 미미박스의 비전은 'Beautify the people'인데요. 혹시 취업이나 이직을 준비하는 분들께 이것만은 아름답게 관리하라고 조언하고 싶은 게 있나요?A. 이력서와 경력기술서를 아름답게 해야 해요. 개발자들 중에 '내 역량만 좋으면 되지'라고 생각하시는 분들이 있는데 자신의 커리어 패스를 만드는 것도 중요하거든요. 회사에서 처음에 서류전형을 진행하는 게 많은 내용을 내포하고 있어요. 경력기술서의 내용이 부실하면 회사도 본인도 FIT이 맞는 곳을 찾기가 어려워지죠. 어디서든 인정받는 사람이 되려면 자신의 업무와 역할을 충실하게 표현한 경력기술서를 작성하라고 말씀드리고 싶네요.Q. 정말 실질적인 조언이네요. 누구보다 깊게 고민하고 집중한 일일수록 경력기술서와 이력서를 잘 쓸 수 있고 자신의 경력도 잘 전달할 수 있을 것 같아요.마지막으로 함께 일하고 있는 미미박서분들께도 한마디 해주세요!A. 제가 여기 처음 와서 한 이야기가 있어요. "여기가 제 마지막 회사입니다."그렇게 이야기한 이유는 미미박스의 성장 가능성, 발전 가능성을 보았고 믿음이 있기 때문이죠. 모두가 같이 노력한다면 원하는 것을 이룰 수 있을 거라 생각해요. 다 같이 파이팅!
조회수 669

오픈서베이가 구성원과 함께하는 방식, 병특 Z세대에게 묻다

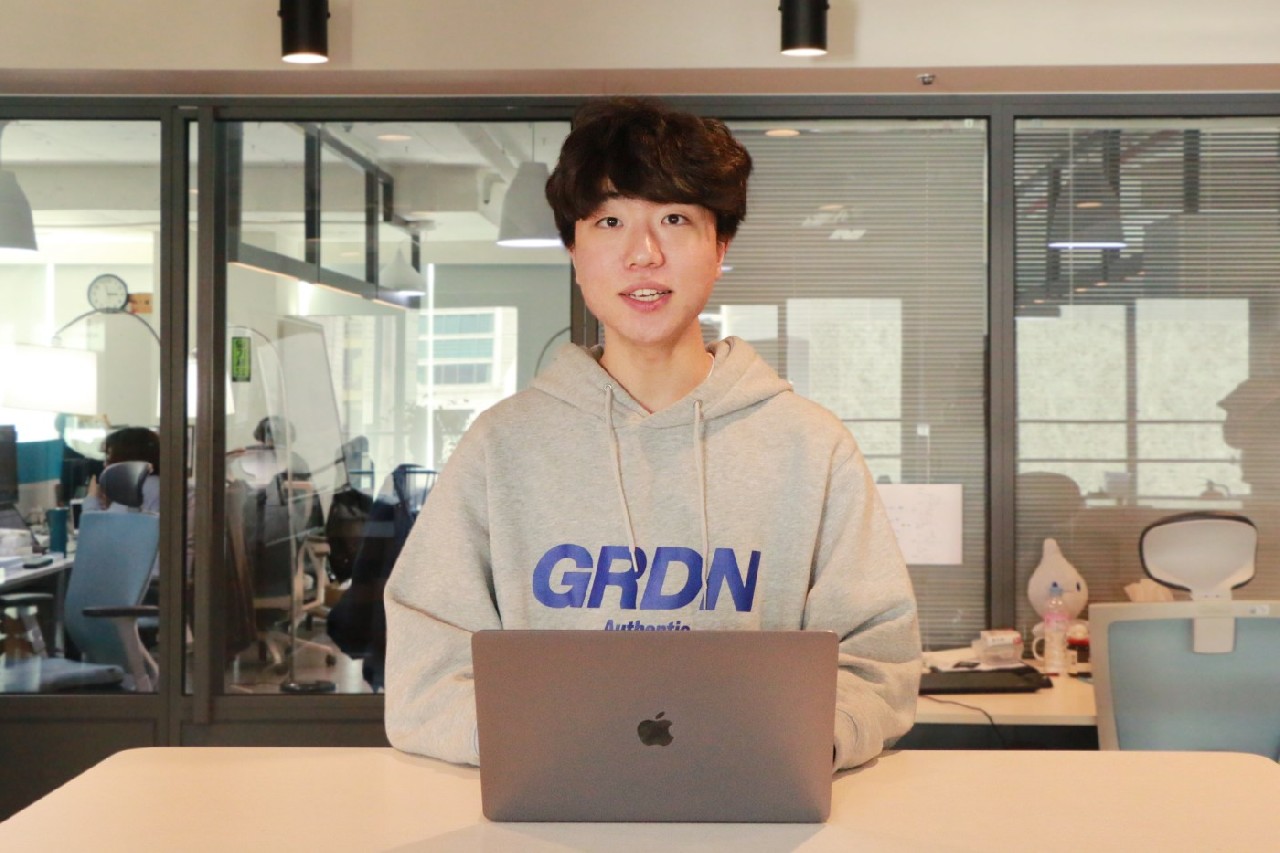
끊임없는 자기 계발과 성장 욕구는 Z세대의 특징이라고들 합니다. 약관 20세에 병역특례로 입사해 2년째 오픈서베이의 Z세대를 대표하는 김승엽 웹 프론트엔드 개발자(이하 레드)도 그렇습니다. ‘나이에 비해 잘한다’는 ‘아직 잘 못 한다’는 뜻이라며, 달콤한 퇴근 후 시간을 방통대 강의와 과제에 투자하고 있죠.  원동력이 무엇인지 물으니, 그도 얼마 전까지는 게으른 집고양이처럼 사는 게 꿈이었다고 합니다. 직원들을 진정으로 위하는 회사의 모습과 형·누나·아빠뻘의 구성원과 일하며 받은 좋은 자극 덕에 향상심이 자라났다고 하죠. Z세대의 마음을 울린 회사의 모습은 무엇일까요?       오픈서베이 김승엽(레드) 웹 프론트엔드 개발자   레드, 안녕하세요!  안녕하세요. 오픈서베이 웹 프론트엔드 개발을 담당하는 레드입니다. 오픈서베이 DIY 리뉴얼, 랜딩페이지 등 오픈서베이의 각종 웹페이지 개발을 맡고 있습니다. 오픈서베이에서 병역특례 복무 중이기도 하고요(웃음).   2년 전 스무살 나이로 입사했는데, 실은 오픈서베이도 2번째 회사라면서요. 맞아요. 고등학생 때 바로 취업을 했거든요. 특성화 고등학교에 다니면서 프로그래밍을 배웠어요. 배우다 보니 재미가 붙어서 친구들이랑 프로젝트도 해보고 교내 대회에도 나갔고요. 그때 대학교에 진학하기 보다는 빨리 취업해서 실무에서 배우고 성장하는 게 더 좋을 것 같다고 생각했던 것 같아요. 또 저희 학교 특성 상 졸업 전에 다양한 회사에서 구인 행사를 하러 와요. 전 그때 한 스타트업에서 병역특례 지원 해준다는 말만 듣고 멋모르고 첫 취업을 했어요. 아직 병특 지정 업체도 아니었는데, 입사만 하면 병특 업체 지원 해준다는 말만 믿고 순진했었죠.  그렇게 멋모르고 1년 정도 다녔더니 대표님이 병특 업체 선정 안 됐는데 더 신청한다고 될지 모르겠다고 하더라고요. 군대는 각자 일이니 스스로 해결 방법을 찾으라면서요. 그때 회사가 말하는 성장에 대한 비전이나 직원과의 약속이 현실성 없는 허황된 말이라고 생각했던 것 같아요. 그렇게 첫 회사에 실망해서 이직한 곳이 오픈서베이입니다.    첫 회사에서의 경험으로 이직 시 고려요소가 좀 달라졌나요? 조건이 까다로워졌다기보다는 회사에 바라는 게 줄었어요. 그냥 내가 다니는 동안 배울 게 있는 회사였으면 좋겠다는 생각만 있었어요. 병특 지원이 급했을 때라 더 그랬던 것도 같아요(웃음). 그런데 오픈서베이를 다니면서는 좋은 회사에 대한 생각이 또 조금씩 달라졌어요. 예전에는 천국 같은 회사에 대한 환상이 있었는데, 지금은 회사는 천국일 수 없다고 생각하는 편이거든요. 일을 하는 곳이 천국 같을 순 없으니까요.   그럼 정말 현실적으로 좋은 회사가 뭘까 생각해보게 되겠군요. 맞아요. 저는 열심히 살아야겠다는 생각이 들게 하는 회사가 좋은 회사라고 생각해요. 그런 면에서 오픈서베이는 정말 좋은 회사 같아요. 제가 계속 더 잘해야겠다는 자극을 받게 하거든요. 특히 함께 일하는 팀원들에게 긍정적인 자극을 많이 받는 편인 것 같아요.  조셉(김경만 안드로이드 개발자 겸 오베이 PM)이 입사하신 지 얼마 안 돼서 개발팀 세미나를 했을 때가 처음으로 충격을 받았어요. 저는 주제와 내용 자체가 어려워서 이해하기 힘들었는데 그걸 다 소화해서 발표하는 모습을 보면서 경각심이 생기더라고요.   조셉은 어떤 주제로 개발팀 세미나를 했을까요? (클릭)   아무래도 완전 경력자보다는 비슷한 또래나 경력을 가진 분들에게서 더 자극을 받나 보군요. 저는 그런 것 같아요. 그래서 로빈(권장호 개발자)이 입사했을 때는 진짜 충격이었어요. 저보다 어리고 경력도 짧은데 일을 대하는 태도나 적극성이 저랑 많이 달랐어요. 일하는 시간 외에도 시간 내서 꾸준히 개발 공부나 블로그를 하는 모습을 보면서, 저도 열심히 해야겠다는 생각이 들더라고요.  그전까지는 좀 안주하려는 면이 있었어요. 왜 그러냐면 저는 저보다 나이나 경력이 많은 분들이랑만 일해왔잖아요. 그러다 보니 칭찬도 “나이에 비해 잘한다”는 말을 주로 들었어요. 사실 그게 “아직 잘은 못한다”는 뜻이잖아요. 그걸 모르고 그냥 내가 잘하고 있구나 하면서 안도해왔던 것 같아요.  그런데 아직 어리다는 장점은 시간이 지날수록 약해지잖아요. 이른 나이에 빠르게 일을 시작했다는 저만의 장점을 계속 가지고 있으려면 지금 상황에 만족하는 게 아니라 계속 노력해야 한다는 걸 깨달은 것 같아요. 개발자를 하루 이틀 하다가 때려치울 것도 아니고 남들보다 빨리 실전에 뛰어든 만큼 이론적으로 부족한 것도 많으니 더 공부해야 한다는 거죠.    “일을 일찍 시작했다는 장점을 유지하려면  지금 상황에 만족하지 않고 계속 노력해야 돼요”   그런데 열심히 해보려고 해도 뭘 해야 할지, 어떤 공부를 어떻게 하면 좋을지 막막할 때도 있잖아요. 전 직장이었다면 그랬을 것 같아요. 그런데 개발팀원은 모두 저보다 개발 경력이나 사회 경험도 많고 언제든 조언해줄 마음이 열려있는 분들이라 도움을 받고 있어요. 특히 폴(이건노 CTO)은 주니어 개발자들과 1:1 미팅을 자주 가지면서 도움 되는 조언을 많이 해줘요.  한번은 폴이 제 개발자 커리어에 대한 조언을 해주셨어요. 저는 프론트엔드 개발자라면 프론트엔드만 전문적으로 파면된다고 생각했거든요. 그런데 백엔드 등 다른 개발 분야도 1단계 정도는 공부를 해둬야 지반이 탄탄한 프론트엔드 개발자가 될 수 있다는 조언을 해주셨어요. 그 조언이 지금도 기억에 많이 남아요. 왜냐면 지금 당장 해야 하는 프로젝트 단위가 아니라 제 인생 관점에서 조언을 해주신 거잖아요. 사실 폴은 CTO고 저는 직원이니까 조언도 업무 코치 위주로만 해줄 수도 있는 건데요. 이렇게 저보다 10, 20년 넘는 경력을 가진 분이 제 개발자 인생에 대해 해주는 조언은 어디서도 듣기 힘들잖아요.    그렇죠. 멘토가 중요하다고는 하는데, 20대 초반의 멘토는 보통 책이나 TV같이 멀리서만 접할 수 있는 인물이잖아요. 좋은 멘토는 많지만 나를 위한 조언이 아닐 때는 공허하게 들리기도 하고요.  맞아요. 저도 지금 이 시기에 바로 옆에서 조언해줄 수 있는 분이 있다는 건 정말 좋은 것 같아요. 그런 폴 덕에 개발팀은 시켜서 하기보다 자기 주도적으로 일할 수 있는 환경과 문화가 잘 갖춰진 것 같아요.  매주 진행하는 개발팀 업무 공유 회의 때도 단계나 일정에 대한 틀을 잡아주는 역할에 집중하는 편이세요. 위에서 “이거 해, 저거 해”라고 콕 집어서 마이크로 매니징을 하는 게 아니라, 프로젝트 단위로 자발적으로 구성원이 꾸려져서 진행해 나가는 게 오픈서베이의 업무 문화인 것 같아요.  그런 문화다 보니까 저도 시키는 일만 하는데 그치지 않고 다양한 시각에서 프로젝트를 바라보면서 의견도 많이 낼 수 있는 것 같아요. 구성원들이 제 의견을 경청해주고 수용해주면 ‘내가 프로젝트에 직접적으로 기여하고 있구나’란 생각이 들면 책임감도 더 생기는 것 같아요.    “내가 프로젝트에 기여하고 있다는 생각이 들면 더 책임감을 가지면서 일할 수 있어요”   그런 긍정적인 자극이 실제 업무 능력 향상으로도 이어지는 편인가요?  네. 저는 기술적인 면에서도 많이 성장하고 있다고 생각해요. 유지보수하기 수월한 깔끔한 코드를 짜는 능력도 예전보다 많이 향상됐고, 주어진 시간 내 일을 더 빨리 효율적으로 마칠 수 있는 생산성도 많이 올랐다고 생각해요. 저는 야근 없이 깔끔하게 일을 끝내는 게 일을 잘하는 거라고 생각해서요(웃음).   와! 그럼 레드가 배운 일 잘하는 방법 하나만 알려주세요.  저는 ‘똑똑하게 질문하기’라고 생각해요. 질문사항에 대해 충분히 고민해본 뒤 물어봐야 한다는 걸 알았어요. 사실 주니어 때 가장 많이 하는 고민이 ‘어떻게 해야 좋은 질문을 할 수 있을까’ 잖아요. 회사에서는 모르면 물어보라고 하는데 그냥 물어보면 혼날 때도 있으니까요. 그런데 질문거리에 대해 제가 충분히 소화를 못 하면 어디에서 어려움을 겪고 있고 그래서 어떤 도움이 필요한지 질문을 받은 분도 몰라요. 질문이란 건 제 업무를 위해 다른 분의 업무 시간을 빌리는 건데, 정확히 질문하지 못하면 질문한 사람이나 받은 사람의 시간을 그만큼 허비하는 거니까요.  이걸 알고 난 뒤 충분히 고민하고 물어보기 시작했더니 신기하게도 질문을 받은 분의 답변도 달라졌어요. 제가 테리(이한별 개발자)에게 질문을 많이 하는 편인데, “이렇게 해라, 저렇게 해라”는 단편적인 답변이 아니라 “이건 이래서 이렇고, 저건 저래서 저렇다. 그래서 이럴 땐 이걸 써야 하고, 저럴 땐 저걸 써야 한다”는 맥락적인 답변을 해줘요.  테리가 좋은 분이라 답변을 잘 해주시는 것도 있지만 제가 질문거리에 대해 충분히 고민해서 알고 있으니까 구체적으로 대답해줄 수 있는 거라고 생각해요. 이런 좋은 답변으로 과정을 충분히 알면 질문을 반복하거나, 다른 분의 질문에 불필요한 시간 낭비를 하지 않고 답할 수 있게 되는 것 같아요. 나중에 비슷한 상황이 오면 제가 스스로 문제를 해결할 수 있게 되고요.   주니어에게 꼭 필요한 팁이네요! 고맙습니다. 최근에는 방송통신대학교에 진학했다고 들었어요.  맞아요(웃음). 사실 방통대 진학도 로빈의 영향이 컸어요. 안 그래도 최근에 개발 이론 공부를 따로 해보자고 생각하던 차였어요. 그런데 로빈이 방통대 진학을 하면서 같이 해보자고 해서 이참에 도전했죠. 마음만 먹고 있다가 로빈 덕에 실행할 수 있었던 거에요. 요즘은 일을 마치면 방통대 강의를 듣거나 과제를 하는 데 시간을 보내고 있어요.     “이론 공부는 마음만 먹고 있다가 로빈 덕에 실행할 수 있었어요” (레드 옆에 노란옷을 입고 앉아 있는 분이 로빈입니다)   와.. 그럼 일과가 어떻게 되는 거예요?  오픈서베이 병특은 출퇴근 시간이 기본 10시 출근-7시 퇴근인데, 경우에 따라 신청해서 9시-6시로 변경할 수 있어요. 저는 방통대 다니면서부터 9시로 출근 시간을 조정했어요. 출근이 늦으면 그만큼 퇴근도 늦어지니 저녁 시간을 충분히 활용하지 못하겠더라고요.  하루일과는 9시까지 출근해서 우다다 일하고 점심 먹고 일하다가 6시에 칼같이 퇴근해요. 집에 가서는 씻고 밥 먹고 강의를 듣거나 과제를 하죠. 최근에는 저녁 필라테스를 시작해서 평일 저녁 중 이틀은 필라테스를 하러 가요. 주말에 좀 쉬고요(웃음).   조바심이 든다고 다 열심히 할 수 있는 건 아닌데, 남다른 원동력의 배경이 궁금하네요.  저도 진짜 빡센 것 같고 가끔 힘도 들어요. 그런데 다른 회사에서 병특 중인 주변분들 보면 운영보수 위주의 반복적인 업무만 하거나, 병특이라 쉽게 이직할 수 없으니 업무를 과다하게 몰아주는 경우도 보곤 해요.  제가 주어진 업무 시간에만 집중하고 퇴근 후 시간을 자기 계발을 위해 쓸 수 있다는 건 쉽게 얻기 힘든 기회일 수도 있는 거죠. 성장을 위한 중요한 시기에 주어진 기회라고 생각하면 열심히 할 수 있게 되는 것 같아요. 저보다 더 열심히 하는 다른 구성원을 보면서 자극을 받는 것도 물론 있고요.   산업기능·전문연구요원으로  오픈서베이에 지원하고 싶다면? (클릭)   자기개발에 매진하면 회사 생활에 소홀해질 것도 같은데.  음. 회사에서 성취가 없다는 생각이 들면 그럴 수 있겠네요. 그런데 오픈서베이는 반기마다 전사 회의를 통해 하이(황희영 대표이사)가 회사 성장에 대해 공유해주잖아요. 이 시간은 단순히 오픈서베이 매출 성장 공유가 아니라 제 기여가 회사에 어떤 도움이 됐는지, 이를 바탕으로 회사가 얼마나 성장하고 있는지를 점검하는 과정이라고 생각해요.  개인적으로는 투자 받은 돈 까먹는 스타트업이 아니라 우리 서비스와 구성원의 노력으로 흑자를 기록하고 매번 매출 성장을 하고 있다는 점도 저한테는 큰 보람이고 성취거든요. 실질적인 매출이 있고, 고객사가 계속 늘고, 매출 성장도 계속 일어난다는 이야기를 들으면 진짜 회사다운 회사라는 생각이 들고 성취감이 느껴져요.   6월에 강남역 1분 컷 초역세권 사무실로 이사도 가고! (웃음) 그것도 좋은데 사실 저는 하와이 간다고 했을 때 진짜 신났어요(웃음).  사실 전사 하와이 워크샵은 18년 목표 공약이라서 가는 거잖아요. 회사가 진짜 할 수 있는 목표를 잡아서 노력하고 목표 달성을 했을 때 약속을 지키는 모습을 보면서 되게 멋지다는 생각을 했어요. 좋은 회사와 좋은 어른의 모습은 이런 건가 싶고, 이런 모습을 보면서 저도 더 성장해야겠다고 생각하는 것 같아요.      “레드와 함께 일하고 싶으시다면 지금 바로 오픈서베이 입사 지원을 해보세요”
조회수 981

로봇 택시가 산업 지형을 바꾼다

로봇 택시가 산업 지형을 바꾼다"자율 주행 전기차의 등장으로 유가가 배럴당 25달러까지 떨어지고, 새로운 세계 질서가 도래할 것이다."'에너지 혁명 2030' 의 저자로 2015년 한국을 방문한 적 있는 토니 세바 스탠포드대 교수(RethinkX의 공동 설립자)가 최근 미국 CNBC와 인터뷰에서 "기름 수요가 2020년~2021년 사이 1백만 배럴로 꼭지를 찍은 뒤 10년 내(2030년경)로 70만 배럴까지 줄어들면서 유가가 하락세를 면치 못할 것”이라며 이같이 예견했다.점차 많은 사람들이 공유경제의 축으로 자율 주행 전기차를 사용하게 되면서 ▽오일 회사는 생존이 어렵게 되고 ▽심해, 세일가스업체와 정유 파이프라인 회사들도 문을 닫게 될 것이라는 게 그의 예측이다.차량도 소유의 대상에서 서비스의 대상, 이른바 TAAS (transport as a service) 로 바뀐다. 차량을 더 이상 구입하지 않고, 편리하게 앱으로 로봇 택시를 호출해 이용하면 그만이다. 자율 주행 전기차의 가격도 싸지면서, 전기차 이용이 소유에 비해 10배 정도 저렴해질 것이라는 것.  경제학자인 그의 섬뜩한 전망은 계속된다. 급속한 기술의 진보로 인해 값비싼 정유회사나, 적응력이 떨어지는 카 메이커(의 주식)가 매력이 없어지며, 차량과 관련된 직업 중에서 차 딜러도 2024년까지 사라질 것이라는 예상이다.뿐만 아니라, 주차공간의 80% 이상이 쓸모없게 되고, (자동차)보험의 비용도 급격하게 떨어지기 때문에 보험회사도 설 땅이 좁아진다는 것.이 같은 그의 전망이 혼자만의 견해는 아니지만,  다른 사람들은 이런 변화에 훨씬 많은 시간이 걸리고, 그렇게 극적이지도 않을 거라고 내다본다.반대로 그는 차량 관련 지출이 줄면서 가계 소비가 늘어나 경제성장을 촉진할 것이라고 예상했다. 아울러 차세대 차의 개발과 관련된 차 운영체제, 컴퓨터 플랫폼, 배터리, 지도 소프트웨어 회사들을 눈여겨 보라고 조언했다.세바 교수의  유가 하락 전망이  결코 급진적인 것은 아니다.  유가는 WTI(서부 텍사스중질유)기준으로 2016년 2월에  배럴당 20달러대 중반까지 급락한 바 있다.  6월 14일 현재는  40달러대 중반에 머물러 있다.다만, 차량이 소유의 대상에서 이용 서비스의 대상으로 바뀐다든지, 차 딜러가 사라진다든지 하는 등의 혁신적이거나 과격한 전망이 실현될 지는 두고 볼 일이다.참조 : 다음은 토니 세바 교수가 참여한 화제의 보고서 ‘Rethinking transportation 2020-2030’ 원문 링크https://static1.squarespace.com/static/585c3439be65942f022bbf9b/t/591a2e4be6f2e1c13df930c5/1494888038959/RethinkX+Report_051517.pdf
조회수 2162

Interview - Android App Developer 박형일님

크래커나인 팀에서는 사용자의 의견을 적극 반영하기 위해서 안드로이드 개발자 박형일님의 크래커나인 사용기 인터뷰를 해보았습니다.개발자 박형일님본인 소개를 부탁 드려요~저는 에이치나인에서 안드로이드 개발 파트를 담당하고 있는 박형일 입니다. 개발 경력은 12년 정도 됐구요.에이치나인에 입사한지는 4년 정도 됐습니다. 주로 외주 안드로이드 앱 개발 업무를 하고 있습니다.개발일을 꽤 오래 하셨네요. 시니어 개발자들은 코드를 직접 작성하는 것을 선호 하시는 것 같던데, 형일님은 어떠신가요?저도 코드를 직접 작성하는 것을 선호 하는 편입니다. 툴에서 생성되는 코드를 별로 신뢰하지 않아요. 제가 원하는 대로 안 나온다는 느낌을 많이 받거든요.그럼 크래커나인의 첫인상은 어떠셨나요? GUI 로 부터 코드를 생성해 주는 툴인데..처음엔 아이디어는 괜찮은데, 이게 과연 제대로 된 코드를 생성 해 줄까? 라는 의심이 들었죠. 꼭 사용 해 보고 싶은 프로그램은 아니었어요.크래커나인을 사용하신지는 얼마나 되셨죠?올해 6월쯤에 처음 접하여 2달 정도 된 같아요.어떤 프로젝트에 적용 해 보셨나요?회사에서 회의실 예약 시스템이 필요하다고 해서 회의실 예약 앱을 만들었어요.그 때 처음 사용 했죠. 공식 프로젝트가 아니라 디자이너 없이 웹에서 무료로 사용할 수 있는 Sketch 파일로 된 디자인 샘플을 받아서 혼자서 만들었어요.앱을 구성하는 화면은 대략 5~6개 정도로 간단한 프로젝트여서 가능 했죠. 지금은 외주 과제를 하고 있는데, 크래커나인을 사용 해서 하고 있어요.외주 같으면 주로 파워포인트로 작성된 GUI 가이드라인 문서를 보고 개발 하잖아요. 크래커나인을 사용하기 전에는 디자이너와 무엇을 통해서 개발에 필요한 디자인 정보를 얻으셨어요? 에이치나인에 있으면서 거의 대부분 GUI 가이드라인 문서를 보고 개발 했죠. 최근에 다른 프로젝트 팀에서 GUI 가이드라인 문서 없이 제플린을 쓰더라구요. 그래서 그것도 조금 써봤어요.제플린과 같은 기존의 유사 서비스와 비교해서 크래커나인은 어땠나요?GUI 가이드라인 문서를 보면서 개발을 하다 제플린을 써보니까 너무 편리하더라구요. 문서에서 원하는 정보 찾는게 불편했거든요.그래서 사실 처음 크래커나인을 사용 했을 때는 제플린과 큰 차이를 못 느꼈어요.근데 프로젝트를 진행 하다 보니 크래커나인의 코드 생성 기능이 있어서 좀 더 편리하다고 느껴지는 순간이 오더라구요. 제플린을 보고 개발 할 때는 코드나 수치를 직접 입력하다 보니 실수를 할 때도 있었고, 여전히 XML 작성하는 수고로움이 남아 있었거든요.근데 크래커나인의 레이아웃 코드 생성 기능을 사용해서 나온 XML 코드가 100% 는 아니지만 70~80%는 작업을 안해도 될 수준이더라구요. 그래서 XML 작성하는데 들이는 시간이 많이 줄어 들었어요.크래커나인을 익히는데 어렵지는 않으셨어요?타 서비스를 사용한 경험이 있어서 많은 부분 기능을 따로 매뉴얼로 보지 않아도 파악이 됐는데요.사용하는데 크게 문제는 없었던 거 같아요. 직관적으로 파악이 안 되는 기능은 사용하지 못한 것 같지만 따로 매뉴얼은 찾아보지 않았습니다.Cracker9의 어떤 기능이 가장 편리하셨나요?당연히 레이아웃 코드 자동 생성 기능이었습니다.손으로 직접 코딩 하지 않고 View들의 관계를 맺으면 자동으로 View의 관계와 속성을 xml 코드로 생성해주는 기능이 개발하는 데에 상당히 많은 도움이 되었습니다.Cracker9을 사용하면서 불편했던 점이나 개선했으면 하는 부분이 있었나요?Asset 이름이나 리소스(문자열, drawable) 이름이 해쉬값이나 text1, text2 이런 식으로 되어 있어 나중에 다 변경을 해 주어야 되었습니다. 이 부분은 개선이 되었으면 좋겠습니다.※ 위의 내용은 Cracker9 0.9.5 에서 개선되었습니다.Cracker9의 정식 버전으로 출시가 되면 사용할 의향이 있으신가요?네, 사용할 것 같아요. 가격만 너무 비싸지 않으면 전 무조건 사용하겠습니다.App을 만들거나 디자이너와 소통해야 하는 다른 개발자들에게 알려주고 싶은 Cracker9 사용 Tip이 있다면 알려주세요~디자이너가 텍스트나 이미지 단위로 View를 만드는데요. 개발자가 원하는 모든 View를 만들진 않기 때문에 Custom Layout 활용은 필수입니다.Custom Layout을 잘 활용하시면 원하시는 레이아웃 작업이 모두 가능합니다. 그리고, 오른쪽에 Tree Structure 패널이 있는데요.View의 트리 구조 순서로 레이아웃 xml 코드가 생성되기 때문에 어떻게 코드가 만들어질지 예상할 수 있어요. 물론 View의 순서나 부모/자식 관계는 마우스 드래그로 편집할 수 있습니다.마지막으로 Constraint Layout의 관계를 맺을 때, View가 작으면 정확하게 클릭하여 작업하기 어려울 수 있는데요. 당연하지만 View를 확대해서 연결 지으면 쉽게 작업할 수 있습니다.마지막으로 Cracker9에게 한 말씀해주세요~저는 안드로이드 App을 개발하면서 레이아웃 작업은 초반에 하는 시간 잡아먹는 노가다 작업이라고 생각을 했는데요.레이아웃을 자동으로 생성해주는 Cracker9을 사용하면서 더 이상 노가다라는 생각을 하지 않게 되었습니다. 아직은 Beta 버전이라 부족한 부분이 보이지만, 개선될 것이라고 믿고 계속 사용할 거 같아요.앞으로 발전하는 모습 기대하겠습니다 파이팅!#에이치나인 #디자이너 #개발자 #협업툴 #크래커나인 #솔루션기업 #팀원인터뷰 #기업문화 #조직문화 #팀원자랑
조회수 1145

flake8-import-order-spoqa

안녕하세요. 스포카 프로그래머 홍민희입니다.스포카 사내에서는 파이썬 코드의 스타일을 맞추기 위해 flake8을 사용해왔습니다. PEP 8 스타일을 준수하게 해주고, 안 쓰는 임포트를 꼭 지우게 하는 등의 좀더 구체적인 규칙도 지키게 해주는 린트 도구입니다. 사실상의 표준이기 때문에 파이썬을 이미 쓰고 있는 분들이라면 많이들 알고 계실 것입니다.그렇지만 import문의 사용에 대해서는 우리가 원하는 것만큼의 규칙을 제공하지 않아서, 예전부터 동료 강효준 님이 import-order를 별도로 만들어서 써왔습니다. 만들었을 당시에는 import문의 쓰임에 대한 린트 도구가 없었기 때문에 유용하게 써왔고, 다른 파이썬 오픈 소스 프로젝트에서도 유용할 것 같다고 생각하여 쓰인지 1년쯤 지난 뒤에 오픈 소스로 공개했습니다.하지만 flake8과는 다르게 외부 커뮤니티에서 널리 쓰이지는 못했고, 사실상의 표준이 되었다면 편집기 연동 등이 이뤄졌겠지만, 그에 미치지는 못했습니다. pre-commit hook이나 CI에서나 검사가 이뤄지기 때문에, 코딩을 마쳤다고 생각한 이후에 뒷북으로 실수를 바로잡는 일이 많아 불편했습니다.그 뒤로 시간이 지나자 커뮤니티에서는 flake8-import-order라는 도구가 나와서 사실상의 표준이 됐습니다. 이미 많은 편집기에서 연동이 되는 flake8의 확장으로 구현됐기 때문에 편집기에서 즉시 확인이 가능했고, 더 많은 옵션도 제공했습니다. 그렇지만 cryptography 프로젝트 사람들이 만든 도구다보니, cryptography 스타일 및 Google 스타일 등 몇 가지만 제공했고, 이 도구를 활용하려면 스포카에서 3년 넘게 쓰이던 import 스타일을 포기하고 사내의 모든 코드를 전부 수정하는 난리를 피우거나, flake8-import-order에 스포카 사내 스타일을 옵션으로 추가하거나, 프로젝트를 포크해서 별도로 유지보수하며 써야 했습니다.사내 모든 코드를 전부 수정하는 것은 쉽지도 않을 뿐더러, 스포카에서 쓰이던 스타일에도 나름의 논거는 있기 때문에 쉽게 포기하기는 힘든 결정이었습니다. 일부 프로젝트부터 옮겨가는 시도도 있었으나, 같은 회사에서 코드마다 스타일의 일관성이 달라지는 혼란이 있었습니다.저는 flake8-import-order에 스타일을 추가하는 것을 주저했습니다. Google 스타일처럼 문서화가 이미 아주 자세히 되어 있지도 않고 유명하지도 않은, 일개 회사의 사내 스타일을 사실상의 표준 린트 도구의 7번째 공식 지원 스타일로 추가하는 것이 이뤄질 개연성이 낮다고 봤습니다.그래서 프로젝트를 포크하기로 마음먹은 것이 보름 전쯤입니다. 그런데 코드를 열어보니 좀더 나은 아이디어가 떠올랐습니다. flake8-import-order의 코드를 고치지 않고 런타임에 스타일을 확장 가능한 플러그인 구조를 추가하면, 스포카에서 쓰는 import 스타일을 별도 패키지로 구현할 수도 있다는 생각이 든 것입니다. 당시 flake8-import-order의 스타일 구현은 Style의 기반 클래스를 상속받는 식으로 이뤄져 있었고, 다만 스타일의 목록이 하드코딩되어 있는 것이 문제였습니다. 막상 코드를 읽어보니 플러그인 구조를 도입하는 것이 어렵지 않을 것이라는 생각이 든 것입니다.파이썬 생태계에서는 서로 다른 패키지 사이에서 런타임에 확장 가능한 의존성 주입을 위해 setuptools 시스템이 엔트리 포인트라는 개념을 제공합니다. 예를 들어 국제화 라이브러리인 Babel은 파이썬 이외의 프로그래밍 언어에서도 gettext 문자열을 extract할 수 있게 하기 위해, 확장 가능한 babel.extractors 엔트리 포인트를 노출합니다. 그리고 별도의 템플릿 언어인 Jinja는 해당 템플릿 엔진을 쓸 때 국제화도 대응할 수 있도록, babel.extractors 엔트리 포인트에 Jinja 언어를 해석하는 jinja2.ext.babel_extract를 주입합니다.저는 같은 개념을 활용하여, flake8-import-order가 flake8_import_order.styles라는 엔트리 포인트를 노출하게 하는 패치를 제출했고, 다행히도 업스트림에 받아들여졌습니다.flake8-import-order를 런타임에 확장할 수 있는 구조가 됐으니, flake8-import-order 위에서 스포카의 import 사용 가이드를 구현하는 것은 어렵지 않은 작업이었습니다. 어차피 스포카의 파이썬 코딩 스타일은 대부분 PEP 8을 그대로 따르고 있었고, 따라서 flake8-import-order에 이미 존재하는 스타일 구현에서 몇 부분만 덮어씌우는 것으로 충분했기 때문입니다.위와 같은 장광설 끝에, 그래서 이번에 소개하려고 한 스포카의 파이썬 import 린트 도구는 flake8-import-order-spoqa입니다. 만든지 보름이 지난 뒤에 소개하는 것은, flake8-import-order에 제출한 패치가 포함된 0.12가 PyPI에 릴리스될 때까지 기다려야 했기 때문입니다.사용법은 어렵지 않습니다. pip로 flake8-import-order-spoqa를 설치한 뒤에, flake8 설정에 다음 옵션을 추가하면 됩니다.[flake8]import-order-style = spoqa#스포카 #개발 #개발자 #개발팀 #개발팁 #꿀팁 #인사이트
조회수 10606

파이썬의 시간대에 대해 알아보기(datetime.timezone)

안녕하세요. 스포카 크리에이터 김두리입니다.  스포카는 많은 프로덕트에서 국제화 서비스를 제공하고 있습니다. 그래서 시간대와 시간을 제대로 정확하게 처리하는 것은 중요합니다. 하지만 파이썬의 datetime.datetime은 날짜(datetime.date)와 시각(datetime.time)의 정보를 담고 있고, 시간대(datetime.timezone)의 정보는 담거나 담지 않을 수도 있으므로 헷갈리는 부분이 존재합니다.     시간을 처리할 때 시간대는 왜 중요할까요? 시간대가 명시되지 않은 시각은 충분한 정보를 내포하고 있지 않습니다. 저는 얼마 전, Google Calendar API를 이용하여 작업할 때 골치 아픈 일을 겪었습니다. 오늘의 일정을 불러오고 싶어서 오늘 0시~24시로 데이터를 요청했지만, 계속해서 결괏값에 다음 날의 일정도 포함되어서 반환되었습니다.   왜 다음날 일정도 포함되었던 걸까요? 아래와 같은 코드를 작성하여 Google Calendar API에 요청했습니다.   today = datetime.date.today() from_ = datetime.datetime(today.year, today.month, today.day, 0, 0, 0) to = datetime.datetime(today.year, today.month, today.day, 23, 59, 59) events = get_events_from_google_calendar(from_, to)   몇 시간 동안 머리를 싸매고 코드를 한 줄 한 줄 따져가며 고민을 했습니다. 결국, 제가 요청한 시각에 시간대가 지정되어 있지 않아 get_events_from_google_calendar() 함수 내부에서 from_과 to가 의도하지 않은 시간대의 시각으로 인식되어서 발생했던 문제라는 것을 알게 되었습니다.  # 원래 의도했던 시간대: 대한민국 시간대(KST)에서 오늘 0시 0분 0초 KST = datetime.timezone(datetime.timedelta(hours=9)) from1 = datetime.datetime(today.year, today.month, today.day, 0, 0, 0, tzinfo=KST) # get_events_from_google_calendar()가 받아들인 시간대: UTC 시간대에서 오늘 0시 0분 0초 from2 = datetime.datetime(today.year, today.month, today.day, 0, 0, 0, tzinfo=datetime.timezone.utc)   위 예제에서 from2 - from1를 하게 되면 timedelta(hours=9)가 계산됩니다. 우리가 원했던 것은 KST 기준 오늘 0시부터의 일정이었지만, Google Calendar API에서는 시간대를 UTC로 취급하여 KST 기준 오늘 9시부터 다음날 9시까지의 일정을 불러왔던 것입니다.  이렇듯 시간 관련 작업을 할 때 시간대에 대해 제대로 알고 있지 않으면 의도치 않게 많은 시간을 소모하게 될 수도 있습니다.  오늘은 제가 파이썬으로 시간대 관련 처리를 하며 모았던 정보를 정리하여 공유하고자 글을 작성하게 되었습니다.  시간대  나라 또는 지역마다 살아가는 시각이 다르기 때문에 시간대에 따른 편차가 존재합니다. 이 차이가 피부로 잘 와닿지 않은 채 살아가더라도 캘린더 API나 국제화 서비스 준비 등등 시간과 관련된 작업을 진행하다 보면 시간대 문제에 직면하게 됩니다.  시간대는 영국의 그리니치 천문대(본초 자오선, 경도 0도)를 기준으로 지역에 따른 시간의 차이, 다시 말해 지구의 자전에 따른 지역 사이에 생기는 낮과 밤의 차이를 인위적으로 조정하기 위해 고안된 시간의 구분 선을 일컫는다. 시간대는 협정 세계시(UTC)를 기준으로 한 상대적인 차이로 나타낸다.     UTC에 대한 더 자세한 내용은 여기를 참고해주세요.   시간대에 대한 더 자세한 내용은 여기를 참고해주세요.   파이썬의 datetime.datetime.now()는 실행 환경의 시간대에 따라서 시각을 표시합니다.  2019-01-01 00:00:00 +09:00에 시간대가 Asia/Seoul로 설정된 제 랩탑에서 현재 시각을 가지고 오면, 아래와 같은 시각이 표시됩니다.  >>> print(datetime.datetime.now()) 2019-01-01 00:00:00.000000   그런데, 같은 시각에 Asia/Taipei로 설정된 랩탑에서는 현재 시각이 아래와 같이 표시됩니다.  >>> print(datetime.datetime.now()) 2018-12-31 23:00:00.000000  위의 예제처럼 시간대에 따라 시각이 다를 수 있다는 것을 알 수 있습니다.  나라별 시간대 비교해보기  UTC를 기준으로 시간이 빠르면 +시차, 시간이 느리면 -시차로 표시합니다.                                                                                                                                시간대나라코드UTC-5미국(동부)ESTUTC영국GMTUTC+8대만TWUTC+9대한민국KSTUTC+9일본JSTUTC+10오스트레일리아(동부)AEST     나라별 시간대 차이에 대한 더 자세한 내용은 여기를 참고해주세요.   시간대를 명확히 표시하지 않은 시각은 혼동을 일으킬 수 있습니다. 예를 들어서, 서울에 살고 있는 점주가 2019년 1월 1일 0시 0분에 방문한 고객을 알고 싶어 한다고 가정해봅시다. 이 데이터를 파이썬으로 표현하면 아래와 같이 적을 수 있습니다.  KST = datetime.timezone(datetime.timedelta(hours=9)) korea_1_1 = datetime.datetime(2019, 1, 1, 0, 0, 0, tzinfo=KST)   만약, 대만에 사는 점주가 이를 요청했다면 아래와 같이 적을 수 있습니다.  TW = datetime.timezone(datetime.timedelta(hours=8)) taipei_1_1 = datetime.datetime(2019, 1, 1, 0, 0, 0, tzinfo=TW)   위 예제에서 보이는 것 같이 대한민국과 대만에 있는 점주가 같은 시각을 요청했더라도, 시간대(KST/TW)에 따라서 별도로 처리해야 합니다.  assert korea_1_1 != taipei_1_1 assert taipei_1_1 - korea_1_1 == datetime.timedelta(hours=1) # 같은 시각이지만 시간대에 따라서 시간차가 있습니다.   그렇기 때문에 시간대가 표시되어 있지 않은 2019년 1월 1일이라는 정보만으로는 정확한 시각을 알 수 없습니다.  naive_1_1 = datetime.datetime(2019, 1, 1, 0, 0, 0) assert korea_1_1 != naive_1_1 assert taipei_1_1 != naive_1_1   이런 상황을 해결하기 위해 시각은 어떤 한 시각을 기준으로 하여 그 차이가 표시되어야 합니다. 그 기준으로 정한 것이 UTC입니다. 대한민국은 UTC를 기준으로 아홉시간 빠르기 때문에 korea_1_1의 시각을 UTC 시간대로 표현하면 2018-12-31 15:00:00+00:00입니다. 대만은 UTC를 기준으로 여덟시간 빠르기 때문에 taipei_1_1의 시각을 UTC 시간대로 표현하면 2018-12-31 16:00:00+00:00입니다. 위의 시각은 각각 대한민국(2019-01-01 00:00:00+09:00), 대만(2019-01-01 00:00:00+08:00)으로 표시할 수 있습니다. 이렇게 시간대와 같이 표시하면 혼란 없이 정상적으로 처리할 수 있습니다.  datetime  datetime은 파이썬에서 기본으로 제공하는 표준 라이브러리로, 간단하거나 복잡한 방식으로 날짜와 시각을 조작하기 위한 클래스를 제공합니다.  The datetime module supplies classes for manipulating dates and times in both simple and complex ways.  datetime은 시간대 포함 여부에 따라서 naive datetime, aware datetime 두 가지로 나눕니다.  naive datetime / aware datetime  datetime의 타입을 알아봅시다. 파이썬에서 시간 관련 연산을 하다 보면 종종 아래와 같은 에러 문구를 만날 수 있습니다.  >>> a = datetime.datetime.now() >>> b = datetime.datetime.now(datetime.timezone.utc) >>> a - b Traceback (most recent call last): File "", line 1, in TypeError: can't subtract offset-naive and offset-aware datetimes      naive datetime : naive datetime 객체는 그 자체만으로 시간대를 찾을 수 있는 충분한 정보를 포함하지 않습니다. (e.g. datetime.datetime(2019, 2, 15, 4, 58, 4, 114979))   aware datetime(timezone-aware) : 시간대를 포함합니다. (e.g.datetime.datetime(2019, 2, 15, 4, 58, 4, 114979, tzinfo=)) aware datetime 객체는 자신의 시각 정보를 다른 aware datetime 객체와 상대적인 값으로 조정할 수 있도록 시간대나 일광 절약 시간 정책 혹은 적용 가능한 알고리즘 정보를 담고 있습니다.   tzinfo는 UTC, 시간대 이름 및 DST 오프셋에서 로컬 시간의 오프셋을 나타내는 방법을 담고 있습니다. 더 자세한 내용은 공식 문서를 확인해주세요.  naive datetime은 어느 시간대를 기준으로 하는 시각인지 모호하므로 aware datetime을 이용하는 것을 권장합니다.  직접 확인해보기  준비한 몇 가지 코드를 보며 확인해봅시다. naive datetime과 aware datetime의 차이를 확인하고, 시간대 지정 방법에 대한 내용을 다룹니다.  개발환경     Python 3.7   pytz   여기서는 datetime을 쉽게 다루기 위해 pytz 라이브러리를 사용합니다. pytz는 아래와 같은 장점이 있습니다.    시간대를 시간차가 아닌 사람이 알아보기 쉬운 지역 이름으로 비교적 쉽게 설정할 수 있습니다.   원하는 시간대의 aware datetime으로 변경해주는 localize() 메소드를 제공합니다.   pytz 사용에 앞서, pytz가 제공하는 시간대 식별자를 확인하시려면 다음을 따라 해주세요. import pytz for tz in pytz.all_timezones: print(tz)  혹은 여기를 참고하셔도 좋습니다.  naive datetime  naive datetime은 날짜와 시각만을 갖습니다.  import datetime datetime.datetime.utcnow() # UTC 기준 naive datetime : datetime.datetime(2019, 2, 15, 4, 54, 29, 281594) datetime.datetime.now() # 실행 환경 시간대 기준 naive datetime : datetime.datetime(2019, 2, 15, 13, 54, 32, 939155)   aware datetime naive datetime과 달리 aware datetime은 시간대 정보(tzinfo) 도 갖습니다. import datetime from pytz import utc utc.localize(datetime.datetime.utcnow()) # UTC 기준 aware datetime : datetime.datetime(2019, 2, 15, 4, 55, 3, 310474, tzinfo=)   now는 UTC를 기준으로 현재 시각을 생성합니다. 하지만, naive한 시각입니다.  now = datetime.datetime.utcnow()   이 시각은 naive한 시각이므로 pytz.timezone.localize를 통해 timezone-aware한 시각으로 변환된 시각과 동일하지 않습니다.  assert now != utc.localize(now)   시간대 제대로 지정하기  시간대가 무엇이고, 명시하는 것이 왜 중요한지 알게 되셨다면 시간대를 원하는 의도에 맞게 지정하는 방법에 대해 알아봅시다.  import datetime from pytz import timezone, utc KST = timezone('Asia/Seoul') now = datetime.datetime.utcnow() # UTC 기준 naive datetime : datetime.datetime(2019, 2, 15, 4, 18, 28, 805879) utc.localize(now) # UTC 기준 aware datetime : datetime.datetime(2019, 2, 15, 4, 18, 28, 805879, tzinfo=) KST.localize(now) # UTC 시각, 시간대만 KST : datetime.datetime(2019, 2, 15, 4, 18, 28, 805879, tzinfo=) utc.localize(now).astimezone(KST) # KST 기준 aware datetime : datetime.datetime(2019, 2, 15, 13, 18, 28, 805879, tzinfo=)   replace() 메소드로 날짜나 시간대를 변경할 수 있습니다.  KST = timezone('Asia/Seoul') TW = timezone('Asia/Taipei') date = datetime.datetime.now() # datetime.datetime(2019, 2, 15, 13, 59, 44, 872224) date.replace(hour=10) # hour만 변경 # datetime.datetime(2019, 2, 15, 10, 59, 44, 872224) date.replace(tzinfo=KST) # tzinfo만 변경 # datetime.datetime(2019, 2, 15, 13, 59, 44, 872224, tzinfo=) date.replace(tzinfo=TW) # tzinfo만 변경 # datetime.datetime(2019, 2, 15, 13, 59, 44, 872224, tzinfo=)   하지만 replace는 그 속성 자체만을 바꿔버리는 것이기 때문에 사용에 주의할 필요가 있습니다.  now = datetime.datetime.utcnow() assert utc.localize(now) == now.replace(tzinfo=utc) assert KST.localize(now) != now.replace(tzinfo=KST) assert TW.localize(now) != now.replace(tzinfo=TW)  그뿐만 아니라 replace()를 이용할 경우 의도하지 않은 시간대로 설정될 수도 있으므로 유의해야 합니다. 그 이유는 아래와 같습니다.     시간대는 생각보다 자주 바뀝니다(더 자세한 내용은 스포카의 규칙 2번을 참고해주세요). 이렇게 변경되는 사항들은 tz database에 기록되는데, pytz는 이에 기반합니다. pytz의 버전이 2018.9와 같은 날짜로 되어있는데 2018.9 버전은 2018년 9월 기준 시간대 테이블을 기준으로 시간대를 만들어주는 버전입니다. 이 버전에선 Asia/Seoul의 시간대는 UTC+9입니다.   pytz는 무슨 이유에서 인지 datetime.replace()나 datetime.astimezone()에서 호출될 때 이 tz database 타임 테이블의 맨 첫 번째(가장 오래된) 기록을 가지고 변환을 시도합니다. 서울의 경우 초기에 UTC+8:28이었기 때문에 이 정보를 기반으로 변환합니다.   그래서 pytz를 사용할 때는 pytz.timezone.localize()를 항상 써야 하고, .astimezone()같은 파이썬의 표준 메서드들을 사용하고 싶다면 datetime.timezone을 사용해야 합니다.  스포카의 규칙 스포카에서 datetime을 다룰 때 흔히 따르는 두 가지 큰 원칙이 있습니다.  1. naive datetime은 절대 사용하지 않습니다. 가장 큰 이유는 naive datetime과 aware datetime을 서로 섞어서 쓰지 못한다는 것입니다.  >>> from datetime import datetime, timezone >>> datetime.utcnow() + datetime.now(tz=timezone.utc) Traceback (most recent call last): File "", line 1, in TypeError: unsupported operand type(s) for +: 'datetime.datetime' and 'datetime.datetime'   동적 타입 언어에서 쓸 수 있는 가장 간단한 타입 검사 수단인 isinstance() 체크로도 이 둘을 구별할 수가 없으므로, 코드의 어느 지점에서 naive datetime이 섞이기 시작하면 예기치 않은 지점에서 버그 발생 가능성이 급격히 올라갑니다. Python 2에서 str과 unicode를 섞으면 안 되는 것과 비슷한 이유라고 생각하시면 됩니다.  2. 장기적으로 보존해야 하는 datetime은 항상 UTC를 기준으로 저장합니다. 지역 시간대는 지정학적 또는 정치적인 이유로 생각보다 자주 바뀝니다. 예컨대 1961년 이전까지 한국은 UTC+08:30을 지역 시간대로 사용했었고, 1988년 올림픽 즈음에는 일광 절약 시간대를 시행하고 있었습니다. 시간대 데이터베이스(tz database)는 이런 변경 내역을 담고 있고, pytz가 제공하는 시간대 객체의 동작에도 반영되어 있습니다. 그 때문에 시간대 데이터베이스가 제때 업데이트되지 않거나, 갑작스러운 시간대 변경으로 데이터베이스에 반영이 늦어지거나 하면, 시간 계산에서 오차가 발생할 여지가 있습니다. 또한 같은 aware datetime 이어도 서로 다른 시간대를 가진 datetime끼리 연산하거나 하는 상황도 문제를 복잡하게 만들고, DB나 다른 서비스의 API를 사용할 때, 그 서비스가 시간대를 제대로 다루는 데에 필요한 복잡도를 감수하는 대신 단순히 UTC 기준의 고정 오프셋 시간대만 사용하는 등의 이유로 서로 지원 범위가 맞지 않아 곤란을 겪을 수도 있습니다.  혼선을 줄일 수 있는 좋은 규칙 중 하나는, str과 unicode를 다루던 것과 비슷하게 모든 내부적인 계산에서 UTC 기준의 aware datetime만 사용하고, 사용자에게 보여줘야 할 때만 필요한 시간대로 변환해서 보여 주는 것입니다.  스포카에서는 메인 서버의 dodo.datetime 유틸리티 모듈도 이런 규칙을 따르고 있으며, 대부분의 SQLAlchemy DB 모델 객체의 DateTime 컬럼에서 timezone=True 옵션을 켜서 사용하고 있습니다.  정리  시간 관련 작업을 하신다면 아래 사항을 꼭 기억해주세요.시간대를 명시합시다.시각을 애플리케이션 로직이나 데이터베이스에서 저장할 때는 UTC로 사용하고, 유저에게 표시할 때만 유저의 시간대로 변환하여 보여주도록 합시다.    백엔드 서버끼리 통신할 때도 항상 UTC를 사용한다는 가정을 하면, 시간대가 없더라도 robust하게 처리할 수 있습니다.
조회수 396

프로그래밍 수업의 모든 것 — 엘리스 코스 매니저 인터뷰.

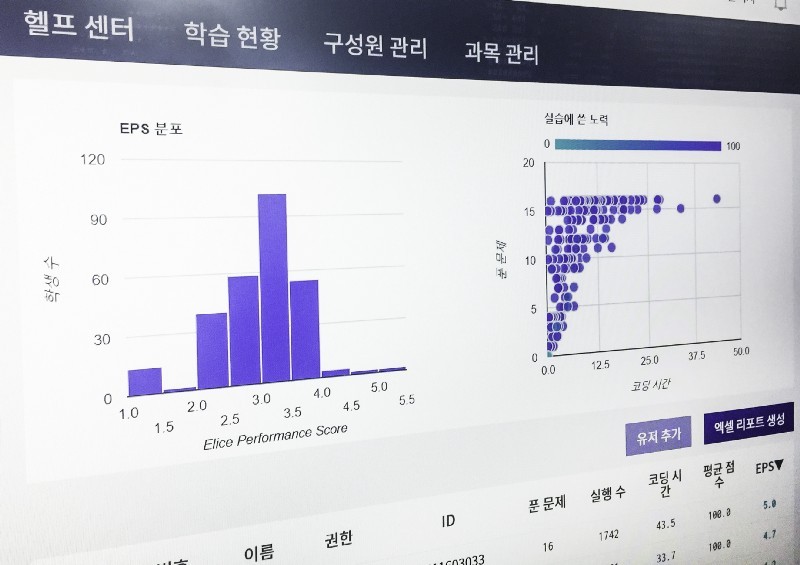
안녕하세요 엘리스입니다:)엘리스의 프로그래밍 수업은 누구에 의해서, 어떻게, 어떤 생각을 바탕으로 만들어질까요? 미래를 이끌어나갈 컴퓨터 사이언스 기술과 그 근간이 되는 교육 사이에서 좋은 프로그래밍 수업을 만들기 위해 치열하게 고민하는 엘리스의 코스 매니저가 직접 이야기합니다! 마침 엘리스는 코스 매니저 채용 중에 있으니 관심이 있다면 눈여겨 봐주세요.코스 매니저가 관여한 프로덕트로 인하여 사용자가 성장을 하고 있다면 그것은 충분히 의미 있는 일.# 안녕하세요 저는,“트라우마를 극복한 프로그래밍 수업 크리에이터.”Q. 자기소개 부탁드려요.A. 엘리스의 프로그래밍 과목을 만드는 코스 매니저 이용희입니다.Q. 엘리스에서 일하게 된 이유는 무엇인가요?A. 원래는 프로그래밍에 대한 트라우마가 있었어요. 하지만 기술 창업에 대한 꿈이 있었기 때문에 프로그래밍은 극복해야 할 산이었죠. 엘리스는 가장 뛰어난 기술자들이 모여 창업한 스타트업이에요. 당연히 기술 창업을 가장 가까이에서 경험할 수 있는 매력적인 곳으로 느껴졌죠. 그리고 프로그래밍 교육을 제공한다는 것 역시 기회로 느껴졌어요. 저와 같이 프로그래밍을 미워하고 두려워하는 사람들에게 보다 쉽게 배울 수 있는 환경을 마련해주고 싶다는 기대로 일을 시작하게 되었습니다.Q. 두려운 대상을 향해 몸을 던지셨군요! 그런데 코스 매니저가 프로그래밍을 몰라도 되나요?A. 많이 알면 알수록 당연히 좋아요. 많이 알고 있을수록 시도할 수 있는 것도 많고 학생에게 전달해줄 수 있는 것은 더욱더 많기 때문에요. 하지만 최소한으로는 Class가 뭔지 알고 있으면 OK. 예를 들어서 코드를 보고 이 코드가 어떤 목적을 갖는지 알 수 있으면 직접 코딩을 하지는 못한다고 해도 괜찮아요.Q. 코스 매니징 외에도 라이브 수업 참여, 조교, 챌린지 사회자 등 많은 역할을 하셨는데 이유가 있나요?A. 좋은 수업을 만들기 위한 첫 번째 방법은 코스를 만드는 모든 과정에 참여하는 사람들의 역할을 직접 체험해 보는 것이라고 생각했어요. 학생으로서, 조교로서, 사회자나 라이브 어시스턴트로서. 이렇게 하니까 학생으로서 수업을 접할 때의 감상은 무엇인지, 조교로서 가르쳤을 때는 어떤 어려움이 있는지를 알 수 있었어요. 라이브 수업 어시스턴트로 참여했을 때는 방송하시는 선생님들의 애로사항을 알 수 있겠더라고요.# 코스 매니징의 정수.“프로그래밍적 성장을 도움으로써 가치를 만들어 냅니다.”Q. 코스 매니징의 A to Z는? 구체적인 업무 프로세스가 궁금해요.A. 크게 기획 — 모집 — 제작 — 분석의 네 단계로 이루어져 있어요.수업 기획 — 어떤 과목을 만들 것인가? 주차별로 무엇을 다룰 것인가? 흥미로운 콘텐츠는?선생님, 조교 모집 — 엘리스가 구상한 수업을 가장 잘 전달할 수 있는 선생님과 조교를 모집.수업 제작 및 운영 — 실습 문제, 강의 자료 등을 엘리스의 색깔로 제작하여 수업을 운영.데이터 분석 — 학생들의 피드백과 데이터를 다음 수업의 발전 및 교육자와의 관계 개선에 반영.Q. 업무 방식은? 어떤 메리트가 있나요?A. 처음부터 끝까지 모든 과정을 주도해나가는 방식이에요. 어떤 회사를 가도 프로덕트의 end to end 프로세스를 전부 경험하기는 어려운데 엘리스에서는 그 전 과정을 경험할 수 있어요. 저는 이러한 경험이 교육 업계나 특정 프로덕트에만 적용할 수 있는게 아니라 다른 업계에 간다고 하더라도 충분히 전환될 수 있는 좋은 경험이라고 생각해요.Q. 미래 산업의 근간이 될 교육을 직접 만든다는 중책을 맡고 계신다고 생각하는데요, 좋은 프로그래밍 수업을 만들기 위해 어떤 노력들을 하시나요?A. 그런 영향을 미칠 수 있다는 게 무서운 일인 것도 같아요. 어떤 사람들은 엘리스를 통해서 프로그래밍을 처음 접하는 것일 수도 있는데 그 경험이 불쾌했다면 앞으로 프로그래밍을 배울 생각이 전혀 들지 않을 수도 있는 거잖아요. 그래서 최대한 다양한 피드백을 받아서 수렴하려고 해요. 외적으로는 대학강의, 수많은 수업들을 참고해요. 여러 강의를 보다보면 좋은 예도 많지만 모든 수업이 재미있지는 않아요. 중간에 듣다 마는 경우도 있고요. 그럴 때마다 내가 왜 중단했고 어떤 요소를 바꾸면 엘리스에서는 학생들이 끝까지 들을 수 있을까 고민해서 반영하려고 하죠.Q. 언제 보람을 느끼나요?A. 내가 관여한 프로덕트가 누군가에게 임팩트를 만들어내고 나뿐만 아니라 프로덕트를 사용하는 사람들이 성장을 하고 있다면 그것은 충분히 가치 있는 일인 것 같아요. 저희 플랫폼에서는 대시보드를 통해서, 그리고 학생이 코드를 어떻게 짜고 있는지 보면서 그 결과를 가시적으로 확인할 수 있어요. 누군가 제가 만든 코스를 수강함으로써 실질적으로 성장하는 게 눈에 보일 때 가장 큰 보람을 느끼는 것 같아요.한 번은 한 선생님께서 학생으로부터 ‘선생님 덕분에 취업할 수 있었어요’라는 메시지를 받은 것을 엘리스와 공유해주셨는데 그때 정말 행복하더라고요. 이게 엘리스가 추구하는 거다,라는 생각을 했어요. 엘리스도 하나의 커뮤니티이고 싶거든요. 이 경우에는 학생-선생님-엘리스가 서로의 영향으로 좋은 결과를 만들어 낸 거죠. 이런 접점을 앞으로 더 많이 만들려고 생각하고 있어요.대시보드에 나타나는 학생들의 학습 현황 및 성취도.# 엘리스는 이런 팀.“가치, 성장, 사람. 포기할 수 없는 세 가지가 있는 곳.”Q. 함께 일하는 동료들은 어떤 사람들인가요? 총평을 하자면?A. 항상 내가 최고의 사람들과 함께하고 있다라는 확신이 있어요. 각자 자기 분야에서 최고의 실력을 가진 사람들과 함께 일한다는 것만으로도 큰 자극이 되죠. 프로그래밍이든 스타트업 생존 노하우든 항상 뭔가를 새롭게 배우고 성장하게끔 동기부여를 해주는 사람들이에요. 저는 트라우마가 있었을 정도로 프로그래밍을 두려워했지만 이들과 함께 일하며 작은 피드백을 하나 듣는 것만으로도 제 실력이 빠르게 성장한다는 것을 몸소 느낄 수 있었어요. Q. 엘리스의 분위기, 팀 문화는 어떤가요?A. 새로운 것에 도전하는 것을 환영하는 수평적이고 자유로운 팀. 인턴도 아이디어를 제시할 수 있어요. 이 다음이 더 중요한데, 아이디어에서 그치는 게 아니라 활발한 피드백이 오가요. 아이디어를 실행하기 어렵다고 판단하더라도 왜 그렇고 어떻게 발전시킬 수 있는지 이야기하죠. 실행하게 되었을 때는 아이디어를 제시한 사람에게 일에 대한 권한이 전적으로 주어지고요. 저도 처음엔 파트타임 인턴이었지만, 이런 팀문화 덕분에 계속해서 업무 범위를 확장하고 제 역량을 키울 수 있었어요.# 코스 매니저 채용.“Generalist & Infinite Learner”Q. 현재 코스 매니저를 구인 중인데요. 코스 매니저에 적합한 성향이 있나요?A. Generalist, 그리고 Infinite Learner. 깊게 한 분야를 아는 사람보다는 얕고 넓게 아는 사람이 더 적합하다고 생각해요. 다르게 말하면 새로운 것을 시도하는 것을 좋아하고 새로운 것을 접할 때 포용력이 높은 사람이요. 두 번째로는 배움에 재미를 느끼는 사람. 엘리스는 교육 스타트업이고 코스 매니저는 직접 교육의 경험을 만드는 사람이니 스스로가 배움에서 행복을 느끼는 사람이라면 훨씬 더 재미있게 일할 수 있겠죠. 한 가지 덧붙이면, 데이터 분석을 배우고 싶은 분께 엘리스는 최고의 장소입니다.Q. 코스 매니저로서 갖추고 있으면 좋은 역량이나 자질이 있다면?A. 소통 능력과 균형 감각. 코스 매니저는 수업을 만드는 모든 단계에서 다양한 이해당사자들과 일하게 돼요. 이들과 원활하게 소통하고 의견을 공유하는 게 중요하죠. 그리고 다양한 사람들 사이에서 최고의 균형을 찾아내는 것도 중요해요. 예를 들어서 선생님의 경우 개발만 해왔고 교육이라는 것을 접해본 적이 없는 분들이 대부분이고, 학생은 프로그래밍을 처음 접하면 그 수업이 좋은 건지 아닌지 평가하기 어려워요. 때문에 코스 매니저가 이 둘 사이에 다리를 놓는 중재자의 역할을 하기 위해서는 다양한 시각에서 볼 수 있는 균형 감각이 필요하다고 생각해요.최고의 실력자들과 함께 일하며 프로덕트의 처음부터 끝까지를 만드는 경험을 통해서 사람들의 성장을 돕는 가치를 창출하고 싶으신 분이라면,>> 코스 매니저에 도전해 보세요! <<#엘리스 #코딩교육 #교육기업 #기업문화 #조직문화 #서비스소개 #팀원인터뷰 #팀원소개
조회수 6364

유용한 Javascript UI Component 라이브러리 소개

웹 애플리케이션을 개발할 때 기능적으로는 무관하지만, 사용자에게 인터렉티브하고 심미적으로 예쁜 디자인을 제공하고 싶은 경험이 있을 것입니다. 하지만 막상 직접 구현을 하는 것은 생각보다 시간이 오래 걸리고, 구현하더라도 양질의 UI가 나오지 않는 경우들이 있습니다. 그래서 이번 글에서는 쉽고 빠르게 양질의 UI를 제공해주는 라이브러리를 소개해 드리려고 합니다.Spin.js작업을 완료하거나 페이지가 넘어갈 때 아무런 말도 없이 그냥 기다리는 경우가 있습니다. 이럴 경우 사용자에게 현재 기다리는 중이라는 것을 표현하는 것이 좋습니다. 이러한 기능을 제공해주는 라이브러리가 바로 Spin.js입니다.Spin.js는 위의 그림과 같이 로딩 중이나 무언가를 진행 중이라는 것을 알려주는 사용하기 쉬운 Javascript 라이브러리입니다. 이미지 없이 사용되어 매우 가볍게 사용할 수 있습니다. 그리고 사용할 때 쉽게 설정하여 사용할 수 있으며 대다수 브라우저를 지원합니다.Spin.js / DownloadDatatables많은 양의 정보를 쉽게 볼 수 있도록 테이블로 정리해야되는 경우가 있습니다. 그러나 많은 양의 정보를 처리할 때 쉽게 원하는 정보를 찾을 수 있어야 하고 정보가 쉽게 정렬이 될 수 있어야 합니다. 이러한 기능을 제공해주는 라이브러리가 바로 Datatables입니다.Datatables는 위의 그림과 같이 테이블을 동적인 테이블을 만들어주는 JQuery Javascript 라이브러리입니다. 다양하게 정렬할 수 있도록 테이블을 만들수 있으며, 따로 정보를 찾아주는 기능을 만들어주지 않아도 검색을 할 수 있는 기능을 제공하고, 정보를 편하게 볼 수 있도록 구성을 제공합니다. 그리고 DOM, Ajax, Server-Side Processing으로 쉽게 정보를 Datatables로 만들 수 있습니다.DatatablesCurtain.js긴 내용으로 된 하나의 페이지를 섹션별로 효과적으로 내용을 전환해야 되는 경우가 있습니다. 그러나 사용자에게 혼란을 주지 않으면서 전환 효과를 만들어 내야 합니다. 이러한 기능을 제공해주는 라이브러리가 바로 Curtain.js입니다.Curtain.js는 위의 그림과 같이 마치 커튼이 걷히는 것처럼 내용 전환 효과를 주는 JQueryJavascript 라이브러리입니다. 각 내용을 화면에 고정하고 스크롤이나 키보드를 통해 화면을 전환하여 트렌디하면서 인터렉티브한 느낌을 쉽게 제공할 수 있습니다.Curtain.js / DownloadTurn.js위의 Curtain.js가 세로형태의 전환 효과를 내는 것이었다면 가로형태의 전환 효과를 내야 하는 경우가 있습니다. 이러한 기능을 제공해주는 라이브러리가 바로 Turn.js입니다.Turn.js는 위의 그림과 같이 책장을 넘기는 듯한 내용 전환 효과를 주는 JQuery Javascript 라이브러리입니다. 하나에 페이지를 섹션별로 나눠서 키보드를 통해 화면을 전환하여 책장을 넘기는 느낌을 제공해 스마트폰이나 태블릿에서 책을 읽는 듯한 느낌을 쉽게 제공할 수 있습니다.Turn.js / DownloadGlfx.js이미지를 따로 수정해서 올리는 것이 아니라 웹에서 바로 밝기를 조정하거나 다양한 효과를 주고 싶은 때도 있습니다. 이러한 기능을 제공해주는 라이브러리가 바로 Glfx.js입니다.Glfx.js는 위의 그림과 같이 다양한 효과를 주는 WebGL기반의 Javascript 라이브러리입니다. 이미지에 Blur 효과, 세피아, 밝기 조절, 모자이크처리 등 다양한 효과를 다양한 설정을 통해 쉽게 사용 할 수 있습니다. 그러나 WebGL 기반으로 되어 있어서 WebGL을 지원하는 브라우저만 가능합니다.Glfx.js / DownloadJQuery Tag-it태그를 넣을 때 쉽게 수정 가능하게 하고 자동완성기능을 넣고 싶은 때도 있습니다. 이러한 기능을 제공해주는 라이브러리가 바로 JQuery Tag-it입니다.JQuery Tag-it은 위의 그림과 같이 태그에 대한 JQuery Javascript 라이브러리입니다. 쉽게 태그를 넣고 지울 수 있으며 태그에 대해 자동완성 기능을 지원합니다. 그리고 각 태그에 대해 이벤트를 줄 수 있어서 매우 유용하게 사용하실 수 있습니다.JQuery Tag-it / DownloadTinycon새 글의 개수나 접속자 수에 대한 정보를 사용자에게 알리고 싶은 때도 있습니다. 이럴 경우 브라우저 탭에 정보를 제공하는 경우가 있습니다. 이러한 기능을 제공해주는 라이브러리가 바로 Tinycon입니다.Tinycon는 위의 그림과 같이 파비콘에 동적인 숫자를 통해 정보를 알리는 Javascript 라이브러리입니다. 매우 쉽게 사용할 수 있으며, 설정을 통해 어떤 내용을 숫자로 표현할 것인지를 쉽게 사용자화 할 수 있습니다. 파비콘에 경우 브라우저 탭에 항상 보이기 때문에 아주 유용하게 사용할 수 있을 것 같습니다. 그러나 현재 크롬, 파이어폭스, 오페라 브라우저만이 지원 가능합니다.Tinycon / Download3D GALLERY사진이나 슬라이드 탭을 보여주기 위해 갤러리 공간을 만듭니다. 그래서 좀 더 효과적으로 보여주기 위해 다양한 효과를 넣는 경우가 있습니다. 이러한 기능을 제공해주는 라이브러리가 바로 3D GALLERY입니다.3D GALLERY는 위의 그림과 같이 내용을 3D로 나열해 보여주는 JQuery Javascript 라이브러리입니다. 간단한 설정으로 3D로 배치하고 움직이도록 할 수 있습니다. 그리고 자동으로 내용을 넘어가게 할 수도 있고 다양하게 바뀌는 효과를 줄 수 있습니다.3D GALLERY / Demo글을 마치면서이번 글에서는 UI Component Javascript 라이브러리들에 대해 알아봤습니다. 위의 라이브러리로 좀 더 쉽고 빠르게 양질의 웹 애플리케이션을 개발할 수 있었으면 좋겠습니다.#스포카 #개발자 #디자이너 #협업 #Javascript #라이브러리 #꿀팁 #유용한정보

기업문화 엿볼 때, 더팀스

로그인

/