스토리 홈

인터뷰

피드

뉴스

조회수 517

오픈서베이 개발팀이 일하는 법, 개발자에게 직접 들어봤습니다

김경만님은 오픈서베이의 미들레벨 안드로이드 개발자이자 오베이 시스템 PM(이하 조셉)입니다. 지인 추천으로 2명의 개발자 채용을 도운 오픈서베이 전도사기도 하죠. 이런 조셉은 지원할 때만 해도 오픈서베이가 어떤 회사인지 잘 몰랐다고 합니다. 병특 중인데 TO가 있길래 지원한 게 크죠. 그렇게 덜컥 입사한 오픈서베이를 다니며 잘 갖춰진 업무 환경, 조직 문화, 좋은 구성원에 반해버렸다고 합니다. 병특 복무를 마친 뒤에도 오픈서베이의 훌륭한 구성원으로 5년 차 개발자의 커리어를 쌓아가고 있죠. 조셉에게 오픈서베이에 반한 이유와 개발팀의 업무 문화에 대한 이야기를 들어봤습니다.            오픈서베이 김경만(조셉) 안드로이드 개발자 겸 오베이 앱 PM   조셉, 안녕하세요! 안녕하세요(웃음). 오픈서베이의 미드레벨 안드로이드 개발자 조셉입니다. 올해부터는 오베이 앱 PM으로 역할이 확대됐어요. 오베이는 오픈서베이 패널로 활동할 수 있는 설문조사 앱입니다.   세부적으로는 안드로이드 오베이 앱 개발, 오베이 회원계 시스템, 타겟팅 설문을 위한 유저 세그멘테이션 시스템을 개발·운영하고 있어요. 5년 차 개발자로 오픈서베이에는 17년 12월에 입사해서 벌써 1년 반 정도 일하고 있네요.    입사 계기가 독특하더라고요. 고백하자면 그렇죠. 전 직장에서 병특 복무 중에 이직을 결심하고 원티드에서 오픈서베이를 처음 알게 됐어요. 사실 뭐하는 회사인지도 잘 몰랐고 병특 TO가 있으니까 그때부터 찾아본 거예요.  잡플래닛을 검색해보니 ‘리서치 업계의 게임 체인저’라는 리뷰가 뜨더라고요. 실은 그 말이 정확히 무슨 의미인지도 잘 몰랐어요. 그냥 리서치란 단어가 주는 스마트하고 긍정적인 느낌이 있었는데 “그런 리서치 시장의 게임 체인저라니!”라며 면접을 본 거에요.   그럼 오픈서베이를 다니면서 긍정적인 면을 발견하신 거군요. 일단, 개발 업무 환경이 수준급이라 놀랐어요. 규모가 좀 있는 기업에서나 볼 수 있는 인텔리제이(intellij)도 너무 당연하게 구비돼 있더라고요. 이게 꽤 비싼 툴이거든요. 그래서 스타트업은 개발자 채용 공고에 인텔리제이 구매해서 사용한다고 일부러 적어놓기도 할 정도예요.  그런데 오픈서베이는 입사 때 따로 이야기해 주지 않아서 몰랐는데 떡하니 있길래 놀랐죠. whatap, jenkins, graylog 등을 이용한 배포·운영·모니터링 환경도 체계적으로 갖춰져 있었고요.  사실 이런 개발 환경을 갖춘 스타트업은 정말 흔치 않아요. 그래서 많은 개발자 꿈나무들이 큰 기대를 갖고 스타트업에 입사했다가 좌절해요. 앞에선 기술 중심의 혁신을 외치는데 그만큼의 투자가 없거나 여건이 마련돼 있지 않아서요. 여전히 많은 스타트업 개발자가 수작업으로 일일이 버그 모니터링을 하거나 업데이트 배포를 하는 경우도 많아요.  그런데 구비된 툴을 보면서 오픈서베이 개발팀은 생산성을 위한 비용 투자를 아끼지 않고 구조적인 개발 시스템에 노력하는 회사라는 인상을 받았어요. 개발 입문서 같은 데서 정석이라는 시스템을 그대로 갖추고 있으니까 제가 배운 이론을 현장에 바로 적용할 수도 있는 것도 좋았고요.   무엇보다 일에 집중할 수 있는 환경이군요.  이건 좀 개인적이긴 한데, 입사 전에 업무용 랩탑 선택권을 주는 것도 좋았어요. 사실 랩탑은 일할 때 제일 자주 많이 쓰는 도구잖아요. 업무에 가장 중요한 요소라고도 말 할 수도 있는데, 각 랩탑 사양을 정말 세부적으로 알려주고 원하는 걸 직접 선택할 수 있게 해주는 부분도 인상적이었어요.   그런데 후보 중에 제가 꼭 사고 말겠다고 생각했던 꿈의 랩탑 ‘델 XPS 15’이 있더라고요. 벌써 1년 반이나 지났는데 아직도 이 랩탑으로 일할 때는 괜히 기분이 좋아요.    “업무용 랩탑 선택권을 주는 것도 좋았어요. 사실 랩탑은 일할 때 제일 자주 많이 쓰는 도구잖아요.”   세세한 부분에서도 감동을 받으셨군요(웃음). 이렇게 디테일한 요소까지 챙기는 회사의 모습에 감동하는 거죠. 저는 오픈서베이가 3번째 직장이라서, 회사가 업무 환경에 디테일하게 신경 쓰는 게 얼마나 힘든지를 몸소 경험해서 알고 있거든요. 그런 면에서 오픈서베이는 개발 환경도 잘 갖춰져 있고, 업무를 위한 투자도 많고, 배울 사람도 많아요.   원티드에는 오픈서베이가 어떻게 소개되고 있을까요?   여건만 좋다고 다 좋은 회사는 아닐 수 있잖아요. 물론이죠. 근데 오픈서베이는 여건뿐만 아니라 성장 기회가 많아요. 의욕만 있다면 아직 주인을 찾지 못한 일들을 자신의 것으로 만들 수 있죠. 저는 주도적으로 일할 의지가 있는 구성원이 마음껏 역할을 늘려 갈 수 있는 조직이 긍정적인 면이 많다고 생각해요. 하고 싶은 사람이 그 일을 맡는 거니까요.   이런 면은 주니어나 미들레벨 개발자에게는 좋은 성장 기회가 되는 것 같아요. 제가 오베이 안드로이드 개발자에서 PM으로 역할이 확대되는 과정도 그랬어요. 처음에는 진짜 딱 개발만 했거든요. 운영 장애가 생겨도 저는 제가 개발한 요소의 코드만 아니까 다른 분야는 해결법도 모르고 제 역할도 아니니까 어쩔 줄 몰라 하며 지켜만 봤어요.  그런데 매번 아무것도 할 수 없는 상황에 놓이니까 제가 직접 문제를 해결할 수 있는 사람이 되고 싶어졌어요. 그때부터 오베이 앱 관련 코드를 다 까보면서 시스템 흐름을 파악했고, 장애가 발생했을 때 제가 해결할 수 있는 범위를 차근차근 늘려갔어요. 나중에는 노후한 시스템을 제가 만든 시스템으로 교체까지 했고요. 그러다 오픈서베이 CTO인 폴의 제안으로 올해부터 PM을 맡게 됐습니다.    조셉이 오베이 PM이 된 배경에는 그런 성장 스토리가 있었군요! 주도적으로 일하는 경험은 다른 회사에선 쉽게 얻기 힘든 기회라는 점은 정말 동의해요. 맞아요. 빠른 성장을 원하는 분에게 지금 오픈서베이는 딱 좋은 규모의 회사인 것 같아요.  정말 개발 인력이 적고 여건이 좋지 않아서 어쩔 수 없이 역할을 확대한 게 아니라, 좋은 여건과 환경에서도 빠르게 역할을 확대할 수 있는 단계에 이른 것 같아서요. 더 규모가 크고 탄탄한 회사에서는 사실 주도적으로 일하고 싶어도 환경이 따라주지 않는 경우도 많으니까요.  물론, 역량과 성취에 따라 합당한 보상을 해줘야 구성원들이 적극적이고 주도적으로 일하고 싶은 의욕이 생긴다는 생각도 하는데요. 제 경험에 비춰보면 오픈서베이는 일이 늘어나는 만큼 보상도 확실한 것 같아요(웃음).    “주도적으로 일할 의지가 있는 구성원이 마음껏 역할을 늘려 갈 수 있는 조직이 좋아요. 하고 싶은 사람이 그 일을 맡는 거니까요”     그런 좋은 경험 덕에 병특 이후에도 오픈서베이를 지켜주시는 거군요. 잘 몰랐는데 병특 복무가 끝나면 곧장 이직하는 게 훨씬 흔하다면서요?  맞아요. 더이상 그 회사에 묶여 있을 필요가 없으니 더 처우 좋은 회사를 찾아 떠나는 거죠. 저는 일부러 남았다기보다는 딱히 이직할 이유가 없어서 이직을 고려하지 않았다는 게 맞는 말인 것 같아요. 개발 업무 환경도 잘 갖춰져 있고 회사도 성장하고 있고, 무엇보다 보상 기준도 체계적이라고 생각하니까요.   보상 기준이 체계적이라고 생각하는 이유가 있나요? 개발팀에서 상하반기를 나눠서 1년에 2번씩 이뤄지는 성장진단을 해요. 단순한 연봉 협상이 아니라 정말로 제가 한 일을 돌아보면서 얼마나 성장했고 성취를 이뤘는지 상급자와 점검해보는 시간이에요. 사실 전 제 개인 블로그에 매달 1번씩 업무 성과 회고를 하거든요. 아무래도 명확한 독자가 없으니까 좀 캐주얼하게 쓰는 편이에요. 근데 회사 성장진단 문서는 내용은 같아도 독자가 다르니까 자연스럽게 자기객관화를 하면서 성과와 시행착오를 정리할 수 있는 시간이라 좋더라고요. 특히, 폴(이건노 CTO)은 이스트소프트에서 개발 조직을 오래 리딩하셔서 확실히 조언의 깊이가 달라요. 저는 아무래도 시야가 아직 넓지 않아서 개발 업무를 성능과 기술 중심으로만 대해요. 그런데 폴은 방대한 시각으로 비즈니스나 운영 관점에서 서비스가 확장될 때를 미리 계산해서 조언을 해주셔서 좋았습니다.   오픈서베이와 스타트업 얼라이언스가 함께한 ‘2018 스타트업 트렌드 리포트’를 보면, 재직자들이 스타트업에 가장 만족하는 요인은 ‘빠르고 유연한 의사결정 구조’였어요. 조셉 생각에 오픈서베이는 어떤가요? 자의적으로 해석할 여지가 많은 요소네요. 빠르고 유연한 의사결정 구조를 개발자 맘대로 하는 거라고 생각할 수 있으니까요. 그렇게 생각한다면 오픈서베이는 전혀 그런 회사는 아닌 것 같아요. 모든 의사결정은 전후 사정이나 논리적인 타당성을 따져보고 함께 결정하니까요.  대신 결정할 사안에 대한 논의는 정말 빠르고 유연하게 이뤄져요. 최고 결정권자인 하이(황희영 대표이사)와 논의가 필요하다고 생각되면 물어봐서 일정만 잡으면 얼마든지 1:1 미팅을 할 수 있어요. 대표실이 따로 있는 게 아니라 한 공간에서 같이 일하니까 몇초 걸어가서 바로 물을 수도 있고요. 대표이사와 이렇게 쉽게 이야기 나눌 수 있다는 점도 오픈서베이의 장점이죠.    “빠르고 유연한 의사결정 구조를 개발자 맘대로 하는 거라고 생각한다면, 오픈서베이는 그런 회사는 아니예요. 모든 의사결정은 전후 사정이나 논리적인 타당성을 따져보고 함께 결정하니까요.”   업무 영역을 넓힐 기회뿐만 아니라 발언 기회도 열려있다는 의미일까요? 정확해요. 개발팀에 ‘세미나’라는 제도가 있어요. 주간 회의와 별도로 팀에 공유하고 싶은 내용이 있는 구성원이 자발적으로 발표를 하는 시간이에요. 특정 프로젝트를 하면서 깨달은 점이나 노하우를 공유하는 식이죠. 저는 이런 세미나가 특히 주니어에게는 아주 좋은 발언 기회라고 생각해요.  사실 작년에 제가 ReactiveX와 Reactive System을 좋아해서 공부하고 있었어요. 당연히 오픈서베이 개발팀에도 도입하고 싶었죠. 근데 팀에 리액티브X를 다루던 분이 없어서 도입 시 이득에 대한 공감대가 없었어요. 그래서 세미나를 활용해서 , <리액티브 시스템으로 설문 서비스 구축하기>라는 주제로 두 차례 발표했어요.  당시에는 발표한다고 진짜 리액티브 시스템을 도입할 수 있을까 생각했어요. ‘필요하니 돈 내고 사자!’라며 간단히 설득할 수 있는 사안이 아니었거든요. 리액티브 시스템은 말하자면 개발 패러다임, 업무 방법론이에요. 개발 업무를 아무도 하지 않았던 새로운 방법으로 바꾸자는 얘기니까 팀 차원에서는 훨씬 복잡하고 신중한 의사결정이 필요한 사안이었죠.    조셉에게 세미나는 그런 중요한 사안을 건의할 기회의 장이었군요. 결국 도입은 성공했나요? 네(웃음). 덕분에 오베이 앱은 RxJava를 활용해 개발했어요. 이후 설문 서비스 개발을 담당하는 테리(이한별 개발자)는 리액티브한 방식으로 내부 파일 관리 시스템을 만들었어요. 정말로 저 혼자만 아니라 팀에서도 활용 가능한 개발 방법론이 된 거죠. 생각해보면 입사한 지 1년도 안 된 개발자가 팀에 새로운 업무 방법론을 도입하자는 발언권을 가질 수 있다는 점 자체가 오픈서베이 개발팀의 업무 문화와 일하는 방법을 단적으로 보여주는 예시 아닐까 싶어요.    마지막으로 오픈서베이의 예비 구성원분들께 한마디 부탁드립니다.  저는 오픈서베이를 다니면서 좋은 구성원들에게 자극을 받고 더 성장하기 위해 노력하게 된 것 같아요. 사실 제가 학창시절 때 꿈이 프로게이머였을 정도로 게임을 좋아해요. 회사 다니면서도 다른 시간 다 줄여도 게임하는 시간은 못 줄였을 정도로요.  그런데 좋은 업무 환경과 동료들, 성장 기회, 그리고 확실한 보상까지 고루 갖춘 회사에 다녀보니 더 좋은 사람이 되고 싶다는 생각이 들더라고요. 다른 동료들처럼 훌륭한 사람이 되고 싶어서 말이죠. 그래서 요즘은 그 좋아하던 게임도 접어두고 자기 계발에 몰두하고 있어요.  단순히 높은 연봉이나 좋은 복지가 아니라 함께 성장하고 싶은 예비 구성원분들의 많은 지원을 기대합니다!      “조셉과 함께 일하고 싶으시다면 지금 바로 오픈서베이 입사 지원을 해보세요”  
조회수 1169

Team Profile: Meet Yonghyun

Read In KoreanAs a yet minuscule startup, each member holds a significant power over the overall atmosphere of the team. And in our ultimate quest to make big waves in the data world, we need to make sure that the people at the helm are at least kind of cool. We think we’ve done a pretty good job so far in assembling a society of unique but equally driven members.So we bring you this seven-part series, one of each devoted to interviewing each of our members in detail, to give you an in-depth glimpse into the people responsible for bringing you the future of machine learning with Daria. Plus, we peppered the interviews with questions from Dr. Aron’s “The 36 Questions that Lead to Love”*, cherry picked to make work appropriate and concise, but interesting.(*actually falling in love with our members highly discouraged)Yonghyun joined the XBrain team in August as a software engineer, and has worked closely with other members in constructing the software that Daria runs on. But his interests run beyond just making sure that Daria become the future star of machine learning and data science — Yonghyun is also an avid soccer player, and an enthusiastic dabbler of virtual and artificial reality. Learn more about him here!Yonghyun saves a few minutes of his day for some introspection/staring broodily out the windowHi Yonghyun! Start by telling us about your role.YH: I work with JM as a software engineer at XBrain, developing and testing our software infrastructure.How do you usually spend a work day?YH: I usually come to work around lunchtime, and devote my time to whatever needs to be done for the day. Today we worked on tests involving transferring data from MS SQL. I enjoy afternoon walks sometimes, and usually head home after working a little post-dinner.Tell us about the parts of your job that you most enjoy.YH: I enjoy transforming machine learning modules into Spark to fit with the cloud system, and looking at the code Suzin’s written in order to understand the process.What about the aspects that you least enjoy or find challenging?YH: Setting up the environment to test our systems is something I least enjoy. It’s frustrating, because you can follow all the steps and still go the wrong way.Pick one item on your desk that tells us something about you.YH: I don’t have a whole lot on my desk…so I would probably have to say my laptop. The very very big laptop provided to me by the company.Laptop in photo is larger than it appearsWhat made you want to become a software engineer?YH: I was originally majoring in History in college, but I was struck by how computer science could help you create something tangible. Programming helps turn your ideas into reality on the screen, which is something I was really drawn to.So why XBrain?YH: As an incoming programmer, you don’t really come across the opportunity to participate in the making of a product that’s still under development. It’s a good learning experience for me to watch Daria’s progress. Furthermore, because I started programming at a relatively later stage, I still need help with my mathematical background, which working here allows me to do.As the one of the newest additions to the team, tell us about your vision for XBrain.YH: I think my vision is one of becoming a household name for a machine learning tool that a lot of people use on the daily — Daria doing useful things in every facet of the world, big or small.What is your go-to work playlist?YH: When I’m coding, I usually prefer EDM, so stations like Hardwell On Air, and hip-hop as well.Recommend a movie for our next Cinema Society, please.YH: Watchmen (2009). Its protagonist Rorschach is an anti-hero, and the plot line is complex and interesting to follow.Where do you see yourself 10 years from now?YH: Career-wise, honestly I wouldn’t mind what I have right now — working a job that I love without getting too swamped with deadlines, with plenty of time for exercise and socializing, playing soccer with my friends.Given the choice of anyone in the world, whom would you want as a dinner guest?YH: Mark Zuckerberg, maybe? I’d like to hear about his ideas for the future.If you had to have dinner with one XBrain member, who would it be and why?YH: JP, our new machine learning engineer. I’d like to get to know him better, and he seems like an interesting person.Would you like to be famous? In what way?Nope.What would constitute a “perfect” day for you?YH: A day productive enough that I could go to bed without worrying about the next day.If you were able to live to the age of 90 and retain either the mind or body of a 30-year-old for the last 60 years of your life, which would you want?YH: The body of a 30 year old… I don’t think that youth isn’t everything when it comes to minds.For what in your life do you feel most grateful?YH: The privilege to have been able to learn and achieve everything I’ve wanted is something I’ll always be thankful for, and also the flexibility to be able to change directions I’m headed in.If you could wake up tomorrow having gained any one quality or ability, what would it be?YH: I’ve always wanted more drive to carry out the projects I’ve devised in my head, the ability to see things through no matter what.Is there something that you’ve dreamed of doing for a long time? Why haven’t you done it?YH: I’ve always wanted to learn how to cook. I lived in a dorm in college so I didn’t have the opportunity then, but now would be a good time as any.What is the greatest accomplishment of your life?YH: I would say my greatest accomplishment is putting my best efforts into learning and improving my mind, inside and outside of school.What is your most memorable XBrain moment?YH: My fondest memories are usually of events we held outside — the hike we went on in September, or the soccer game we had. I like that we got to bond as a team and get some exercise.If you knew that in one year you would die suddenly, would you change anything about the way you are now living? Why?YH: I haven’t been able to get decent sleep recently, so I’d probably give myself some time to rest.If you were going to become close friends with someone, please share what would be important for him or her to know.YH: I don’t have very strong likes or dislikes, so I usually get along with most people.What, if anything, should never be joked about?YH: You should never joke about the disadvantaged, or others’ insecurities.If you could sum up XBrain in three words or less?YH: Freedom. Consideration. Learning…. Is that too serious?#엑스브레인 #팀원소개 #팀원인터뷰 #기업문화 #조직문화 #팀원자랑
조회수 1895

Infrastructure dashboard

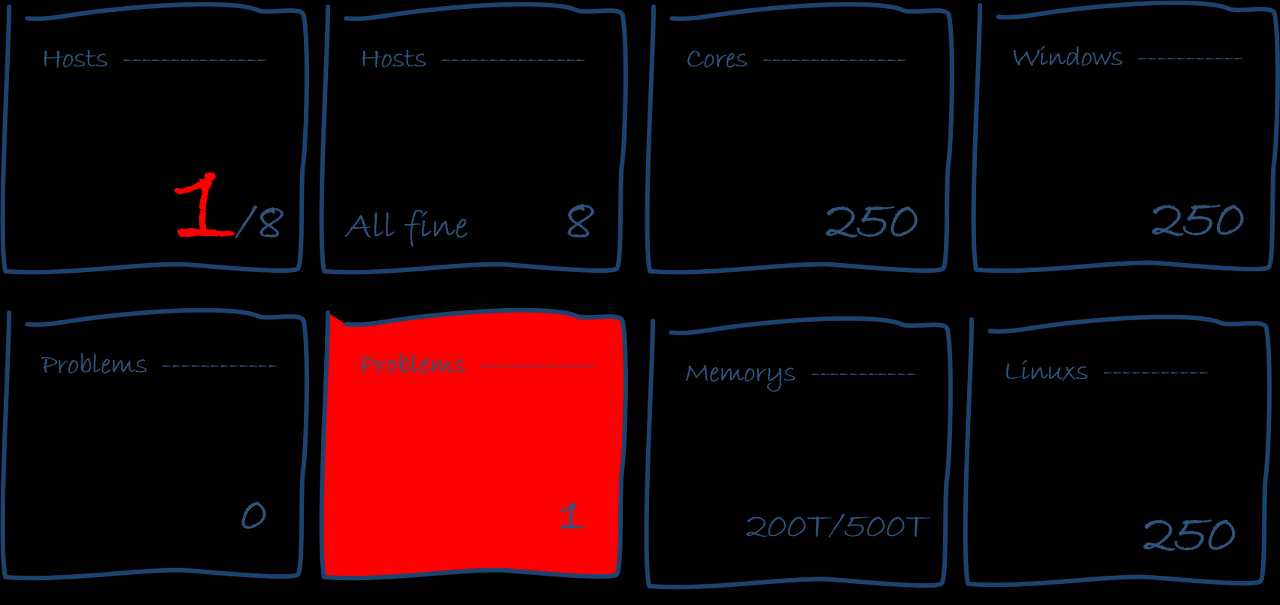
와탭랩스는 IT 서비스를 운영하는 개발팀과 운영팀에 도움이 되는 솔루션과 서비스를 만드는 스타트업입니다. IT 서비스를 잘 운영하게 위해서는 Infrastructure의 전반적인 상황을 항시 체크할 수 있어야 하는데요. 이런 기능을 하는 대표적인 화면이 대시보드 입니다. 최근 와탭랩스는 Infrastructure 모니터링 서비스에 대시보드를 넣는 작업을 진행하고 있는데요. 와탭랩스는 대시보드를 통해 Infrastructure를 운영하는 개발팀과 운영팀에 어떻게 도움을 줄 수 있도록 할 것인지 소개하겠습니다. 1. IT 서비스 운영에 사용된 인프라 자산 현황을 알아보자지금 회사에서 사용하는 서버의 대수를 알고 계신가요? 현재 동작하는 서버는 몇대인지 혹시 죽어있는 서버가 있는지 등에 대한 정보는 운영팀에서 항상 체크하는 정보입니다. 하지만 개발팀에서는 잘 모르는 정보이기도 하죠. 이런 기본적인 정보가 대시보드에 나온다면 평소 서비스를 운영하는 감을 잡는데 도움이 됩니다. 이런 정보들은 간략한 수치로도 표현할 수 있는데요. 우리는 아래와 같은 데이터를 수집할 수 있습니다. 서버 기본 정보 (inactive servers / all servers)우리가 사용하는 총 서버의 수자와 비활성화된 서버의 숫자는 우리가 항상 알고 있어야 하는 정보입니다.운영체계별 서버 정보 (Linux / Windows / Unix)운영체계를 섞어 사용하는 경우에는 운영체계에 따라프로젝트가 나눠지기도 합니다. 그렇기 때문에 운영체계별로 서버의 총량과 비활성화된 서버 정보를 알면 도움이 됩니다. 프로세스 수프로젝트의 프로세스 수는 일정한 경우가 많습니다. 전체 프로세스의 숫자가 변경된다면 서비스의 운영 상황에 대해 의문을 가져야 합니다. 이벤트 개수24시간동안 발생한 전체 이벤트의 개수와 아직 해결하지 못한 이벤트의 개수를 보여줍니다. 하루동안 얼마나 많은 이벤트가 발생하는지 그리고 아직 해결하지 못한 이벤트가 있는지 알수 있습니다. 디스크 사용량/전체 용량디스크 사용량은 일반적으로 큰 변화를 가지지 않습니다. 디스크 사용량이 평소와 다르다면 서비스의 장애가 발생했거나 발생할 가능성이 높습니다. 메모리 사용량 / 전체 용량메모리 사용량은 일반적으로 큰 변화를 가지지 않습니다. 메모리 사용량이 평소와 다르다면 서비스의 장애가 발생했거나 발생할 가능성이 높습니다. 수치 데이터의 예 2. 서비스를 구성하는 인프라의 CPU 흐름 전체를 알아보자 CPU 사용량은 변화량이 많은 지표입니다. 변화량을 비교하는 챠트로는 라인 차트가 가장 많이 쓰이지만 라인 차트는 개수가 많아지면 전체 상황이 보이지 않는 문제점을 가지고 있습니다. 또한 실시간으로 추가되거나 삭제되는 인프라가 생기는 클라우드 인프라 상황에서 라인챠트는 표현의 한계를 가지고 있기도 합니다. 이런 문제를 해결하기 위한 방법으로 아래와 같은 온도 차트를 사용할 수 있습니다. 온도 차트는 단위 영역에 밀도에 따라 색상으로 깊이를 표현하는 방식입니다. 최근 많은 양의 데이터를 표현하는 방식으로 많이 사용되고 있습니다. 온도 차트의 예3. 경고가 발생했는지 또는 해결 되었는지 알고 싶다.  CPU 사용량이 설정치 이상으로 높아지거나 디스크 사용량이 높아지거나 프로세스가 사라지는 등 다양한 상황에 대한 이벤트가 발생할 수 있습니다 이런 상황을 쉽게 확인할 수 있다면 서비스 운영 상황에 도움이 됩니다. 이벤트 관리의 예이런 스토리를 기반으로 와탭랩스에서 대시보드를 기획하고 있습니다. 개발자와 디자이너가 함께 토론하고 논의하면서 화면과 스토리를 더 다듬게 되면 첫번째 화면이 나올 예정입니다. 아래는 기획과정에서 나온 화면 리소스 입니다. 아직 기획 단계이기는 하나 첫번째 대시보드가 완성되면 이 페이지가 메인으로 올라갈 예정입니다. 대시보드는 데이타의 종류와 위치등을 수정할 수 있으면 좋지만 우선은 고정형으로 개발하여 제공할 예정입니다. 이번 대시보드는 서비스 첫번째 의미가 강한 메인 화면의 성격에 더 초점을 맞추고 있습니다. 아직 몇몇 논의되는 사항이 많은 화면이지만 빠르게 개발하여 가능한 이른 시일에 소개드리도록 하겠습니다. #와탭랩스 #개발자 #개발팀 #인사이트 #경험공유 #일지
조회수 1519

새로운 슬로건도, 어반베이스답게

기업의 슬로건은 기업의 이미지를 좌우할만큼 중요하다고 할 수 있습니다.나이키의 'Just Do It' 이나 아디다스의 'Impossible Is Nothing'과 같이 대중의 머릿속에 이미지 그 자체로 각인될 수 있기 때문이죠. 어반베이스가 3D 공간데이터 플랫폼으로서 전 세계의 모든 실내공간정보를 자유롭게 활용할 수 있는 코어 기술과 서비스를 런칭하게 되면서 미래를 향한 메시지를 내포할 수 있는 새로운 슬로건을 만들게 되었습니다. 어반베이스는 과연 어떤 방법으로 새로운 슬로건을 만들었을까요?슬로건도 '어반베이스'답게 만들다어반베이스는 IT 기술 기반의 스타트업인만큼 직원 중 절반 이상이 개발자입니다.그렇다보니, 출퇴근기록 계산기부터 점심알람봇(bot)까지 일상에서 조금이라도 불편한 점이 있다면 개발자분들이 출동하여 프로그램을 만들어 주시곤 합니다.  이러한 문화를 가지고 있는 어반베이스는 슬로건 만드는 방법 또한 '어반베이스'답게 만들어 냅니다. 슬로건에 대한 다양한 아이디어를 얻기 위해 어떤 방법이 좋을지 고민하다가, 진우님(진우님=대표님=건축가 출신 프로그래머)께서 룰렛 하나를 만들었습니다. 같이 살펴볼까요?만들어 공유해 주신 링크를 타고 들어가면 이렇게 깔끔한 룰렛하나가 나오는데요참여방법은 간단합니다.1. 랜덤버튼을 2회 누르면 문장이 완성됩니다. 마음에 드는 문장이 나타나면 아래의 세이브 버튼을 누릅니다. 그 리고 그 문장은 저장되어 하단의 그래프로 반영이 됩니다. 'RANDOM'버튼을 한 번 눌러보았더니 클릭 두번에 슬로건 하나가 탄생합니다.'We Generate Urban'조금 더 나은 슬로건을 위해 RETRY 해 봅니다.이번엔'We Reform The Next World' 가 탄생했습니다.2. 그래도 마음에 드는 문장이 안나오면 보라색 '후리스타일' 버튼을 누르셔서 직접 입력해주시면 우측 리스트에 반영됩니다. (무기명입니다)'후리스타일' 버튼을 누르고 입력한 문장들입니다.이렇듯, 룰렛을 사용해 간단하고 간편하게 많은 문장들을 만들어냈습니다. 몇몇 단어를 가지고 고민하는 것보다, 룰렛을 최대한 많이 돌려서 저장하는 방법을 선택했습니다. '이런식으로도 슬로건을 만들 수 있다니' 재미 반 진지 반으로 어반피플들이 모두 참여하여 슬로건 짓기에 동참했습니다.그러하여 나온 최종 두 가지 안 입니다. We Invent the Next WorldWe Reinvent the World우리는 이 최종 두 가지 안을 가지고 다시 투표를 하였습니다. (다수결의 원칙) 그 결과, 아주 근소한 차이로 우리의 슬로건 탄생!어반베이스의 새로운 슬로건'We Invent The Next World'4차 산업혁명의 시대, 국내 뿐 아니라 전 세계적으로 공간데이터의 높은 활용 가능성에 주목하고 있습니다.3D 공간데이터 플랫폼 어반베이스는 앞으로 “We Invent The Next World” 라는 모토 아래, 보다 앞선 새로운 삶의 모습을 제시하고자 합니다. 2D 도면 이미지를 단 몇 초만에 3차원 공간으로 자동 변환해주는 기술부터가상의 인테리어를 돕는 3D HomeDesign, 3D데이터를 증강현실로 경험할 수 있는 AR Viewer, 머신러닝과 인공지능을 이용한 공간 기반 추천 서비스까지. 전 세계의 모든 실내공간정보를 하나의 플랫폼 안에서 자유롭게 활용할 수 있는 코어 기술 및 서비스를 선보이고자 하오니 많은 기대 부탁드립니다.*2019.01 어반베이스 개발자 사이트 런칭 예정 *2019.02 AR SCALE 런칭 예정출처: https://blog.naver.com/urbanbaseinc 
조회수 7526

HTTP 404 Status Code 에 대한 고찰

뭐가 문제였나필자는 현재 HMR(가정간편식) 커머스를 다루는 모 스타트업에서 백엔드 개발자로 재직 중이다. 말이 백엔드지 최근 변화되고 있는 트렌드에 맞춰 열심히 API 작성 셔틀을 하고 있다.API 개발에 주로 사용하는 HTTP 상태 코드는 주로 200 (정상), 400 (잘못된 요청), 401 (보안 토큰 에러), 403 (권한 없음), 404 (찾을 수 없음) 정도가 있었다.문제는 여기에서 발생했는데, API를 계속 개발해 나가다 보니 API 요청 시 데이터가 없을 때 200 상태 코드에 빈 배열을 돌려주어야 하는지, 404 상태 코드를 돌려주어야 되는지 상황에 따라 다를 수 있겠다는 생각이 들었다.만약 '데이터가 없을 수도 있는 상황'과 '데이터가 없으면 안 되는 상황'에서 404 Not Found 에러 코드로 같게 응답할 경우 다음과 같은 애매한 상황이 펼쳐질 수 있다.API를 사용하는 클라이언트가 404 에러에 대한 대응을 에러로 표시할지 데이터 없음으로 표시할지 상황에 따라 다르게 정의해줘야 한다. 결과적으로 클라이언트에서 API 요청에 대한 처리가 복잡해진다.// front-endimport fetch from 'node-fetch'; function fetchUserList() {  // 유저 목록을 가져오는 API를 사용한다고 가정  return fetch('https://api.exmaple.com/users')    .then((response) => {      if (response.statusCode === 404) {        // 이 404 Http 상태 코드를 에러로 처리할 것인가? 데이터 없음으로 처리할 것인가?        // 에러일 경우 : throw new Error('Not Found');        // 데이터 없음일 경우 : return [];      } else if (response.statusCode === 200) {        return response.json();      } else {        throw new Error('Unexpected Http Status Code');      }    })    .then(result => render(successPage, result))    .catch(error => render(failurePage, error));}결국, 어떤 식으로 표시해야 명확하게 표현할 수 있을까 하여 페이스북 존잘 개발자님들에게 의견을 물었다. # 굉장히 많은 분이 의견을 주셨고 나름대로 생각을 정리할 수 있었다.결론적으로는 '데이터 없음'과 '404 Not Found'를 같은 용도로 사용하면 안 된다.그렇다면 뭘 어째야 하나위에서 나온 결론을 조금 더 자세히 풀어보면 다음 내용이다.상황에 따라 데이터가 없는 것이 정상인 상황이 있고, 데이터가 없는 것이 에러인 상황이 있다. 이를 구분 해야 한다.데이터가 없는 것이 정상일 수 있는 상황// server-sideAPI.get('/orders/date/:date', async (request, response) => {  // 특정 날짜의 주문을 검색. 특정 날짜에 주문이 없을 수도 있다.  const { date } = request.params;  const orders = await Repository.Order.findByDate(date);  // 200: OK  // 204: No Contents  response.statusCode(orders.length > 0 ? 200 : 204).json(orders);});데이터가 없는 것이 에러인 상황API.get('/orders/:orderId', async (request, response) => {  // 특정 ID의 주문을 검색. 데이터가 없으면 에러다.  const { orderId } = request.params;  const order = await Repository.Order.find(orderId);  if (order.length > 0) {    response.statusCode(200).json(order);  } else {    // 404: Not Found    response.statusCode(404).json({      message: `${orderId} is Not Found`    });  };});그렇다면 요청한 API 리소스가 없는 경우에는 어떤 에러를 보여줘야 하는가? 일반적으로는 404 Not Found 가 통상적으로 사용되지만 우리는 이미 404를 다른 용도로 사용하고 있다. 다행히도 HTTP 상태 코드에는 501 Not Implemented 이라는 좋은 친구가 있다. 이 친구를 사용할 수 있다.import { Users, Orders } from './Routes'; app.route('/users', Users);app.route('/orders' Orders);app.all('*', (request, response) => {  // 501: Not Implemented (구현되지 않음)  response.statusCode(501).json({    message: 'This Method is Not Implemented',  });})대충 이 정도면 클라이언트는 Http 상태 코드를 보고 다음 로직을 처리할 수 있을 것이다.물론 일반적으로 사용되는 상태 코드들이지만 실제 개발 진행 시에는 클라이언트를 개발하는 개발자와 미리 어떤 상황에서 어떤 상태 코드를 보낼 것인지 정해야 할 것이다.마무리API 개발 시 사용할 법 직한 응답 코드를 정리해보았다.200: OK (정상, 데이터 있음)204: No Contents (정상, 데이터 없음)301: Moved Permanently (리다이렉션)400: Bad Request (실패, 클라이언트에서 넘어온 파라미터가 이상함)401: Unauthorized (실패, 클라이언트에서 넘어온 보안 토큰이 이상함)403: Forbidden (실패, 사용자의 권한으로 리소스를 사용할 수 없음)404: Not Found (실패, 데이터가 있어야 하나 없음)410: Gone (실패, 데이터가 있었으나 삭제됨. 이건 굳이...?)500: Internal Server Error (실패, 서버 로직 문제)501: Not Implemented (실패, 없는 리소스 요청)기타 304나 502, 503 등의 상태 코드의 경우 API Application을 작성하는 개발자의 역할보다는 Server 쪽의 역할에 가깝다고 생각하여 작성하지 않음.뭔가 어렵다고 느껴진다면 다음 짤을 참고해서 쉽게 이해할 수 있다. #플레이팅 #개발 #개발자 #인사이트 #경험공유 #조언 #꿀팁 #HTTP #버그 #버그수정 #문제해결
조회수 2398

평균 응답시간의 의미

어플리케이션 성능 분야에서 평균 응답 시간은 어플리케이션 서버가 사용자에게 요청 결과를 반환하는 데 걸리는 시간을 말합니다. 어플리케이션 서버의 응답시간은 일반적으로 밀리세컨드에 가깝지만 부하량에 따라 많은 시간이 걸리기도 합니다. 고객이 기다리는 시간 3초인터넷 초창기인 1999년 전자 상거래 사이트의 최적로드 시간은 8초 였습니다. 2006년도에 들어서는 4초까지 줄어들었습니다. 그리고 지금은 3초를 고객을 떠나게 만드는 시간으로 이야기 합니다. 구글 이 운영하는 더블클릭(https://www.doubleclickbygoogle.com/articles/mobile-speed-matters/)은 모바일 페이지가 로드되는데 3초가 지나면 사용자의 절반 이상이 서비스를 포기한다고 조사결과를 발표했습니다. 3초라는 시간 속에는 웹페이지의 렌더링 시간과 네트웍이 사용하는 시간등이 포함되어 있기 때문에 웹 어플리케이션이 소모해야 하는 시간은 실제로 밀리세컨드에 가깝습니다. 하지만 실제 서비스의 장애가 발생하면서 웹 어플리케이션의 평균 응답시간은 점점 길어지게 됩니다. 성능분석에서 평균 응답시간부하가 늘어나면서 임계치가 넘어가면 초당 처리량은 더이상 증가하지 않게 됩니다. 논리적으로 생각 해보면 초당 처리량이 더이상 증가하지 않은 상태에서 사용자만 늘어나면 TPS와 인지시간이 상수처럼 동작하므로 응답시간이 사용자에 비례하여 늘어나게 됩니다. [응답시간(Respons Time) = [동시사용자수 / 초당 요청수(TPS)] - 인지시간(Think Time)하지만 일반적인 상황에서 응답시간은 밀리세컨드 단위의 값이데 비해 인지시간은 3초에서 10초 이상의 값을 가지고 됩니다. 그럼 이번에는 성능을 분석하는 스토리를 만들어 보겠습니다. 우리가 영어 문장을 한글로 번역하는 웹 서비스를 만든다고 해 보겠습니다. 우리는 동시 사용자 100명을 예상하고 서비스를 만들고 있습니다. 여기서 서비스 특성상 사용자가 한번 번역을 요청하고 다음번 요청을 보내는데 평균 30초의 시간이 걸립니다. 마지막으로 최대 응답시간은 0.5초를 넘지 않도록 설계하려고 합니다. 이런 경우 우리가 목표로 하는 초당 요청수는 서비스를 동시에 사용하는 사람들의 요청을 시간으로 나누므로 계산식은 동시사용자수(100명)/(응답시간(0.5초) + 인지시간(30초)) 이고 결과값은 약 3.27이 됩니다.     초당 요청수(TPS) = 동시사용자수 / [응답시간(Respons Time) + 인지시간(Think Time)]이렇게 성능을 계산하는 과정에서 서비스의 처리시간 즉 응답시간은 인지시간에 비해 매우 적기 때문에 인지시간이 커지면 커질수록 TPS에 관여하는 비율이 0에 수렴하게 됩니다. 결론적으로 성능을 설계하는 시점에서 응답시간은 별로 중요한 이슈가 아니게 됩니다. 대신 인지시간이 중요해 집니다.인지시간(Think Time)이란?웹 서비스를 사용하는 사용자는 자신의 요청을 확인하는 시간이 필요합니다. 이렇게 이전 요청과 다음 요청 사이의 시간을 인지 시간이라고 합니다. 인지 시간은 사용자나 서비스 유형에 따라 다릅니다. 예를 들어 시스템 간 상호 작용은 사람이 관여하는 웹 서비스 상호작용에 비해 매우 낮은 인지 시간을 포함합니다. 또는 블로그 서비스에 비해 사전검색 서비스의 인지시간은 매우 짧을 것입니다. 서비스의 도메인을 분석하여 인지 시간을 결정하는 것은 매우 중요합니다. 인지시간을 사용하여 분당 완료해야 하는 요청 수는 물론 시스템에서 지원할 수 있는 동시 사용자 수를 계산할 수 있습니다. 튜닝 지표로서의 평균 응답시간현실에서 웹 서비스의 응답시간은 수식과 다르게 나타나게 됩니다. 그래서 많은 성능 분석 도구가 평균 응답시간을 보여주고 있습니다. 실제 성능 분석 도구들이 알려 주는 평균 응답시간은 수집 주기 동안에 수집된 트랜잭션의 응답 시간을 합산하여 평균한 값입니다.와탭의 서비스는 5초 간격으로 트랜잭션의 평균 응답시간을 계산합니다. 응답시간이 성능 지표보다 튜닝지표로서의 의미를 가집니다. 예를 들어 사용자가 적은 밤 시간에 배치잡과 같은 일부 응답시간이 길어짐으로써 사용자가 많은 낮보다 평균 응답시간이 더 길수도 있습니다. 하지만 실제 성능을 올리기 지표로써 응답시간은 매우 직접적입니다. TPS와 상관없이 평균 응답시간이 길어지는 요소가 있다면 주변 요소와 함께 평균 응답시간을 살펴봐야 합니다. #와탭랩스 #개발자 #개발팀 #인사이트 #경험공유 #일지
조회수 3150

야놀자 기술 블로그 만들기

Hello world!저는 CX서비스실에서 기획을 담당하고 있는 강미경입니다. R&D 그룹의 기술 블로그, 그 영광의 첫 포스트로 개발의 보람을 대신할 수 있어 기쁩니다. 오늘은 ‘기획자가 어쩌다가’ 기술 블로그를 만들게 되었는지 얘기해보려고 합니다.왜 기술 블로그인가제가 야놀자에 입사한 지 만 1년이 되었습니다. 입사하면서 가진 개인적인 목표 중의 하나는 블로그를 운영하는 것이었습니다. 저는 오래전부터 개인 블로그를 운영하고 있고, 외부 커뮤니티 활동에서도 팀 블로그를 운영합니다. 그래서 개발자에게는 기술 블로그에 쓸 글을 작성하는 것보다 코딩을 하는 게 더 쉬울 정도로, 글 쓰는 고통이 남다르다는 것도 알고 있지요.하지만 ‘알고 있다’고 생각하는 정보를 정리하고 그것이 잘 전달될 수 있도록 하는 것은 개발실력과는 약간은 다른 영역의 것이기도 합니다. 그래서 테크 스웩이 넘치는 블로그가 아니더라도, 꾸준히 스토리를 전달하면 그게 개인과 조직의 히스토리로써의 가치가 충분하다고 생각했습니다. 무엇보다 조직 자체의 성장에 큰 밑거름이 되고요.블로그를 시작해보자기술 블로그를 하자는 말에, 놀랍게도 한결같이 ‘관심만’ 주더군요(…) 평소 업무가 많고 바쁨을 떠나서, 보람보단 책임만 남아 유지보수 대상이 되어버릴 가능성이 무궁하지 않겠습니까. 하지만 목마른 사람이 우물을 파라고, 개발자의 도움 없이 블로그를 만들 각오를 하기에 이르렀습니다.(과거의 나를 규탄…#야놀자 #개발팀 #블로그 #인사이트 #경험공유
조회수 791

컴공생의 AI 스쿨 필기 노트 ④ 교차 검증과 정규화

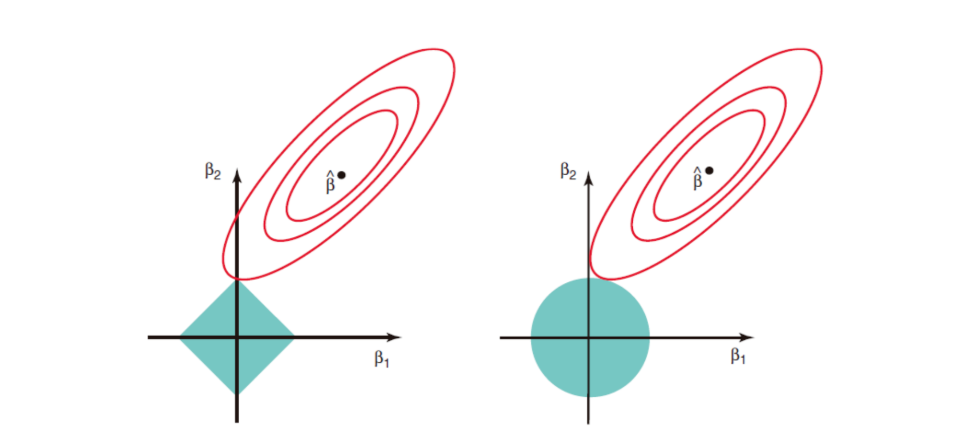
지금까지 Linear Regression, Logistic Regression 모델을 만들어보았는데요. 우리가 만든 모델이 과연 잘 만들어진 모델이라고 볼 수 있을까요? 이를 알기 위해서 이번 4주차 수업에서는 우리가 만든 모델의 적합성을 보다 객관적으로 평가하기 위한 방법으로 교차 검증(Cross Validation)과 정규화(Regularization)를 배웠어요. 차례대로 하나씩 알아볼까요?1. Cross Validation교차 검증은 새로운 데이터셋에 대해 반응하는 모델의 성능을 추정하는 방법이에요. 학습된 모델이 새로운 데이터를 받아들였을 때 얼마나 예측이나 분류를 잘 수행하는지 그 성능을 알기 위해서는 이에 대한 추정 방식이 필요해요. 먼저 Whole population(모집단)에서 Y와 f를 구하기 위해 Training Set(모집단에서 나온 데이터셋)에서 f와 똑같지 않지만 비슷한 모델 f^를 만들어요. 그리고 이 모델을 모집단에서 나온 또 다른 데이터 셋인 Test Set을 이용하여 확인해요. 하지만 일반적으로 Test Set이 별도로 존재하는 경우가 많지 않기 때문에 Training Set을 2개의 데이터셋으로 나눠요. 이 Training Set에서 Training Set과 Test Set을 어떻게 나누느냐에 따라 모델의 성능이 달라질 수 있어요. 이런 테스트 방법을 교차 검증(Cross validation)이라고 해요.이번 시간에는 교차 검증 방법으로 LOOCV(Leave-One-Out Cross Validation)와 K-Fold Cross Validation을 알아봤어요. LOOCV(Leave-One-Out Cross Validation)LOOCV는 n 개의 데이터 샘플에서 한 개의 데이터 샘플을 test set으로 하고, 1개를 뺀 나머지 n-1 개를 training set으로 두고 모델을 검증하는 방식이에요.K-Fold Cross ValidationK-Fold CV는 n 개의 데이터를 랜덤하게 섞어 균등하게  k개의 그룹으로 나눠요. 한 개의 그룹이 test set이고 나머지 k-1개의 그룹들이 training set이 되어 k번을 반복하게 돼요. LOOCV도 n-fold CV로 볼 수 있어요!코드로 나타내기Step1. 데이터 생성 & train set과 test set  단순 분리# model selection modulefrom sklearn.model_selection import train_test_splitfrom sklearn.discriminant_analysis import LinearDiscriminantAnalysis# read datadf = pd.read_csv('data/data01_iris.csv')data = df.iloc[:,:-1].as_matrix()target = df['Species'].factorize()[0]LOOCV와 K-Fold CV에 사용할 데이터를 구하는 코드에요. data 파일 안의 data01.csv 파일을 읽어서 데이터 프레임 형태로 가져와요.df(데이터 프레임) 안에는 이와 같은 105개의 데이터 셋이 저장되어 있어요.df(데이터 프레임)의 Sepal.Length부터 Petal.Width의 값들을 매트릭스 형태로 data에 할당해요.Species에는 ‘setosa’, ‘versicolor’, ‘virginica’ 값들이 있는데요. factorize() 을 이용하여 setosa는 0, versicolor는 1, virginica는 2로 바꿔줘요.# random splitX_train, X_test, y_train, y_test = train_test_split(            data, target, test_size=0.4, random_state=0)X_train.shape, y_train.shapeX_test.shape, y_test.shape그다음에는 data와 target 데이터를 가지고 training set과 test set으로 6:4로 나눠요.X_train.shape = (90,4),  X_test.shape = (60, 4)가 돼요.# LDA f = LinearDiscriminantAnalysis() f.fit(X_train,y_train) y_train_hat = f.predict(X_train) table_count(y_train,y_train_hat) f.score(X_train,y_train)LDA(Linear discriminant analysis)는 대표적인 확률론적 생성 모형이에요. 즉 y의 클래스 값에 따른 x의 분포에 대한 정보를 먼저 알아낸 후, 베이즈 정리를 사용하여 주어진 x에 대한 y의 확률 분포를 찾아낸다고 해요.Step2. test set 준비(1) LOOCV으로 test set 준비# leave-one-out  from sklearn.model_selection import LeaveOneOutloo = LeaveOneOut()loo.get_n_splits(X_train)scv = []for train_idx, test_idx in loo.split(X_train):    print('Train: ',train_idx,'Test: ',test_idx)    f.fit(X_train[train_idx,:],y_train[train_idx])    s = f.score(X_train[test_idx,:],y_train[test_idx])    scv.append(s) get_n_splits() 함수를 사용하여 (90,4)의 shape을 가지는 X_train을 90개로 나눠요.test set에 0부터 89까지 하나씩 할당되고 할당된 숫자 외의 나머지 숫자들은 training set으로 모델을 검증해요. 위의 결과에서도 볼 수 있듯이 test set에 0이 할당되면 train set에는 1 ~ 89가 할당되어 모델을 검증하게 돼요!(2) K-fold CV로 test set 준비# K-fold CVfrom sklearn.model_selection import KFoldkf = KFold(5)kf.get_n_splits()scv = []for train_idx, test_idx in kf.split(X_train):    print('Train: ',train_idx,'Test: ',test_idx)    f.fit(X_train[train_idx,:],y_train[train_idx])    s = f.score(X_train[test_idx,:],y_train[test_idx])    scv.append(s) KFold(5) : 위에서 배운 k-fold 교차 검증에서 k를 5로 설정하여 우리가 가지고 있는 데이터 셋을 5개의 그룹으로 나눠서 교차 검증을 할 거예요.kf.get_n_splits()를 사용하여 5번 교차 검증할 것을 정해요.위에서 90개의 데이터셋을 5개의 그룹으로 나눴어요. 그리고 각 그룹 한 개씩 test set으로 정하고 나머지 그룹들은 training set으로 할당하고 모델을 검증해요. 예를 들어 그룹 1이 0~17, 그룹 2가 18 ~ 35, 그룹 3이 36~53, 그룹 4가 54~71, 그룹 5가 72~89라고 할 때, test set에 그룹 1을 할당하면 train set에는 그룹 2, 3, 4, 5가 할당되어 모델을 검증하게 돼요.Step3. 교차 검증 시행CV는 단순히 데이터 셋을 나누는 역할을 수행할 뿐이에요. 실제로 모형의 성능(편향 오차 및 분산)을 구하려면 이렇게 나누어진 데이터셋을 사용하여 평가를 반복해야 해요. 이 과정을 자동화하는 명령이 cross_val_score()이에요.# K-fold CVfrom sklearn.model_selection import cross_val_scoref = LinearDiscriminantAnalysis()s = cross_val_score(f,X_train,y_train,cv=3)cross_val_score(f, X_train, y_train, cv=3) : cross validation iterator cv를 이용하여 X_train, y_train을 분할하고 f에 넣어서 scoring metric을 구하는 과정을 반복해요.2. Regularization앞서 말한 우리의 목적은 우리의 데이터셋에 맞는 Y와 f를 구하는 것이었어요. f를 결정하기 위해서는 먼저 결정해야 하는 요소가 있어요. 아래 다섯 가지가 f를 결정하는 요소들이에요.- Model family : linear, neural 등 방법론 결정- Tuning parameter : 모델에 맞는 파라미터 조절 - Feature selection(특징 선택) : 많은 데이터 중 어떤 데이터를 쓸지 고르는 것 - Regularization(정규화)  - Dimension reduction(차원 축소)f를 결정하는 요소 중 Regularization(정규화)에 대해 알아볼게요!정규화 선형회귀 방법은 선형회귀 계수(weight)에 대한 제약 조건을 추가함으로써 모형이 과도하게 최적화되는 현상(과최적화, overfitting)을 막는 방법이에요. 모형이 과도하게 최적화되면 모형 계수의 크기도 과도하게 증가하는 경향이 나타나요. 따라서 정규화 방법에서 추가하는 제약 조건은 일반적으로 계수의 크기를 제한하는 방법이에요. 일반적으로 Ridge Regression, Lasso, Elastic Net 이 세 가지 방법이 사용돼요.Ridge Regression머신 러닝에서는 모델의 오차를 찾기 위해 보통 최소제곱법(Least squares fitting)을 이용하여 β를 최소화시켜요. 위의 RSS는 잔차제곱식으로 예측값과 실제 값 사이의 차이를 구하는 식이에요. 회귀분석의 계수 값을 RSS을 최소화하는 β값을 찾음으로써 구할 수 있어요.Ridge Regression은 최소제곱법에 가중치들의 제곱합을 최소화하는 것을 추가적인 제약 조건으로 갖는 방법이에요. λ는 기존의 제곱합과 추가적 제약 조건의 비중을 조절하기 위한 하이퍼 파라미터에요. λ가 크면 정규화 정도가 커지고 가중치의 값들이 작아져요. λ가 작아지면 정규화 정도가 작아지며 λ가 0이 되면 일반적인 선형 회귀 모형이 돼요.코드로는 아래와 같이 나타낼 수 있어요.from sklearn.linear_model import Ridgef = Ridge(alpha=0.5)f.fit(xtrain,ytrain)f.intercept_,f.coef_f.score(xtrain,ytrain)f.score(xtest,ytest)LassoLasso는 가중치의 절댓값의 합을 최소화하는 것을 추가적인 제약 조건으로 가져요. 아래와 같이 코드로 나타낼 수 있어요.from sklearn.linear_model import Lassof = Lasso(alpha=1.0)f.fit(xtrain,ytrain)f.intercept_,f.coef_f.score(xtrain,ytrain)f.score(xtest,ytest)Elastic NetElastic Net은 가중치의 절댓값의 합과 제곱합을 동시에 제약 조건으로 가지는 모형이에요. 코드로는 아래와 같아요.from sklearn.linear_model import ElasticNetf = ElasticNet(alpha=0.1,l1_ratio=0.5)f.fit(xtrain,ytrain) f.intercept_,f.coef_f.score(xtrain,ytrain)f.score(xtest,ytest)Lasso와 Ridge Regression의 차이점왼쪽 : Lasso, 오른쪽 Ridge Regression위의 두 그림은 Lasso와 Ridge Regression의  차이점을 잘 나타내는 그림이에요. 초록색 부분은 회귀계수(회귀분석에서 독립변수가 한 단위 변화함에 따라 종속변수에 미치는 영향력 크기)가 가질 수 있는 영역이고 빨간색 원은 RSS가 같은 지점을 연결한 것을 보여주는 것으로 가운데로 갈수록 오차가 작아져요.Lasso와 Ridge Regression 모두 RSS를 희생하여 계수를 축소하는 방법이라는 공통점이 있어요.하지만 Ridge Regression과 Lasso의 가장 큰 차이점은 Ridge 회귀는 계수를 축소하되 0에 가까운 수로 축소하는 반면, Lasso는 계수를 완전히 0으로 축소화한다는 점이에요.Cross validation(교차 검증)과 Regularization(정규화)에 대해 알아보았는데요. 간단히 요약해 볼게요.Cross validation(교차 검증)은 머신러닝 모델의 타당성을 검증하는 방법 중의 하나로, 특정 데이터를 training set과 test set으로 분할한 뒤 training set을 활용해 학습하고 test set으로 테스트하여 학습의 타당성을 검증하는 방법이에요. 교차 검증에는 여러 가지 방법이 있는데 그중에서도 우리는 LOOCV와 K-Fold CV를 배웠어요.Regularization(정규화)는 모델의 일반화 오류를 줄여 과적합을 방지하는 방법을 말해요. 일반적으로 Ridge Regression, Lasso, Elastic Net 이 세 가지 방법을 사용해요.이상적인 머신러닝 모델을 만들기 위해 고려해야 할 점들은 정말 많은 것 같아요. 우리가 만든 모델이 적합한 모델인지 이번 수업시간에 배운 교차 검증과 정규화를 통해 잘 살펴봐요!* 이 글은 AI스쿨 - 인공지능 R&D 실무자 양성과정 4주차 수업에 대하여 수강생 최유진님이 작성하신 수업 후기입니다.
조회수 1850

[Tech Blog] Compare Software Architectures: Monoliths, SOA and Microservices

요즘 Software architecture 라는 단어를 들으면 아마도 Client engineer 분들은 MVC, MVP, MVVM 이 먼저 떠오를 것이고, Server engineer 분들은 Microservice architecture 를 먼저 떠오를 것 같네요. Clean architecture 나 Event-driven architecture 등을 떠올리는 분들도 계실 것 같구요. Software architecture 를 어떻게 정의할 수 있을지에 대해서는 Software architecture: The important stuff 에 적어 봤으니 여기에선 넘어가도록 하죠. https://mherman.org/blog/developing-microservices-node-react-docker/ Microservice architecture 는 대세라고 말할 수 있습니다. Netflix, Amazon 등 굴지의 기업들이 성공적으로 적용해서 운영하고 있고, 국내 기술적으로 뛰어난 많은 기업들 역시 이미 적용했거나 시도하고 있습니다. “남들 다 하는데 이러다 도태 되는거 아냐?” 라는 생각이 들 정도로 말이죠. 그러나 이전 글에서 얘기했듯이 정답은 없으며, Microservice architecture 역시 예외는 아닙니다. 모든 선택에는 Tradeoff 가 있고, Microservices 는 다른 architecture 에 비해 어떤 장점이 있는지 살펴봐야 합니다. 이와 관련하여 정말 많은 좋은 글들이 이미 있으니, 이 글에서는 몇 가지 Software architecture 들을 가볍게 정리 및 비교해 보도록 하겠습니다. Monolithic Architecture Monolithic architecture 는 Microservice architecture 의 장점을 얘기할 때 반드시 언급될 정도로 대척점에 있는 architecture 입니다. Monolithic architecture 는 하나의 큰 덩어리로 구성되어 있고, 모든 기능이 하나의 프로젝트에 집중되어 있습니다. 쉽게 구성이 가능하고 초기에 기능을 빠르게 추가하기에 용이하나, 복잡도가 늘어날수록 기능 추가 속도가 느려지고 문제가 발생할 가능성이 높습니다. PoC(Proof of Concept)를 위한 가벼운 프로젝트나 아주 초기 프로젝트에 적용 가능합니다. Semi-Monolithic Architecture Monolithic architecture 보다는 작지만, 여전히 기능들이 몇 개의 프로젝트에 집중되어 있는 architecture 입니다. 예를 들어 frontend 와 backend 프로젝트를 나누었지만 각 프로젝트가 monoliths 인 경우 semi-monolithic architecture 라고 볼 수 있습니다. 다만 Semi-monoliths 의 경우 몇 군데에서 언급한 것을 볼 수 있지만, 일반적으로 사용되는 architecture 용어는 아닌 듯하고, Semi-monoliths 로 구분될 수 있는 경우 Monolithic architecture 라고 분류할 수 있을 듯합니다. 단순 frontend / backend 보다 좀 더 많은 수의 service 로 분할된 architecture 를 구성하더라도 각 service 가 monoliths 로 구분될 수 있다면 여전히 monolithic architecture 를 구성하고 있다고 할 수 있습니다. Service-Oriented Architecture 여러 조직이 다수의 application 사이에서 로직과 데이터를 공유하기 위해 제안된 architecture 입니다. Monolithic architecture 와 달리 기능을 나눠서 여러 개의 서비스로 구성하고, 서비스 사이는 API 를 통해서 통신합니다. Microservice architecture 와 Service-oriented architecture (SOA) 를 비교하기 위해 Enterprise Service Bus (ESB)가 많이 언급됩니다. ESB는 Enterprise Application Interface (EAI) 와 대조적으로 가볍고 흔한 통신을 위해 제안되었으나, 통제와 관리를 위해 점점 무거운 방향으로 진행되면서 최초의 의도와 달라졌습니다. SOA 가 무거워짐에 따라 최초의 의도였던 빠른 적용, 민첩한 개발 및 적은 통합 비용과 멀어지게 되면서 자연스럽게 도태되었습니다. 서비스 사이에 데이터베이스를 공유할 수 있느냐 아니냐로 Microservice 와 구분을 짓는 의견도 있습니다만, SOA의 정의가 넓어서 이 부분에 대해서는 이견들이 있습니다.   https://dzone.com/articles/microservices-vs-soa-2 SOA가 넓은 범위에서 정의됐기 때문에 ESB 나 DB 공유 여부로 SOA 를 규정 짓기는 어렵습니다. 정의 상으로 보면 Microservice architecture 역시 SOA 의 일종이라고도 볼 수 있습니다. Microservice 의 예시로 자주 등장하는 Netflix 와 Amazon 역시 Microservice 라는 단어가 사용되기 전에는 스스로의 시스템을 SOA 라고 지칭했습니다. Microservice Architecture: The O’Reilly Book 의 공동 저자 Matt McLarty 는 Learn from SOA: 5 lessons for the microservices era 라는 글에서 SOA 와 Microservice architecture 가 같은가 다른가는 그다지 중요한 것이 아니며, 우리가 SOA 로부터 어떤 것들을 배웠는가가 중요하다고 강조합니다. Microservice Architecture Microservice architecture는 규모가 빠르게 커져도 제품 생산 속도를 빠르게 유지하고 안정성을 가질 수 있는 architecture 입니다. 충분히 작은 서비스들이 서로 통신하면서 기능을 수행합니다. Microservice architecture 를 SOA의 잘 구현된 형태라고 보는 시각도 있지만, micro 라는 단어가 SOA 에서 정의하는 서비스보다 작은 크기의 서비스임을 명시적으로 표현하기 때문에 매우 다르다는 의견 역시 있습니다. Microservice architecture 는 각 서비스의 크기를 작고 가볍게 유지함으로써 더 깔끔하고 명확하게 서비스를 유지할 수 있습니다. 잘 구성될 경우 특정 서비스에 장애가 생겨도 다른 서비스에 영향을 적게 미치거나 유연하게 대응할 수 있기 때문에 전체 시스템 오류(e.g Single Point of Failure)를 방지할 수 있습니다. 각 서비스는 독립적으로 배포 및 확장 가능하기 때문에 기능 배포가 빠르고 많은 트래픽에 유연하게 대처할 수 있습니다. 한편 Microsoft architecture 는 구조적인 면에서 복잡도가 증가하며, 많아진 서비스 및 서비스 간 통신에 대한 유지 보수 비용이 추가됩니다. 이를 대응하기 위해서 충분히 자동화되고 잘 구성된 시스템이 필수적으로 필요합니다. Conclusion 판단과 결정은 근거를 필요로 합니다. 가끔 감을 믿고 밀어붙여야 할 때(e.g 오늘 점심은 해장국을 먹어야 한다던가)도 있다는 점은 인정합니다. 하지만 그 역시 설득력을 가지지 못하면 하나의 목표를 향해 모두가 미친듯이 달려가기는 어렵겠죠. Software architecture 를 결정하기 위해서는 추구하는 비전과 비지니스를 이해하고 그에 맞는 근거 하에 모든 팀원을 판단하고 설득해야 합니다. 버즈빌 에서는 더 빠르고 큰 성장을 위해 Architecture Task Force 팀을 구성하였습니다. ATF 팀은 버즈빌에 최적인 Software architecture 를 판단하고, 구성하고, 실행하기 위해 바쁘게 움직이고 있습니다. Buzzvil Services Characteristic:  제품이 다양하고 제품별로 제공해야 할 기능이 많다. 각 제품이 공통적으로 필요로 하는 기능이 많다. 서비스 혹은 기능별로 대응해야 하는 트래픽이 다르다. 전체 서비스 장애 발생 시 많은 후속 문제가 발생한다. 트래픽 변동이 특정 이벤트에 의해 크게 일어날 수 있다.  Buzzvil 의 제품과 비지니스는 위와 같은 성격을 가지고 있습니다. 이를 바탕으로 우리는 Microservice architecture 가 가장 적절하다고 판단하였고, 현재 microservices 의 장점을 살리면서 안정적이고 빠르게 우리가 원하는 목표에 도달할 수 있도록 다양한 방면에서 변화를 가져가고 있습니다. References  Learn from SOA: 5 lessons for the microservices era Microservices vs. SOA On monoliths, service-oriented architectures and microservices Microservices.io Microservices Resource Guide Design Microservice Architectures the Right Way Developing Microservices – Node, React, and Docker    *버즈빌에서 개발자를 채용 중입니다. (전문연구요원 포함)작가소개 Whale, Chief Architect “Keep calm and dream on.”
조회수 801

HBase상 트랜잭션 라이브러리 Haeinsa를 소개합니다

비트윈에서는 서비스 초기부터 HBase를 주요 데이터베이스로 사용하였습니다. HBase에서도 일반적인 다른 NoSQL처럼 트랜잭션을 제공하지 않습니다. HBase, Cassandra와 MongoDB는 하나의 행 혹은 하나의 Document에 대한 원자적 연산만 제공합니다. 하지만 여러 행에 대한 연산들을 원자적으로 실행할 수 있게 해주는 추상화된 트랜잭션 기능이 없다면 보통의 서비스 개발에 어려움을 겪게 됩니다. 비트윈 개발팀은 이런 문제를 해결하기 위해 노력했으며, 결국 HBase에서 트랜잭션을 제공해주는 라이브러리인 Haeinsa를 구현하여 실제 서비스에 적용하여 성공적으로 운영하고 있습니다. VCNC에서는 Haeinsa를 오픈소스로 공개하고 이번 글에서 이를 소개하고자 합니다.Haeinsa란 무엇인가?¶Haeinsa는 Percolator에서 영감을 받아 만들어진 트랜잭션 라이브러리입니다. HAcid, HBaseSI 등 HBase상에서 구현된 트랜잭션 프로젝트는 몇 개 있었지만, 성능상 큰 문제가 있었습니다. 실제로 서비스에 적용할 수 없었기 때문에 Haeinsa를 구현하게 되었습니다. Haeinsa를 이용하면 다음과 같은 코드를 통해 여러 행에 대한 트랜잭션을 쉽게 사용할 수 있습니다. 아래 예시에는 Put연산만 나와 있지만, 해인사는 Put외에도 Get, Delete, Scan 등 HBase에서 제공하는 일반적인 연산들을 모두 제공합니다.HaeinsaTransaction tx = tm.begin(); HaeinsaPut put1 = new HaeinsaPut(rowKey1);put1.add(family, qualifier, value1);table.put(tx, put1); HaeinsaPut put2 = new HaeinsaPut(rowKey2);put2.add(family, qualifier, value2);table.put(tx, put2); tx.commit();Haeinsa의 특징¶Haeinsa의 특징을 간략하게 정리하면 다음과 같습니다. 좀 더 자세한 사항들은 Haeinsa 위키를 참고해 주시기 바랍니다.ACID: Multi-Row, Multi-Table에 대해 ACID 속성을 모두 만족하는 트랜잭션을 제공합니다.Linear Scalability: 트래픽이 늘어나더라도 HBase 노드들만 늘려주면 처리량을 늘릴 수 있습니다.Serializability: Snapshot Isolation보다 강력한 Isolation Level인 Serializability를 제공합니다.Low Overhead: NoSQL상에서의 트랜잭션을 위한 다른 프로젝트에 비해 오버헤드가 적습니다.Fault Tolerant: 서버나 클라이언트가 갑자기 죽더라도 트렌젝션의 무결성에는 아무 영향을 미치지 않습니다.Easy Migration: Haeinsa는 HBase를 전혀 건드리지 않고 클라이언트 라이브러리만 이용하여 트랜잭션을 구현합니다. 각 테이블에 Haeinsa 내부적으로 사용하는 Lock Column Family만 추가해주면 기존에 사용하던 HBase 클러스터에도 Haeinsa를 쉽게 적용할 수 있습니다.Used in practice: 비트윈에서는 Haeinsa를 이용하여 하루에 3억 건 이상의 트랜잭션을 처리하고 있습니다.Haeinsa는 오픈소스입니다. 고칠 점이 있다면 언제든지 GitHub에 리포지터리에서 개선에 참여하실 수 있습니다.Haeinsa의 성능¶Haeinsa는 같은 수의 연산을 처리하는 트랜잭션이라도 소수의 Row에 연산이 여러 번 일어나는 경우가 성능상 유리합니다. 다음 몇 가지 성능 테스트 그래프를 통해 Haeinsa의 성능에 대해 알아보겠습니다.아래 그래프는 3개의 Row에 총 6개의 Write, 3개의 Read연산을 수행한 트랜잭션의 테스트 결과입니다. 두 개의 Row에 3Write, 1Read 연산을 하고, 한 개의 Row에 1Read 연산을 한 것으로, 비트윈에서 가장 많이 일어나는 요청인 메시지 전송에 대해 시뮬레이션한 것입니다. 실제 서비스에서 가장 많이 일어나는 종류의 트랜잭션이라고 생각할 수 있습니다. 그런데 그냥 HBase를 사용하는 것보다 Haeinsa를 이용하는 것이 더 오히려 좋은 성능을 내는 것을 알 수 있습니다. 이는 Haeinsa에서는 커밋 시에만 모든 변경사항을 묶어서 한 번에 반영하기 때문에, 매번 RPC가 일어나는 일반 HBase보다 더 좋은 성능을 내는 것입니다.HBase 클러스터가 커질수록 트랜잭션 처리량이 늘어납니다. HBase와 마찬가지입니다.HBase 클러스터의 크기에 따른 응답시간 입니다. HBase와 다르지 않습니다..아래 그래프는 2개의 Row에 각각 한 개의 Write, 나머지 한 개의 Row에는 한 개의 Read 연산을 하는 트랜잭션에 대해 테스트한 것입니다. 각 Row에 하나의 연산만이 일어나기 때문에 최악의 경우라고 할 수 있습니다. 처리량과 응답시간 모두 그냥 HBase를 사용하는 것보다 2배에서 3배 정도 좋지 않은 것을 알 수 있습니다. 하지만 이 수치는 DynamoDB 상의 트랜잭션과 같은 다른 트랜잭션 라이브러리와 비교한다면 상당히 좋은 수준입니다.HBase보다 처리량이 떨어지긴 하지만, 클러스터가 커질수록 처리량이 늘어납니다.HBase보다 응답시간이 크긴 하지만 클러스터 크기에 따른 변화가 HBase와 크게 다르지 않습니다.저희는 언제나 타다 및 비트윈 서비스를 함께 만들며 기술적인 문제를 함께 풀어나갈 능력있는 개발자를 모시고 있습니다. 언제든 부담없이 [email protected]로 이메일을 주시기 바랍니다!
조회수 2596

데이블 주니어 개발자 직무 인터뷰

오후 두 시의 회의실. 개발자들의 스터디하는 소리로 뜨겁다. 국내 최고의 추천 기술을 보유했다는 데이블. 10년 이상의 경력을 가진 노련한 시니어 개발자들 사이에서, 스쳐 지나가는 단어 하나하나 놓치지 않으려 귀 기울이고 있는 주니어 개발자들을 만났다.안녕하세요? 간략한 소개와 두 분의 업무에 관해 설명해주세요.형주: 안녕하세요? 저는 데이블 개발팀 최형주입니다.저는 백앤드 개발팀의 신입 개발자로서 데이블의 인프라 관리, 백앤드 개발 그리고 가끔 데이터 분석을 하고 있습니다. 주로 사용하는 서버는 클라우드 플랫폼인 AWS(Amazon Web Service)과 Nodejs 이고, MySQL, Redshift, Python을 사용하여 데이터 처리와 분석을 하고 있어요.성현: 안녕하세요. 저는 데이블 개발팀 이성현입니다.제 메인 업무는 데이블 위젯의 스타일링과 관련 문제 해결입니다. 고객사 페이지를 분석해서 위젯 디자인을 만들고, 추천 결과가 안 나오는 경우에 문제를 수정하는 작업입니다. 특별한 기능이 필요한 위젯이 있으면 스크립트 작업도 하고요. 작업 도구는 회사 내부 시스템이 있어서 그 안에서 직접 작업하고, CSS로 작성합니다.위 업무가 메인이지만 다른 영역과 겹칠 때도 잦아서 회사에서 사용하는 여러 시스템을 만질 수 있어야 합니다. 도구는Html+CSS+js 외에 Node, gulp, react, angular angularJS, PHP, 젠킨스, AWS, MYSQL, git를 사용하고 있습니다.두 분 다 신입 개발자이신 만큼 회사를 선택하는 데 있어 신중했을 것 같아요.데이블을 선택한 이유는 무엇인가요?형주:  저는 대학원에서 빅데이터 처리관련 연구를 주로 했었어요. 졸업할 때쯤 제 전공과 관련된 회사에 지원했었고 많은 면접을 보았습니다. 여러 회사에서 면접을 봤지만 데이블에서 봤던 면접 경험이 만족스러웠고 특히 개발자들의 실력과 내공이 느껴져 신입으로서 많은 것을 배우고 싶어서 입사하게 되었습니다. 복지 또한 여느 알려진 회사들에 비해 부족하지 않아서 굉장히 만족하고 있습니다.성현: 처음 데이블에 호감을 느끼게 된 건 기술 중심 스타트업이라는 점이었습니다. 도전하는 자세, 유연한 사고, 성장 가능성, 복지 등 여러 가지 기준들이 있겠지만, 내가 재미를 느낄 수 있는가, 개발자로서의 성장 이 두 가지로 압축되었어요. 저 같은 경우에는 블로그를 보면서 회사 분위기를 대략 파악했던 것 같네요. 자유로운 분위기도 잘 느껴지고, 서로를 배려하면서 열심히 일하는 것을 간접적으로 경험할 수 있었어요. 면접 보러 갔을 때, 블로그에서 보던 사람들이 블로그 글과 비슷한 느낌으로 편하게 얘기하는 걸 보면서 마음을 굳히게 됐어요.데이블의 분위기는 어떤가요?형주: 분위기는 실제로 굉장히 수평적입니다. 서로 존댓말을 사용해서 존중받는 기분이 들어요.성현: 저는 데이블 오기 전에 잠시 다른 회사에 있었는데, 거기서는 과한 예절이나 눈치를 보는 분위기가 있었어요. 데이블은 수평적인 분위기이다 보니 스트레스 받지 않고 일에 집중할 수 있어 좋아요.형주: 저 같은 경우, 잠에 굉장히 민감한 편인데 출퇴근이 탄력적이어서 지각에 대한 스트레스가 없어서 좋아요. 그래서 저는 보통 9시 넘어서 일어나서 10시쯤 출근하고 7시쯤 퇴근하는 편입니다. 그리고 식대도 지원해주고 있어요~성현: 매일 4시쯤 회사가 지원하는 간식 타임이 있어요. 오랜 시간 앉아서 일하다 보면 집중력 떨어질 때 쯤 다 같이 모여 대화를 나누면서 간식을 같이 먹습니다. 만약 생일이 있으면 간식 타임과 더불어 생일 파티를 해요.형주: 간식과 음료수가 항상 냉장고에 갖춰져 있어서 먹을 것을 좋아하는 사람에게 최고인 것 같아요. 저는 살이 잘 안 찌는 체질인데 입사 후 2킬로가 쪘어요.성현: 거의 슬랙과 트렐로 위주로 업무를 하는데 간식 타임에는 여러 사람과 대화를 할 수 있어 좋습니다. 서로 대화도 같이하고, 같이 활동할 수 있는 시간을 마련하기 위해 ‘플레이 데이’ 도 2개월에 한 번씩 열고 있어요! 회사-집, 집-회사를 반복하다가 다 같이 뭔가를 하니 신선했어요. 업무 외적으로 같이 활동하면서 사람들과 친밀감을 느낄 수 있어서 좋았어요.데이블을 선택했던 이유 중 개발자로서 성장 가능성도 있었는데 이것은 어떻게 채워지고 있나요?성현: Dabler, Be The Expert 프로그램(이하 BTE 프로그램)이 있고 업무 관련 스터디도 활발히 진행하고 있어요.자세히 설명해주세요. 성현: BTE 프로그램의 경우 장기목표를 정하고 반기별로 관련 학습 계획을 세워요. 그 안에서 책도 사고 강의도 신청하고 하는 거지요. 스스로 목표를 잡고 자유롭게 계획을 세울 수 있어서 좋아요. 본인이 정말 원하는 것을 배울 수 있고, 필요한 자금은 회사가 지원하는 거죠. 단, 업무에 관련된 성장 계획이어야 한다는 가이드라인이 있어요.이 외에도 백엔드 개발자들과 함께 AWS 사용법을 주제로 스터디도 해요! 보통 프론트엔드를 담당하지만, 백엔드 영역도 경험할 수 있어요. 본인 스스로 영역을 넓히기 위해 공부하고 능력이 된다면 활동 범위가 굉장히 넓어져요. 회사 차원에서도 그런 시도를 장려해요. 빨리 성장해야겠다는 욕심이 있어요.형주: 전 회사에서 일주일에 2번 모여서 스터디도 하고 있고 MOOC 강의를 수강하거나 책을 사고 싶을 때 눈치 볼 필요 없이 신청하면 돼요. 그리고 반기별로 자기 개발을 잘한 직원에게 인센티브를 줘요.※BTE 프로그램이란?그럼 두 분은 BTE 프로그램을 통해 어떤 것들을 배우고 계시는가요?형주: 저는 Coursera에서 Recommender System 수업을 듣고 있어요. 아무래도 우리 회사의 핵심기술이 추천 기술이다 보니까 이쪽 분야를 깊게 공부해야겠다는 생각이 들었습니다.성현: 저는 웹을 능숙하게 다루고 싶어서 상반기에는 인프라, 자바스크립트, 웹 표준, node 등 기본을 다시 챙기고 하반기에는 웹 최신 기술을 공부하려고 해요.지금은 자바스크립트 관련 책 3권과 강의 2개를 신청해서 주로 퇴근 후 또는 주말에 듣고 있어요. 업무와 관련된 것을 공부하고 나서 코드를 작성하면 대충 넘어갔던 부분들이 보여요. 그 부분을 놓치지 않고 수정하고 개선하다 보면 예전보다 나은 결과물이 나오고 뭔가 아는 게 늘었구나! 하는 보람을 느낍니다.데이블에서 개발자로 일하며 느끼는 점형주: 저의 경우에는 신입 개발자 관점에서 경험 많은 개발자분의 피드백을 통해 노하우를 전수하는 점이 좋았어요. 그러면서 기존에 놓치고 있던 부분이나 실무와 이론 사이의 괴리감을 좁히는 경험이었습니다. 저도 학부, 대학원 시절 많은 코딩을 했지만 제가 작성한 코드가 잘 작성된 코드인지 잘 읽히는 코드인지는 스스로 공부하기 힘들었는데 이러한 피드백을 통해 성장함을 느꼈습니다.어려웠던 점은 우리 회사는 애드테크 회사이다 보니 광고 용어를 굉장히 많이 사용하는데 광고에 관해 얘기할 때 처음에는 광고 용어를 몰라 답답했었는데, 스터디를 만들어서 어려운 점을 조금은 해소할 수 있었어요.성현: 자기만 할 수 있으면 얼마든지 여러 프로젝트에 참여할 수 있는 문화가 좋아요. 예를 들면 저는 위젯 담당이지만, 위젯 업무 틈틈이 데이블 시스템 페이지 수정을 할 수도 있고 내부 DB를 이용해서 사업팀에게 도움이 되는 통계 페이지를 만들기도 해요. 얼마 전에는 커뮤니티에 데이블 추천 기능을 직접 넣는 프로젝트를 했습니다. 보통 추천 연동은 고객사가 하고 저는 위젯만 만들고 있었거든요. 이번에 고객사 입장에서 서버 쪽을 만져본 거죠.미래의 데이블은 어떤 모습일까요?형주, 성현: 세계 No. 1 콘텐츠 디스커버리 플랫폼! 경영진이 자기 개발 지원이나 복지에 신경을 많이 쓰고 있어서 계속 나아질 것 같아요.데이블의 개발자가 되기 위해 어떤 것들이 필요할까요?형주: 제가 생각하기에 시니어 개발자분들이 가장 중요하게 여기는 부분은 CS 분야의 기본기였던 것 같습니다. 이 기본기를 통해 자주 사용하는 툴이나 오픈 소스가 내부적으로 어떻게 구성되어 있고 동작하는지에 대한 공부를 하면 도움이 될 것 같습니다.성현: 저는 주도적인 자세요! 스스로 일하고 배우는 자세가 필요합니다. 다른 개발자와 소통하면서도 자기 일의 진행 관리나 조율은 스스로 해야 해요. 다음 일을 직접 찾아야 할 때도 있고요. 또 전부를 물어볼 수는 없으니 어느 정도 혼자 찾아 공부하는 습관도 필요해요. 그리고 자기가 지원하는 포지션에서 사용하는 핵심 기술 하나는 능숙하게 사용할 수 있어야 해요. #데이블 #팀원 #개발자 #개발팀 #개발 #팀원소개 #인터뷰 #기업문화

기업문화 엿볼 때, 더팀스

로그인

/