스토리 홈

인터뷰

피드

뉴스

조회수 4282

[Tech Blog] Go 서버 개발하기

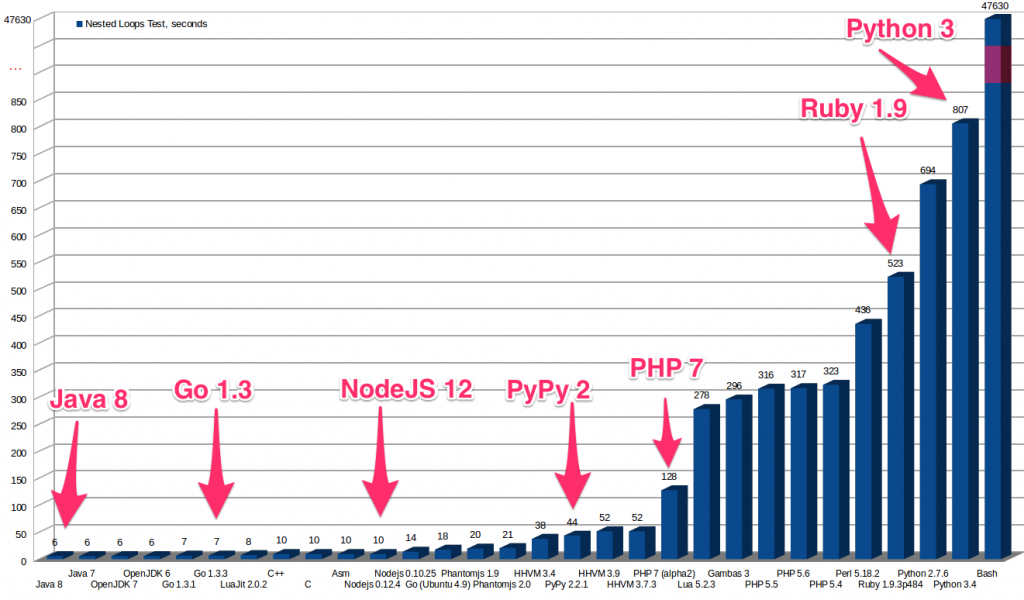
Go 서버 개발을 시작하며   특정 API만 다른 언어로 구현해서 최대의 성능을 내보자! 저희 서버는 대부분 Django framework 위에서 구현된 광고 할당 / 컨텐츠 할당 / 허니스크린 앱 서비스 이렇게 나눌 수 있는데 Python 이라는 언어 특성상 높은 성능을 기대하기가 어려웠습니다. 하지만 세가지 서비스에서 락스크린에서 어떤 컨텐츠나 광고를 보여줄지 결정하는 Allocation(할당) API 가 가장 많이 호출되고 있었는데 빈도로 보면 80% 정도로 높은 비중을 차지하고 있어서 이 Allocation API 들을 성능이 좋은 다른 언어로 구현하면 어떨까 하는 팀내 의견이 있었습니다. Why Go? 저는 예전부터 Java,  C# 등의 컴파일 언어에 익숙해서 기존 Java 와 C, 그리고 Go 라는 최근에 새로 나온 언어 중에서 아래 블로그글과 같이 여러 reference 들을 통해 성능이 좋다는 Go 로 이 API 들을 포팅하는 작업을 시작하게 되었습니다. Go 에 대한 첫 인상은 Java, C계열 언어보다 덜 verbose 보였고 python 보다는 strongly-typed, encapsulated 하다보니 자유도를 제한해서 코드를 보기 쉽게 하는 것을 선호하는 저의 성격과도 잘 맞는 언어였습니다.     출처: Carles Mateo, Performance of several languages서버 개발 환경   Server design How to import libraries  GVT (https://github.com/FiloSottile/gvt) – Go 는 vendering tool 을 통해 dependency 를 관리할 수 있습니다. GVT 의 경우 처음 도입했을 때 별로 유명하지 않았는데 사용법이 간단해서 도입하게 되었습니다. 아래와 같이 참조하고 있는 revision 을 관리해주며 update 통해서 최신 소스를 받아 올수 있습니다.   { "version": 0, "dependencies": [ { "importpath": "github.com/Buzzvil/go-env", "repository": "https://github.com/Buzzvil/go-env", "vcs": "git", "revision": "2d8489d40184a12c4d09d09ce1ff717e5dbb0745", "branch": "master", "notests": true }, ....  Design pattern  Go 언어에서는 package level cycling dependency 를 허용하지 않아서 좀더 명확한 구조를 만들기 좋았습니다. 예를들어 Service 에서는 Controller 를 참조할수 없고 Model 에서는 Controller / Service / DTO 등을 참조할수 없도록 강제했습니다. 모든 API 요청은 Route 를 통해 Controller 에게 전달되고 이 때 생성된 DTO (Data transfer object) 들을 Controller 가 직접 혹은 Service layer 에서 처리하도록 하였고 DB 에 접근할 때는 모델을 통해 혹은 직접 접근하도록 했지만 추후 구조가 복잡해지면 DB 쿼리 등을 담당하는 DAO (Data access object) 를 도입할 계획입니다   Libraries                  요소이름선택 이유NetworkGinWeb 서버이다 보니 네트워크 성능을 최우선으로 고려, 벤치마크 표를 보고 이 라이브러리를 선택Redis & cachego-redis역시 성능을 가장 중요한 지표로 보고 이 라이브러리 선택MysqlGormORM 없이는 개발하기 힘든 시대이죠. 여러 Database를 지원하고 ORM 중에서도 method chaining 을 사용하는 Gorm 을 선택Dynamoguregu dynamoAWS에서 제공하는 Dynamo 패키지를 그대로 사용하면 코드 양이 너무 많아지고 역시 method chaining 을 지원해서 선택Environment variablescaarlos0 envGo 에서는 tag 를 이용하면 좀더 코드를 간결하고 읽기 쉽게 사용할수 있는데 이 라이브러리가 환경변수를 읽어오기 쉽도록 해줌   Redis cache  func SetCache(key string, obj interface{}, expiration time.Duration) error { err := getCodec().Set(&cache.Item{ Key: key, Object: obj, Expiration: expiration, }) return err } func GetCache(key string, obj interface{}) error { return getCodec().Get(key, obj) }  Mysql  var config model.DeviceContentConfig env.GetDatabase().Where(&model.DeviceContentConfig{DeviceId: deviceId}).FirstOrInit(&config)  Dynamo if err := env.GetDynamoDb().Table(env.Config.DynamoTableProfile).Get(keyId, deviceId).All(&profiles); err == nil && len(profiles) > 0 { ... }  Environment variables  var ( Config = ServerConfigStruct{} onceConfig sync.Once ) type ( ServerConfigStruct struct { ServerEnv string `env:"SERVER_ENV"` LogLevel string .... } ) func LoadServerConfig(configDir string) { onceConfig.Do(func() {//최초 한번반 호출되도록 env.Parse(&Config) } }    Unit test   환경 구성 Test 환경에는 Redis / Mysql / Elastic search 등에 대한 independent / isolated 된 환경이 필요해서 이를 위해 docker 환경을 따로 구성하였습니다. Test case 작성은 아래와 같이 package 를 분리해서 작성했습니다.  package buzzscreen_test var ts *httptest.Server func TestMain(m *testing.M) { ts = tests.GetTestServer(m) // 환경 시작 tearDownElasticSearch := tests.SetupElasticSearch() tearDownDatabase := tests.SetupDatabase() code := m.Run() // 여기서 작성한 TestCase 들 실행 // 환경 종료 tearDownDatabase() tearDownElasticSearch() ts.Close() os.Exit(code) }  Mock server는 은 http.RoundTripper interface 를 구현해서 http.Client 의 Transport 멤버로 설정해서 구현했습니다. 아래는 Test case 작성 예제입니다.  httpClient := network.DefaultHttpClient mockServer := mock.NewTargetServer(network.GetHost(MockServerUrl)) .AddResponseHandler(&mock.ResponseHandler{ WriteToBody: func() []byte { return []byte(mockRes) }, Path: "/path", Method: http.MethodGet, }) clientPatcher := mock.PatchClient(httpClient, mockServer) defer clientPatcher.RemovePatch()  Unit test 관련해서는 내용이 방대해서 추후 다른 포스트를 통해 자세히 소개하도록 하겠습니다.  Infra API 요청 분할 AWS Application load balancer 여러 API 중에서 할당 API 를 제외한 요청은 기존의 Django 서버로 요청을 보내고 할당요청에 대해서만 Go서버로 요청을 보내도록 구현하기 위해 먼저 시도 했던 것은 AWS Application load balancer (이후 ALB) 였습니다. ALB 의 특징이 path 로 요청을 구별해서 처리할수 있었기 때문에 Allocation API 만 Go 서버 로 요청이 가도록 구현했습니다.  출처: Amazon Devops Blog, Introducing Application Load Balancer   하지만 이렇게 오랫동안 서비스 하지 못했는데 그 이유는 서버 구성이 하나 더 늘어나고 앞단에 ALB 까지 추가되다 보니 이를 관리하는데 추가 리소스가 들어가게 되어서 어떻게 하면 이러한 비용을 줄일수 있을까 고민하게 되었습니다.   Using docker & nginx  Go로 작성된 서버가 독립적인 Micro service 냐 아니면 Django 서버에서 특정 API 를 독립시켜 성능을 강화한 모듈이냐 의 정체성을 두고 생각해봤을때 후자가 조금더 적합하다보니 Go / Django 서버는 한 묶음으로 관리하는 것이 명확했습니다. Docker 를 도입하면서 nginx container 가 proxy 역할을 하고 path를 보고 Go container / Django container 로 요청을 보내는 구성을 가지게 되었습니다.  글을 마치며   시작은 미약하였으나 끝은 창대하리라 하나의 API를 이전했음에도 불구하고 Allocation API 에 대해서는 약 1/3, 서버 Instance 비용은 1/2.5 수준으로 감소했습니다.   설명: 기존 4개의 Django 인스턴스의 CPU 사용률이 모두 13% 정도 감소, Go 인스턴스의 CPU 사용율은 17% 정도   17 / (13 * 4)  ≒ 1 / 3  충분히 만족할만한 성과가 나와서 그 뒤로 몇가지 API도 Go 로 옮겼고 새로 작성하는 API 는 Go 환경 안에서 직접 구현하는 중입니다. 처음에는 호출이 많은 하나의 API 를 다른 언어로 포팅하기 위해 시작한 작업이었는데 Container 기술을 도입하는 등 서버 Infra 까지 변경하면서 상당히 큰 작업이 뒤따르게 되었습니다. 하지만 이 작업을 하면서 많은 동료들의 도움과 조언이 있었고 결국 완성할수 있었습니다. 이렇게 실험적인 도전을 성공 할수 있는 환경에 여러분을 초대하고 싶습니다! Go언어에 대한 문의나 좋은 의견도 환영합니다.
조회수 882

HBase Meetup - 비트윈에서 HBase를 사용하는 방법 - VCNC Engineering Blog

비트윈에서는 서비스 초기부터 HBase를 주요 데이터베이스로 사용하였으며 사용자 로그를 분석하는 데에도 HBase를 사용하고 있습니다. 지난 주 금요일(11월 15일)에 HBase를 만든 Michael Stack 씨가 한국을 방문하게 되어 ZDNet 송경석 팀장님의 주최 하에 HBase Meetup Seoul 모임을 가졌습니다. 그 자리에서 VCNC에서 비트윈을 운영하면서 HBase를 사용했던 경험들이나 HBase 트랜잭션 라이브러리인 Haeinsa에 대해 간단히 소개해 드리는 발표 기회를 가질 수 있었습니다. 이 글에서 발표한 내용에 대해 간단히 소개하고자 합니다.비트윈 서비스에 HBase를 사용하는 이유비트윈에서 가장 많이 사용되는 기능 중 하나가 채팅이며, 채팅은 상대적으로 복잡한 데이터 구조나 연산이 필요하지 않기 때문에 HBase 의 단순한 schema 구조가 큰 문제가 되지 않습니다. 특히 쓰기 연산이 다른 기능보다 많이 일어나기 때문에 높은 쓰기 연산 성능이 필요합니다. 그래서 메세징이 중심이 되는 서비스는 높은 확장성(Scalability)과 쓰기 성능을 가진 HBase가 유리하며 비슷한 이유로 라인이나 페이스북 메신저에서도 HBase를 사용하는 것이라고 짐작할 수 있습니다.로그 분석에도 HBase를 사용합니다비트윈은 사용자 로그 분석을 통해서 좀 더 나은 비트윈이 되기 위해서 노력하고 있습니다. 비트윈 사용자가 남기는 로그의 양이 하루에 3억건이 넘기 때문에 RDBMS에 저장하여 쿼리로 분석하기는 힘듭니다. 그래서 로그 분석을 위해 분산 데이터 처리 프레임워크인 Hadoop MapReduce를 이용하며 로그들은 MapReduce와 호환성이 좋은 HBase에 저장하고 있습니다. 또한 이렇게 MapReduce 작업들을 통해 정제된 분석 결과를 MySQL에 저장한 후에 다양한 쿼리와 시각화 도구들로 custom dashboard를 만들어 운영하고 있습니다. 이를 바탕으로 저희 Biz development팀(사업개발팀)이나 Data-driven팀(데이터 분석팀)이 손쉽게 insight를 얻어낼 수 있도록 돕고 있습니다.HBase를 사용하면서 삽질 했던 경험HBase를 사용하면서 처음에는 잘못 사용하고 있었던 점이 많았고 차근차근 고쳐나갔습니다. Region Split과 Major Compaction을 수동으로 직접 하는 등 다양한 최적화를 통해 처음보다 훨씬 잘 쓰고 있습니다. HBase 설정 최적화에 대한 이야기는 이전에 올렸던 블로그 글에서도 간단히 소개한 적이 있으니 확인해보시기 바랍니다.HBase 트랜잭션 라이브러리 해인사Haeinsa는 HBase에서 Multi-Row 트랜잭션을 제공하기 위한 라이브러리입니다. 오픈소스로 공개되어 있으며 Deview에서도 발표를 했었습니다. HBase에 아무런 변형도 가하지 않았기 때문에 기존에 사용하던 HBase 클러스터에 쉽게 적용할 수 있습니다. 비트윈에 실제로 적용되어 하루 3억 건 이상의 트랜잭션을 처리하고 있으며 다른 많은 NoSQL 기반 트랜잭션 라이브러리보다 높은 확장성과 좋은 성능을 가지고 있습니다.발표에서 사용했던 슬라이드를 첨부하였으니 도움이 되었으면 합니다.<iframe class="speakerdeck-iframe" frameborder="0" src="//speakerdeck.com/player/2b8092b02ff90131ef414aa7d272d735?" allowfullscreen="true" mozallowfullscreen="true" webkitallowfullscreen="true" style="border: 0px; background: padding-box rgba(0, 0, 0, 0.1); margin: 0px; padding: 0px; border-radius: 6px; box-shadow: rgba(0, 0, 0, 0.2) 0px 5px 40px; width: 750px; height: 563px;">
조회수 1166

CIFF(China International Furniture Fair) Part②공용가구(로비·라운지/퍼블릭) 

안녕하세요-!오늘은 저번에 포스팅한 상해가구박람회 Part①오피스가구에 이어서Part②공용가구(로비·라운지/퍼블릭)을 소개하도록 하겠습니다-오늘 소개드리는 Part②공용가구(로비·라운지/퍼블릭)는 좀 더 알록달록하고 다양하기 때문에 Part①오피스가구보다 재밌게 보실 수 있을 거 같아요!그래도~Part①오피스가구 한번 보고 오시는 거 추천드립니다 :)http://blog.naver.com/dongyeondesign/221113926835이제부터 Part②공용가구(로비·라운지/퍼블릭)를 소개하도록 하겠습니다. 가장 먼저 1인용 소파 입니다.  1. 1인용소파광저우가구박람회에서는 모듈소파를 많이 볼 수 있었는데 상해가구박람회에서는 대부분 1인용 소파였으며다양한 컬러를 사용하여 보는 순간 예쁘다! 하는 제품들을 많이 볼 수 있었답니다. 또한 직선보다는 곡선으로 이루어진 소파가 많았으며다리는 원목 또는 철재로 심플한 디자인으로 이루어진 소파가 많이 있었습니다. 휴게공간은 물론 사무실, 집에서도 사용할 수 있는 소파랍니다 :)앞에서 말씀드렸다시피 다양한 컬러를 사용하였고 곡선으로 이루어진 소파가 많죠?투톤으로 이루어진 컬러도 많이 볼 수있었답니다 투톤으로 되어 단조롭지않고 감각적으로 보인답니다 :) 2. 스툴다음은 스툴입니다. 1인용소파가 많아진 만큼 가볍게 사용할 수 있는 스툴도 많아졌답니다. 기존에 나오는 원형이나 사각형 외에 디자인이 가미 된 제품들을 많이 볼 수 있었는데앉기 편하게 오목한 디자인이라던가 이동이 용이할 수 있게 손잡이를 부착한 디자인 더나아가 높낮이 조절이 가능한 스툴까지 디자인뿐만 아니라 기능성까지 갖춘 스툴을 많이 볼 수 있었답니다!알록달록한 원형스툴은 앉아서 옆에 손잡이를 당기면 내려가고 일어나서 손잡이를 당기면 올라가는 제품입니다. 기존 사무용의자와 기능이 동일하다고 보면 될거같아요!가벼운 미팅공간에 딱딱한 사무용의자보다 이런 스툴의자를 두면 월씬 더 감각적이며 효율적인 미팅 공간이 될 거같아요! 조금 다른 스타일의 스툴입니다. 바의자 타입의 스툴이며 높낮이 조절이 가능한 제품이랍니다 :)3. 다용도의자, 소파다음은 다용도의자입니다. 가볍게 사용할 수있는 의자 또는 소파라고 생각 하시면 됩니다.위에서 보여드렸던 1인용 소파의 경우 안락느낌이 강한 반면 지금 소개드리는 의자와 소파는로비공간, 휴게공간, 회의공간, 카페 등 다양한 곳에서 사용가능한 소파랍니다 :)등좌판의 경우 플라스틱, 패브릭, 인조가죽, 펠트 등 다양한 소재로 마감이 되었으며다리는 철재, 다이캐스팅, 목재 등으로 이루어져 있답니다. 4. 플라스틱 사출 의자다용도의자 중 한가지인 플라스틱 사출의자입니다.  많은 종류의 플라스틱 사출의자를 볼 수 있어 별도로 소개드릴려고합니다 :)플라스틱 사출의자는 컬러가 다양하며 가볍고 곡선적이라는 특징이 있습니다.  5. 파티션세워두는 파티션 입니다. 구획을 나눌때 파티션을 많이 사용하는데 기존 파티션은 전체를 가리기때문에 답답할 수 있습니다. 광저우가구박람회에서도 볼 수 있었던 디자인이 들어가 세워두는 파티션입니다. 별도의 설치 없이 세워두기때문에 심플하며 편리하답니다!또한 디자인이 들어가서 재미있게 연출할 수 있답니다!6. 그 외그 외 귀여운 소파 테이블과 캐비닛 등 다양한 제품들이 전시되어있었답니다 상해가구박람회에서 본 공용공간은다양한 컬러의 소파와 투톤으로 이루어진 소파들을 많이 볼 수 있었습니다.또한 아기자기하며 곡선을 가미한 디자인을 많이볼 수 있었답니다공용공간 쪽은 광저우가구박람회와는 조금 달라진 트렌드를 볼 수있는 박람회였습니다!이상으로 Part②공용가구(로비·라운지/퍼블릭) 포스팅을 마치겠습니다 :)#상해 #가구박람회 #중국상해가구박람회 #ciff #외국가구박람회 #중국상해 #가구추천 #가구제안 #소파 #테이블
조회수 191

이미 벌어진 일에 자책은 짧게

올해 첫 신상으로 야심 차게 준비했던 스트레스컴퍼니의 감정카드가 인쇄사고가 났습니다... 두둥.... 보통 인쇄를 맡기면 감리를 가는데, 오래 거래하던 곳이기도 하고, 색감도 잘 맞춰주셨던 곳이라 독감의 여파로 그냥 믿고 맡기기로 했던 것이 화근이 되어버린 것입니다...원래 일정대로라면 월요일에 내 손에 들어왔어야 할 카드들인데, 총 50장 중 반이 앞뒤가 바뀌어버렸다고 합니다. 인쇄 끝났을 때 한 번만 확인했어도 알 수 있었을 문제를 코팅에 도무송까지 끝나고 나서야 인지하고 알려주신 사장님이 야속했지만;;; 아파서 정신없는 와중에 파일 체크를 제대로 하지 못했던 저의 탓이 더 크므로 남 탓은 하지 않기로 했습니다. 그렇지만 제 탓이라고 후회하지도 않을 겁니다. 자책한다고 이미 잘못된 인쇄가 다시 제대로 찍히는 것도 아니고, 기분이 나아지는 것도 아니기 때문입니다. 이미 벌어진 일에 자책은 짧게다음엔 더 철저하게 파일을 챙겨야겠다고 다짐하며 자책을 끝냈습니다. 어찌 됐던 카드는 다시 인쇄가 들어갔고, 어제저녁 다시 후가공을 마치고 나왔습니다. 대박이 나려고 액땜을 두세 번씩 하고 있는 것 같은 느낌적인 느낌입니다... 후덜덜 기존 내편 감정카드 10장기존 캐릭터들은 저작권 등록이 되어있었지만, 9개였던 카드를 50개로 확장하면서 늘어난 아이들을 어떻게 저작권 등록을 해야 하나 알아보다 보니, 개인이 직접 온라인에서 등록하면 1건당 2만 원에 할 수 있다는 사실을 알게 되었습니다. 이전에는 그걸 모르고 변리사 통해서 건당 30만 원에 했었...;;(다행히 등록비용을 지원받았었습니다만) 이번에는 그 작업을 직접 하기로 하면서 저작권위원회에 전화 상담을 자주 시도했는데, 그러다 이전의 제가 굉장히 중요한 실수를 했다는 사실을 알게 되었습니다... 2015년 첫 캐릭터의 저작권을 등록하던 당시에도 스트레스컴퍼니를 하고 있었는데, 어차피 내가 만든 거고, 또 내가 만든 회사니까 별다른 고민 없이 캐릭터의 저작권을 개인으로 등록했었는데요. 그런데 회사의 재산을 개인으로 저작권을 등록하면 허위등록으로 간주되어 보호를 받을 수 없다는 사실을 알게 되어 버린 것입니다. 그리고 저작권위원회에서는 그것을 바로 잡는 방법은 개인으로 등록한 저작권을 말소하고 다시 회사 이름으로 등록하는 방법뿐이라고 했습니다. 그렇게 하지 않으면 허위 등록으로 보호받을 수 없다고 하니 저로서는 다른 선택권이 없더군요..... 또르르. 왜 그 당시 변리사가 그 부분에 대해서 어떤 언급도 해주지 않았는지는 이해할 수 없었지만, 그 또한 지난 일.. 이 헛발짓 덕분에 고급 지식을 얻었다는 사실에 감사하며, 비싼 돈을 주고 등록했던 소중한 저작권들을 내 손으로 직접 말소 신청을 하고 다시 회사 계정으로 가입해서 다시 저작권을 신청했습니다. 휴우.. 한국저작권위원회  https://www.cros.or.kr이미 벌어진 일에 자책은 짧게어이없는 실수로 생각지도 못했던 비용이 들어가다 보니 정말 당황스러웠지만.. 그래도 지금이라도 알게 돼서 다행이라고 생각했습니다. 혹시나 저작권 분쟁이 생겼을 때, 그걸 알았다면 얼마나 땅을 치며 후회했을까요. 다음엔 좀 더 세심히 챙겨보겠다고 결심하며 두 번째 자책을 마쳤습니다. 그래도 직접 저작권을 등록하는 일은 간단하더군요. 이미지를 올리고 캐릭터에 대한 설명을 쓰고 비용을 결제하면, 신청이 완료되는데 설명이 부족하면 다시 보완하라고 예시까지 써서 알려주시더라고요. 친절한 저작권위원회. 그렇게 무사히 저작권 등록을 마쳤고, 감정카드도 제 손에 들어왔습니다. 반갑다 얘들아!!!저는 지금 행복해요!당신, 오늘 기분 어때요?모르겠는뒈?우리는 친구들에게 "밥 먹었니?"라는 인사는 하지만, 기분이 어떠냐고는 잘 묻지 않죠. 왜??? 어색해서. 쑥스러워서. 해본 적이 없어서... 등등의 이유는 많겠지만, 이제는 우리도 알고 있습니다. 우리의 감정이 얼마나 소중한지 말입니다. 앞으로는 스트레스컴퍼니의 감정카드로 당신과 나의 감정의 안부를 물어봐 주세요.  귀여운 50장의 카드는 11cm x 8cm 틴케이스에 포장될 예정입니다.오늘의 감정하루에도 몇 번씩 오르락내리락하는 내 마음. 자기 전까지 기억에 남아있는 감정들을 감정카드로 하나씩 꼽아보며 "오늘 내 마음이 이랬구나." 하고 감정을 읽어주세요. 힘든 감정이라고 회피하거나, 무시하지도 말고요. 분명히 있는 감정을 모른척하면 어느 순간 치밀고 올라올지 모르거든요. 감정을 받아들여야 흘려보낼 수도 있습니다. 인정하고 싶지 않은 감정일지라도 그 마음을 받아들이고, 내 마음이 이만큼 괴로웠구나 하고 인정하고 나면, 언제 그랬냐는 듯 그 감정은 더 이상 나를 괴롭히지 않을 거예요. 그렇게 해도 힘들다면, 감정 다이어리를 써보세요. 힘든 감정들을 글로 쓰는 만큼 감정을 비워낼 수 있습니다. 친구들에게 조차 내 마음을 터놓기가 어렵다면, 어느 순간 연인과 거리가 멀어진 것처럼 느껴진다면,  감정카드를 펼쳐놓고 이야기를 시작해보세요. 서로의 감정에 맞는 카드들을 골라보고 카드 뒷면에 적힌 질문을 함께 나누며 마음속 이야기들을 꺼내보세요. 미처 몰랐던 면을 이해할 수 있는 기회가 되어줄 거예요. 감정에 솔직한 당신, 감정을 책임질 줄 아는 당신이 정말 멋집니다.모든 감정에는 이유가 있다감정에 대한 상품들을 만들고 사람들과 프로그램을 진행하면서 정말로 좋아진 건 다름 아닌 바로 저의 성격입니다. 이전의 제가 화가 날 때 그 감정을 주체하지 못하고 쏟아냈었다면, 지금의 저는 그래도 잠시 멈추고 내가 화가 났구나 라는 사실을 인정하려고 노력합니다. 그리고 그 감정에서 벗어나 기분을 전환하려고 합니다. 그렇게 해서 감정이 좀 가라앉은 후에는 찬찬히 다시 감정들을 돌아보며 나의 화가 어디서 온 것인지를 생각해보는데요. 그때 많은 성찰이 일어나곤 합니다.이전의 저였다면, 인쇄사고 나다니 말도 안 된다며 끝도 없이 자책을 하고, 후회에 후회를 거듭했겠지만, 그런다고 달라지는 일은 없습니다. 내가 어쩔 수 없는 일은 그냥 그렇게 내려놓는 것이 정답입니다. 아무리 나를 괴롭힌다고 해도 달라지는 일은 없으니까요. 나란 놈의 실수를 응원해주세요. 그리고 그 실수를 통해 나를 더 키워나가는 기회로 삼읍시다. 우리는 죽을 때까지 성장해야 하는 불완전한 인간들이니까요. 그렇게 한 발짝씩 함께 나아갑시다. 우리.   스트레스컴퍼니의 2018년 신상인 감정카드 50장 세트는 와디즈를 통해서 펀딩에 참여하실 수 있습니다.  https://www.wadiz.kr/web/campaign/detail/17822 스트레스컴퍼니의 모든 상품은 스트레스컴퍼니샵에서 구매 가능합니다.ⓒ스트레스컴퍼니 - 무단 전재-재배포 금지#스트레스컴퍼니 #심리스타트업 #스트레스관리 #서비스소개 #제품소개
조회수 1254

음성 기반 인터페이스와 TPO

필자가 재직 중인 일정 데이터 스타트업 히든트랙(린더)은 현재 SKT NUGU, Google Assistant에서 '아이돌 캘린더'라는 이름의 일정 검색/구독 서비스를 운영 중이며, 삼성 빅스비와 협업을 통해 내년 상반기 전시/공연 일정 검색/구독 서비스 상용화를 앞두고 있다.세계적으로도 아직 음성 관련 서비스 사례가 많지 않은 상황에서 VUI 기반 서비스 개발에 도움이 될만한 자료를 국내에서 찾기는 더더욱 쉽지 않았고, 향후 음성 기반 서비스를 준비하는 다른 이들이 우리가 겪었던 시행착오를 줄일 수 있기를 바라는 마음으로 간단하게 5부작 형태의 글로 우리가 고민해온 과정을 준비해보았다.1편: 음성 기반 인터페이스의 등장2편: 음성 기반 인터페이스와 TPO3편: 음성 기반 인터페이스와 페르소나4편: 음성 기반 인터페이스 vs GUI5편: 국내 음성 기반 인터페이스 현황1편의 말미에서 언급한 바와 같이 이미 다수의 메이저 업체들이 수년간 경험과 데이터를 기반으로 다양한 VUX 가이드라인을 제시하고 있다. 그리고 그 가이드라인에서 공통적으로 제안하는 VUX 디자인 첫 번째 단계 중 하나는 바로 '구체적인 사용자 환경의 설정'이다.VUX 디자인의 첫 번째 단계는 제공하고자 하는 서비스의 타겟 사용자와 사용자의 상황을 분석하고, 제공할 주요 기능을 목록으로 정의하는 단계입니다. 즉, 이 서비스를 어떤 사용자가 어떤 환경에서 주로 이용할 것인지를 고려하여 제공할 기능 범위를 정의합니다.SKT NUGU VUX가이드라인 중'사용자의 환경'을 구성하는 요소는 매우 복합적이지만 여러 요소들 중에서도 가장 큰 비중을 차지하는 것은 바로 TPO, 즉 시간(Time), 장소(Place), 상황(Occasion)이다.시간과 장소가 동일하더라도 상황이 다를 수 있으며 장소와 상황이 동일하더라도 시간에 따라 사용자의 경험이 달라질 수 있다. 마찬가지로 시간과 상황이 동일하더라도 발화가 이루어지는 장소에 따라 완전히 다른 사용자 경험을 구성하게 된다.몇년 전부터 스피커 등 VUX 서비스를 운영하고 있는 협력사들의 누적된 발화 데이터를 통해 발견할 수 있었던 흥미로웠던 점은 각 TPO에 따라 사용자들이 디바이스, 즉 AI를 대하는 태도가 현저히 상이하다는 점이었다. 일례로 침대 머리맡에 놓여있는 같은 스피커에게 하는 말도 출근 전과 퇴근 후의 요청사항 및 표현 방식이 다르고, 같은 스마트폰에게 하는 요청사항과 표현도 사적인 공간에 있는지, 공적인 공간이 있는지에 따라 확연히 달라진다는 것이다.사용자 경험은 단순히 사용자가 디바이스를 대하는 태도와 요청사항뿐만 아니라 디바이스가 가진 특성에 따라서도 달라질 수 있는데, 각 디바이스가 가진 여러 특이사항 중에서도 가장 중점적으로 살펴볼 부분은 바로 시각적 정보를 전달하는 디스플레이의 존재 여부다.TPO를 구분하는 방법은 여러가지가 있지만 이번 글에서는 구글에서 안내하는 어시스턴트의 4가지 주요 환경을 바탕으로 사용 환경의 차이를 알아보고자 한다.https://assistant.google.com/intl/ko_kr/휴대전화(스마트폰)에서스마트폰은 가장 개인적이고 친밀한 디바이스인 동시에 대표적인 On-the-Go, 즉 언제 어디에서든 사용되는 디바이스다. 사용자가 다수로 지정될 수 있는 스피커와는 달리 개인 1인 당 1대의 디바이스가 할당되기 때문에 사적인 정보를 스스럼없이 털어놓을 수 있게 된다.특성상 사용 시간대와 장소는 어느 한 시점에 국한되지 않으며 메신저, 캘린더 등 일상적인 정보를 가장 가까이서 제공할 수 있는 장점이 있다. 스피커와는 달리 디스플레이가 제공되기 때문에 시각 콘텐츠에 대한 접근이 용이하며, 현재 아이폰 시리와 삼성 빅스비에서 주로 많이 사용되는 기능들로는 기상 알람 세팅, 뉴스/날씨 읽어주기, 메시지 읽어주기, 맛집 검색 등이 있다.집에서집에서 제공되는 VUX 경험은 거주와 생활 형태에 따라 크게 두 가지로 나뉠 수 있다. 크게 개인이 혼자서 디바이스를 활용하게 되는 1인 1 디바이스 형태와 가족들이 함께 하나의 디바이스를 활용하는 다가구 1 디바이스 형태로 나뉘며, 개인이 디바이스를 소유하는 경우 스피커는 주로 사용자가 수면을 취하거나 가장 많은 시간을 보내는 개인 침대 인근 책상 또는 선반에, 가족이 함께 사용하는 디바이스의 경우 거실, 부엌 등의 공용공간에 위치하게 된다.위 언급된 두 시나리오 모두 음악, 뉴스, 날씨 등 청각 콘텐츠를 제공하지만 1인 1 디바이스의 경우에서 디바이스와 보다 높은 친밀도가 형성되는 것을 확인할 수 있으며, 이러한 사용자 시나리오를 카카오 미니의 카톡 읽어주기, 네이버 클로바 연애상담 등의  기능들이 조금씩 추가되고 있다.TV에서현재 KT와 SKT는 기기자니2와 NUGU Btv를 통해 셋톱박스 기능을 탑재하고 있는 스피커를 제공하고 있다. 구글 홈, 네이버 클로바, 카카오 미니 등도 TV와의 연동을 통해 기본적인 채널 변경, 음량 조절 등을 제공하지만 콘텐츠 검색 등 TV 디스플레이의 장점을 100% 활용하기 위해서는 결국 셋톱박스의 역할을 할 수 있어야 한다(구글의 경우 크롬 캐스트 활용이 가능하지만 국내 활용도가 높지 않다). 주로 TV 옆, 또는 TV 자체로 디바이스 역할을 하게 되며 평균적으로 개인 소유 디바이스 중 가장 큰 디스플레이를 제공하는 TV의 특성상 다양한 시각 콘텐츠 검색 및 소비가 가능하다. 1인 1 디바이스에서 주로 위치하는 침대 인근 책상/선반과는 달리 TV의 경우 다가구 1 디바이스의 상황이 자주 발생하며, 구글 등 주요 업체는 사용자 별 목소리 구분 기술을 통해 다가구 1 디바이스 활용 사례에 대비하고 있다.자동차에서우리가 광고를 통해 '자동차에서'의 음성 인터페이스 시나리오를 자주 접하게 되는 이유는 '자동차'라는 환경이 음성 기반 인터페이스의 장점이 극대화되는 공간이기 때문이다. 한 겨울에 거리에서 메시지를 보내는 경우처럼 분명히 음성 인터페이스가 용이할 수 있는 상황에서도 우리가 공공장소에서 음성 인터페이스를 자주 활용하지 않는 이유 중 하나는 '소리 내어 주목을 끌지 않고 싶기 때문'으로 볼 수 있다.결과적으로는 운전 중 수동 조작이 어렵다는 환경의 특성과 더불어 발화 내용이 외부에 노출되지 않는 매우 개인적인 공간이라는 특성 덕분에 광고를 넘어 실제로도 음성 인터페이스가 가장 활발하게 활용되는 사용자 시나리오 중 하나로 꼽히고 있으며, 차 내에서의 킬러 앱인 내비게이션의 음성 인터페이스 연동 여부가 가장 중요한 포인트라 할 수 있다.개인적으로는 내비게이션 VUI 서비스 중 SKT의 T-MAPxNUGU가 사용자 환경과 시나리오를 바탕으로 세계에서도 상당히 높은 수준의 서비스를 구현해낸 서비스라 생각된다(무엇보다 GUI와 VUI의 적절한 배합이 인상적이다).모든 서비스가 모든 환경에서 최적의 경험을 제공할 수는 없다. 공용 공간에서 메신저/캘린더 등의 개인 정보와 연동된 개인적인 경험을 누리기는 어렵고, 시각 디스플레이가 없는 상황에서 맛집이나 옷을 검색하고 구매하는 경험을 누리기는 어렵다.  아침 기상 후에 필요로 되는 서비스와 운전 시에 필요로 되는 서비스, 취침 전에 필요로 되는 서비스는 각기 다르며 VUI 디자인을 시작하기 위해서는 각 TPO에 맞는 기획이 필요하다.  결과적으로 사용자가 AI의 어떤 '성격'을 원할지 (친근한 친구 같은 AI vs 딱딱한 비서 같은 AI)는 TPO에 따라 상이할 수 있으며, TPO 설정 시 사용자와 서비스에 대한 페르소나 설정이 동시에 진행 되어야만 한다.3편: 음성 기반 인터페이스와 페르소나에서 계속.#히든트랙 #음성기반기술 #음성기반UX/UI디자인 #스타트업인사이트 #경험공유
조회수 890

육아도 경력이 될 수 있을까?

과거의 오늘을 보여주는 한 SNS에서 5년전 내가 쓴 글을 만나게 되었다. 5년전 나는 출산을 3개월 정도 앞둔 임산부였고, 아프리카에서 돌아와 간신히 얻은 일자리를 포기한 경력중지상태였다. 글에는 당시 내가 느낀 불안함과 무기력함이 가득 담겨 있었다. 어떻게 잊을 수 있을까. 나는 그때의 내 마음이 너무나 또렷하게 기억이 난다. 아이를 만나는 것은 기대되는 일이고 축복임이 분명했지만, 내 마음 한 구석에는 ‘나는 이제 끝났어’ 라는 절망감이 늘 공존했었다.그렇게 출산 후 아이를 기르다가, 처음으로 용기를 내어 지원한 서류가 통과하여 면접을 보러 가던 날도 기억이 난다. 오랜만에 입은 정장 바지는 지퍼가 도무지 올라가지 않았고, 결국 수습할 수 없는 삐죽삐죽 잔디머리를 한 채로 면접을 보러 갔었다. 붙고 안 붙고를 떠나 그것은 나의 투쟁이고 오기였다. 아직 나는 살아있다는 외침임과 동시에, 지금이 아니여도 좋으니 언제라도 다시 용기를 내기 위한 예방주사 같은 도전이었다. 하지만 면접을 마치고 돌아오는 길에 나는 우울했다. 출산 후 아이를 키우는 동안 내가 얼마나 사회와 동떨어지게 되었는지를 온몸으로 느꼈기 때문이었다. 나는 확실히 긴장했고 위축되어 있었다. 누가 묻지도 않았지만, ‘사실 나는 아이를 키우는 엄마예요’ 라고 이야기를 해야 했던 것은 아니었을까 라는 생각도 들었다. 그 후로 꽤 오랜 시간, 나는 내가 가진 모든 능력이 모두 사라져 버린 것 만 같다는 생각에 몹시 큰 불안을 느꼈다.사실 한 회사를 운영하는 대표로 살고 있는 지금도, 여전히 나는 위축되는 마음을 종종 느끼곤 한다. 아이에게 예기치 못한 변수가 생길 때, 엄마이기에 어쩔 수 없는 시간의 제약을 느낄 때, 저녁에는 아이를 돌보느라 전화를 받을 수 없을 때.. 사회생활을 어렵게 하는 순간을 마주할 때 마다, 다른 보통의 사회생활을 하는 사람보다 항상 어딘가가 부족하다는 생각을 하게 된다.그런데 우리는 정말 엄마가 되면서 모든 능력이 멈추거나 사라지게 된걸까?  곰곰히 생각해보면 그렇지 않다. 과거의 내 모습을 생각해보면 오히려 지금의 나는 여러모로 깊고 넓어져있음을 느끼게 된다. 엄마라는 역할이 개발시킨 능력이 참 많다.이전에는 나와 다른 생각을 가진 사람을 수용하는 것이 참 힘들었지만 이제는 거의 다 견딜만하다는 생각이 든다. 아이의 울음소리 짜증소리 엄마미워 라는 그 땡깡을 하루에도 수십번 참아낼 만큼 인내력을 가지게 되었기 때문이다. 또 하루에도 수백번씩 무언가를 요구하는 아이를 키워내며 동시에 살림을 비롯한 여러 가지 일을 처리할 수 있는 멀티태스킹도 가능하게 되었다. 이전의 나는 다른 사람의 감정에 이렇게 까지 주의를 기울일 필요가 없었지만, 이제는  내 감정을 처리하려고 노력하는 것은 물론이고 아이에게 공감하고 민감해지려고 노력하게 되었다. 하기 싫으면 대충하거나 회피했던 내가 엄청난 책임감이 생겨, 아이 우는 소리에 벌떡벌떡 깨며, 졸린 눈을 비비며 아이를 돌보는 초능력도 갖게 되었다.그뿐인가? 아이를 키우며 어떤 어려운 일도 도망가지 않고 해결해보려고 노력하게 되었으며, 아이의 눈짓과 몸짓을 표정을 보며 왜 그렇게 하는지 눈치챌 만큼 엄청난 센스도 보유하게 되었다. 돌이켜 보면 엄마가 되기 전에는 도저히 할 수 없었던 많은 일들을 이제 나는 할 수 있게 되었다. 엄마로 살면서, 나는 이전보다 더 시간을 아끼며 집중하는 지혜를 갖게 되었다.그러고 보면, 엄마로 보낸 시간도 우리에겐 경력이다. 우리는 멈추지 않았고 사라지지 않았다. 아이를 돌보는 정신 없는 일상에서도 우리는 성장하는 방향으로 가고 있었다. 확실히 우리는 이전의 우리가 아닌 것이다. 우리가 엄마로 살면서 갈고 닦은 많은 능력은 엄마로서 뿐 만 아니라 어느 곳에서 어떤 일이든 할 수 있을 만큼 유용한 것이다. 회사라는 조직과 업무에 적응할 수 있는 기회와 용기가 우리에게 주어진다면, 조금만 가정과 일을 함께 해나갈 수 있는 환경이 주어진다면, 우리는 엄마경력기간 동안 갈고 닦은 모습을 발휘하며 일할 수 있을 것이다.나는 이제 엄마를 경력으로 부르기로 다짐했다. 아직은 사회가 엄마와 경력을 같은 선 위에 두지 않지만, 그렇게 부르고자 하는 작은 노력들은 반드시 필요하며 의미가 있다고 생각한다. 그리고 이러한 메시지를 만들어 가고자, 소셜벤처 몇 곳이 함께 엄마경력자인 여성들을 위한 프로젝트를 시작하려고 한다. 엄마라는 역할 안에 있는 나를 발견하게 하고 세상과 연결되는 과정을 만들어가며, 작지만 의미 있는 메시지를 사회에 전달해보고자 한다. 사소해 보이는 작은 움직임들이 모여, 엄마라는 역할을 바라보는 새로운 관점들이 모여 의미 있는 변화를 만들어가게 되길 기대해본다.#그로잉맘 #경단녀 #경력단절여성 #엄마도경력이다 #일하는엄마 #육아와일 #스타트업CEO #기업문화 #여성복지
조회수 9117

AWS Lambda에서 메모리 설정값과 CPU 파워의 관계

안녕하세요. 데이블 백엔드 개발팀 최형주입니다.이번에 말씀드릴 내용은 서버 없는 컴퓨팅(Serverless Computing)의 널리 사용되는 AWS(Amazon Web Service)의 Lambda에 대한 내용입니다. AWS Lambda는 메모리 설정값에 따라 CPU 파워가 결정되는데, 그 메모리 설정값에 따라 CPU 파워가 어떻게 변화하는지에 대한 실험 내용을 설명하겠습니다. 처음에 AWS Lambda가 무엇인지 간략하게 소개를 하고 왜 이번 실험을 하게 되는지 배경 설명을 드릴 것입니다. 그다음 메모리 설정값에 따른 CPU 파워는 어떻게 결정되는지를 규명하고 마지막으로 이번 포스트를 간략히 요약겠습니다.목차1. AWS Lambda란?2. 실험배경3. 메모리 설정값과 CPU 파워의 관계4. 요약AWS Lambda란?AWS Lamba의 웹사이트AWS Lambda는 이벤트에 응답하여 코드를 실행하고 자동으로 기본 컴퓨팅 리소스를 관리하는 서버 없는 컴퓨팅 서비스입니다. 즉 코드를 업로드 하기만 하면 높은 가용성과 확장성을 보장하는 Lambda 플랫폼에서 코드를 실행합니다.AWS Lambda를 사용의 장점은 서버관리 불필요(Serverless), 지속적인 조정(Scaling), 밀리 초 단위의 측정 및 과금(Demand-based Pricing)입니다. 즉 서버를 프로비저닝(Provisioning)하거나 관리할 필요 없이 AWS Lambda에서 코드를 자동으로 실행하기 때문에 코드를 작성하고 AWS Lambda에 업로드하기만 하면 됩니다. 또한, 각 트리거에 대한 응답으로 코드를 실행하여 애플리케이션을 자동으로 확장하거나 축소합니다. 즉 코드는 병렬로 실행되고 각 트리거는 개별적으로 처리되어 정확히 워크로드(Workload) 규모에 맞게 조정됩니다. 과금 방식은 100밀리 초 단위로 코드가 실행되는 시간 및 코드가 트리거 되는 회수를 기준으로 요금이 부과됩니다. 코드가 실행되지 않을 때는 요금이 부과되지 않습니다.실험 배경AWS Lambda의 과금은 요청 요금과 컴퓨팅 요금의 합으로 계산됩니다. 요청 요금은 Lambda 함수를 호출한 총 요청 수에 대해 요금을 부과하고, 컴퓨팅 요금은 사용자가 업로드한 코드를 실행한 시간을 계산하여 100ms당 요금을 부과합니다. 컴퓨팅 요금은 사용자가 설정한 메모리 크기에 선형 비례하여 다르게 부과됩니다. 예를 들어 128MB 메모리에서는 100ms당 0.000000208$이고 256MB는 128MB의 약 두 배인 0.000000417$입니다. 그리고 512MB에서는 256MB의 두 배인 0.000000834$입니다. 또한, 더 큰 메모리를 사용할수록 더 큰 CPU 파워를 제공합니다.가장 큰 메모리 설정값을 사용하면 좋겠지만, 비용적인 측면을 고려해볼 때 사용자 입장에서의 사용 목적은 AWS Lambda로부터 최소한의 요금으로 최대한의 계산 효율을 뽑아내는 것입니다. 이 목적을 달성하기 위해서는 Lambda 함수를 실행할 때 메모리의 크기와 CPU의 파워(코어 수, 연산능력)를 명확하게 규명할 수 있어야 합니다. 메모리 크기는 사용자가 설정할 수 있습니다. 하지만 아쉽게도 아마존에서는 CPU 용량은 설정한 메모리 크기에 비례하여 결정된다고만 설명되어 있고 어느 정도의 성능을 가졌는지 명시하지 않고 있습니다.하지만 데이블의 백엔드 개발팀에서, 실험을 통하여 AWS Lambda에서 메모리 설정값에 따라 CPU 파워가 어떻게 변하는지 규명해냈습니다. 이제 그것을 이 포스팅을 통해 설명해 드리고자합니다.메모리 설정값과 CPU 파워의 관계"설정한 메모리 크기와 CPU 파워는 지수적 감쇠 관계(Exponential Decay)를 보인다"앞서 "CPU 파워는 메모리 설정한 값에 비례하여 증가한다”라고 했습니다. "그러면 어느 정도로 어떻게 비례하는가?”, “당연히 선형관계 아닌가?"라는 질문이 자연스럽게 나올 것입니다. 저희는 이 질문에 대답하기 위해 각 메모리 설정값별로 100만 번의 덧셈연산을 하여 각 설정 별 처리시간을 계산해 보았습니다. 다음 [그림 1]은 100만 번의 덧셈 연산을 했을 때 처리시간을 나타낸 그래프입니다. X축은 할당한 메모리의 크기를 나타내고 Y축은 처리시간을 초 단위로 측정한 것입니다. 보시는 바와 같이 처리시간은 메모리 크기에 따라 지수적으로 감소함을 알 수 있었습니다. 그러므로 AWS Lambda에서는 설정한 메모리 크기와 CPU 파워는 지수적 감쇠 관계(Exponential Decay)를 보인다고 결론을 내릴 수 있습니다. 예를 들면 현재 설정한 메모리보다 2배 높은 CPU 파워를 사용하고 싶으면 2배로 큰 메모리 용량을 설정해야 합니다.[그림 1] 메모리 설정값에 따른 처리시간필요로 하는 메모리 크기와 사용하는 응용에 따라 다르겠지만, 일반적으로 메모리의 크기에 상관없이 사용하는 비용이 거의 같다고 얘기할 수 있습니다. [그림 2]는 앞서 100만 번 덧셈 연산을 1만 번 호출했을 때의 각 메모리 설정값 별 요금을 나타낸 것입니다. X축은 설정한 메모리 크기이고 Y축은 각 메모리 설정값 별 요금입니다. 보시는 바와 같이 분포가 급격히 변하지 않고 대체로 균일한 것을 알 수 있습니다.[그림 2] 메모리 설정값에 따른 요금하지만 프로그램의 실행 시간은 단순히 CPU 파워로만으로 처리 시간이 결정되지 않기 때문에 다양한 요인을 검토해야 합니다. 알고리즘의 시간복잡도, 메모리의 크기와 접근 횟수, 네트워크 비용 등 다양한 것들이 처리 시간에 영향을 미치기 때문에 단순히 메모리 설정값을 늘려서 사용하는 방법은 옳지 못합니다. 그러므로 위 자료를 참고 용도로만 사용하셔서 하고자 하는 목적에 맞게 가장 최적의 메모리 설정값을 설정하시면 됩니다.요약AWS Lambda는 대표적인 서버 없는 컴퓨팅 서비스입니다. AWS Lambda에서 뛰어난 가성비를 얻고자 할 때는 각 설정값에 따라 제공하는 자원을 예측할 수 있어야 합니다. 여러 설정값 중 가장 성능에 큰 영향을 미치는 것은 사용하고자 하는 메모리 크기인데 이 크기에 따라 CPU 파워가 결정됩니다. 하지만 각 메모리 설정값에 따른 CPU 파워 정보를 아마존에서 제공해 주지 않고 있으므로 실험을 통해서 확인하였습니다. 실험 결과 설정한 메모리 크기와 CPU 파워는 지수적 감쇠 관계(Exponential Decay)를 규명했습니다. 이 규명은 단순한 프로그램에서만 확인한 것이기 때문에 최고의 효율을 가지는 AWS Lambda를 사용하기 위해서는 그 밖의 다양한 것들을 고려하여 설정해야 합니다.  기타머신 성능 및 정보- 사용하는 CPU는 Intel(R) Xeon(R) CPU E5-2666 v3 @ 2.90GHz, 코어의 개수는 2개, 그리고 캐시의 크기는 25600 KB 임(사용하는 Microcode는 바뀔 수 있음)- 메모리는 약 3.67GB를 가짐실험에 사용한 Lambda 함수import osimport multiprocessingimport timeimport subprocessdef lambda_handler(event, context):mem_bytes = os.sysconf('SC_PAGE_SIZE') * os.sysconf('SC_PHYS_PAGES')mem_gib = mem_bytes/(1024.**3)num_cores = multiprocessing.cpu_count()#start_time = time.time()print subprocess.check_output ('vmstat -s', shell=True)sum = 0for i in range(1000000):sum += iif sum 000 == 0:print subprocess.check_output ('vmstat -s', shell=True)print subprocess.check_output ('vmstat -s', shell=True)hostname = subprocess.check_output ('hostname', shell=True)cpuinfo = subprocess.check_output ('cat /proc/cpuinfo', shell=True)meminfo = subprocess.check_output('cat /proc/meminfo', shell = True)print hostnameprint '--------------------------------------------------------------\n\n'print 'CPU Information'print cpuinfoprint '--------------------------------------------------------------\n\n'print 'Memory Information'print meminfoprint '\n\n\n\n'참고 자료https://aws.amazon.com/ko/lambda/details/#데이블 #개발 #개발자 #인사이트 #꿀팁 #AWS #조언
조회수 1194

[어반테이스트] 와인과 함께한 곱창싸롱!

"지그므은~~~~ 곱.창.시.대!"(출처) MBC '나 혼자 산다'2018년 동시대를 살고 있는 분이라면 요즘 이 음식을 빼놓을 수가 없죠.바로바로 '곱창'먹어도 먹어도 질리지 않고,생각할수록 설레이는 음식이에요 ><어반테이스트라는 맛집탐방 복지문화가 시작되고 '왜 곱창 먹고 오신 분이 없을까....'의문이 들던 찰나에!드.디.어. 곱창 테이스트를 즐긴 팀이 생겼어요! 곱창 맛집 썰을 풀기 전에 잠깐! 곱창 지식 좀 풀고 가실게요 <알면 쓸데 있는 곱창지식>(출처) doopedia.co.kr곱창은 소의 작은 창자 즉 소창을 말하는데 보통 소의 내장을 통틀어 이야기 한대요!왼쪽에서부터 순서대로 양깃머리, 벌양, 간/처녑, 막창(홍창)왼쪽부터 곱창, 대창첫 번째 위가 양, 두 번째 위가 벌양, 세 번째 위가 처녑, 마지막 위를 막창이라고 하고, 위 다음에 연결된 소장과 대장을 각각 소창, 대창이라고 해요!식당에서 양곱창이라고 하는 것은 양(羊)의 곱창이 아니라 첫 번째 위인 양을 의미합니다. [양깃머리]양깃머리(특양)는 양에서도 두툼한 부위로 여러 내장들 중 가장 비싸고 주로 구이용으로 사용합니다. 소 한마리에서 나오는 특양 부위의 양이 많지 않아서 가격이 비싸다는....기름기가 없는 담백한 맛이고 기름진 대창과 잘 어울려서 양대창으로 묶어 부르기도 한대요. [벌양]벌양은 벌집양이라고 불리고 모양이 벌집(honey comb)을 닮아서 그렇게 이름을 붙였대요. [처녑]세 번째 위인 처녑은 1000장의 잎사위가 붙어있는 모습이라 천엽(千葉)이라고 부르기도 한대요. 구이용으로 거의 사용하지 않고 주로 간과 함께 생으로 먹는다고 합니다.저희도 애피타이져로 모둠 구이가 익는 동안 간과 처녑을 먹었지용~[막창]막창은 소의 마지막 위로 홍창이라고도 불리고 대구지역에서 유명합니다. [대창]소창 다음에 연결된 것으 좀 더 굵은 대창입니다. 원래 모습이 바깟쪽에 기름이 달려 있는데 그것을 뒤집어 안쪽으로 넣은 것입니다. 대창의 기름은 콜레스테롤 수치를 올리므로 많이 먹으면 건강에 좋지 않습니다만, 너무 고소하고 부드럽고 맛 있어서 일단 고민하지 말고 먹읍..시다![염통]염통은 심장을 말하고  가장 빨리 익기 때문에 먼저 먹어야 합니다!★ 먹는 순서 ★간, 천엽 -> 염통 -> 벌양, 양 -> 대창 -> 막창, 소창(참고) http://egloos.zum.com/hsong/v/3163122)그럼 어느정도 지식을 습득했으니이제 곱창 먹방 후기를 풀도록 하겠습니다 :) "와인과 함께한 곱창싸롱!"- 영업시간: 00시~24시 - 주소: 서울 강남구 언주로93길 31 (지번: 역삼동 677-1)  곱창싸롱 <지도보기>이번 테이스트는 역삼역 곱창 맛집 '곱창싸롱'이에요 !곱창 테이스트 멤버는 개발팀의 현목님, 종훈님과 CRO 강록님입니다!팀 결성 후 퇴근시간에 맞춰회사에서 5분거리에 있는 곱창싸롱을 갔습니다!"아 신난다~ 이 지역 곱창 몬스터는 내가 다 잡아야지~""우리 저기를 향해 갈꺼에요~"드디어 입성! 할렐루야!이것은 곱창싸롱의 메뉴입니다!모둠구이 200g (곱창+대창+막창+염통) --- 1.6만곱창 200g 1.8만막창 200g 1.6만대창 200g 1.6만특양 150g 1.9만염통 200g 1.2만깍양밥 1인분 1.2만(깍두기+특양+비빔양념+계란크러스트)이외에도곱창전골 1.2만올치다다 1.0만등의 메뉴가 있어요!저희 어반 테이스트 4기가 공략한 메뉴는 모듬구이와 깍양밥!모둠구이 3인분가운데 돌돌 말린 것부터 반시계방향으로 곱창, 대창, 염통, 막창이여요 :)물론 오발탄, 연타발 등 비싼 곱창집에 비해선 퀄리티가 좋진 않지만 그래도 저렴한 가격치곤 제법 맛있었어요 ㅎㅎ간과 천엽! 기름장에 찍어먹으면~~ 츄릅!곱창집에서 올리브를??여기는 그린, 블랙 올리브를 허브와 오일에 살짝 볶아서 나오는 것 같아요! 독특한 향이 납니다~~~~~기본으로 세팅할 때 한번 주시고 원하면 추가로 주문해야 할 것 같아요. 따로 메뉴가 있네요. 강록님이 대파 양념을 첨가하여 요리를 하신 맛나보이는 곱창 대파구이~깍양밥 1인분 /  12,000원 볶음밥류 치고는 비싼편이지만 요거요거 맛있었어요!곱창싸롱은와인을 가져가면 인당 5천원의 와인콜키지로 맛있는 곱창과 와인을 즐길 수 있습니다!테이블에 앉아서 먹을 수도 있고, 양철통 위의 스텐리스 테이블에서도 스툴에 앉아 먹을 수 있어요~그래서 현목님이 이날 와인을 준비해 오셨다는.. ㅋㅋㅋ"이거슨 스페인산 마트표 맛난 와인입니다. 3병에 2만원정도로 할인할 때 (집더하기에서) 사왔는데 맛있어요." - 문믈리에Campo Lindo Chrianza 스페인 Rioja 지역 와인. Cabernet Sauvignon, Tempranillo 품종 블랜딩. 2014년 빈티지. 와인과 곱창의 만남! 제법 신선하죠?와인과 곱창의 조합은 처음이었지만 제법 신선하면서 감동적이였습니다 ㅋㅋㅋ우리의 곱창싸롱 점수는?(5점 만점에)곱창싸롱은역삼역 인근 저렴하면서 이색적인 곱창을 즐기고 싶은분에게 추천합니다 :)곱창먹고 행복지수 120%취한거 아닙니다.....다음 '어반 테이스트'도 기대해 주세요 :) 출처: https://blog.naver.com/urbanbaseinc 
조회수 791

컴공생의 AI 스쿨 필기 노트 ④ 교차 검증과 정규화

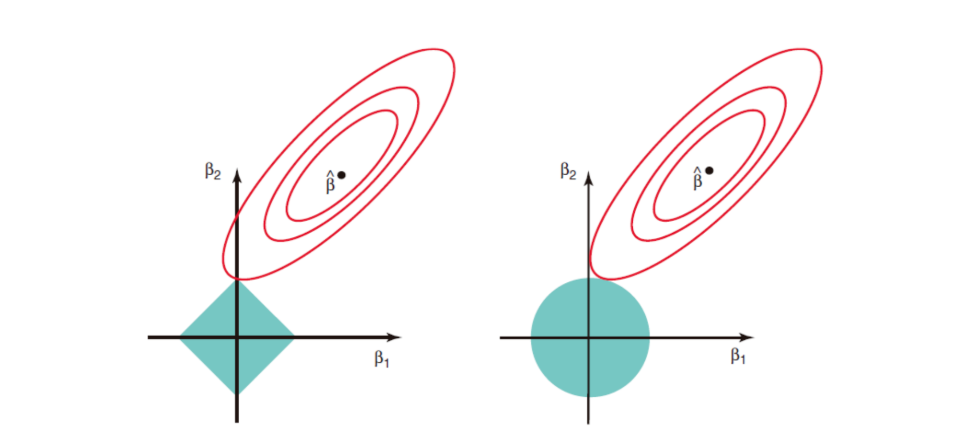
지금까지 Linear Regression, Logistic Regression 모델을 만들어보았는데요. 우리가 만든 모델이 과연 잘 만들어진 모델이라고 볼 수 있을까요? 이를 알기 위해서 이번 4주차 수업에서는 우리가 만든 모델의 적합성을 보다 객관적으로 평가하기 위한 방법으로 교차 검증(Cross Validation)과 정규화(Regularization)를 배웠어요. 차례대로 하나씩 알아볼까요?1. Cross Validation교차 검증은 새로운 데이터셋에 대해 반응하는 모델의 성능을 추정하는 방법이에요. 학습된 모델이 새로운 데이터를 받아들였을 때 얼마나 예측이나 분류를 잘 수행하는지 그 성능을 알기 위해서는 이에 대한 추정 방식이 필요해요. 먼저 Whole population(모집단)에서 Y와 f를 구하기 위해 Training Set(모집단에서 나온 데이터셋)에서 f와 똑같지 않지만 비슷한 모델 f^를 만들어요. 그리고 이 모델을 모집단에서 나온 또 다른 데이터 셋인 Test Set을 이용하여 확인해요. 하지만 일반적으로 Test Set이 별도로 존재하는 경우가 많지 않기 때문에 Training Set을 2개의 데이터셋으로 나눠요. 이 Training Set에서 Training Set과 Test Set을 어떻게 나누느냐에 따라 모델의 성능이 달라질 수 있어요. 이런 테스트 방법을 교차 검증(Cross validation)이라고 해요.이번 시간에는 교차 검증 방법으로 LOOCV(Leave-One-Out Cross Validation)와 K-Fold Cross Validation을 알아봤어요. LOOCV(Leave-One-Out Cross Validation)LOOCV는 n 개의 데이터 샘플에서 한 개의 데이터 샘플을 test set으로 하고, 1개를 뺀 나머지 n-1 개를 training set으로 두고 모델을 검증하는 방식이에요.K-Fold Cross ValidationK-Fold CV는 n 개의 데이터를 랜덤하게 섞어 균등하게  k개의 그룹으로 나눠요. 한 개의 그룹이 test set이고 나머지 k-1개의 그룹들이 training set이 되어 k번을 반복하게 돼요. LOOCV도 n-fold CV로 볼 수 있어요!코드로 나타내기Step1. 데이터 생성 & train set과 test set  단순 분리# model selection modulefrom sklearn.model_selection import train_test_splitfrom sklearn.discriminant_analysis import LinearDiscriminantAnalysis# read datadf = pd.read_csv('data/data01_iris.csv')data = df.iloc[:,:-1].as_matrix()target = df['Species'].factorize()[0]LOOCV와 K-Fold CV에 사용할 데이터를 구하는 코드에요. data 파일 안의 data01.csv 파일을 읽어서 데이터 프레임 형태로 가져와요.df(데이터 프레임) 안에는 이와 같은 105개의 데이터 셋이 저장되어 있어요.df(데이터 프레임)의 Sepal.Length부터 Petal.Width의 값들을 매트릭스 형태로 data에 할당해요.Species에는 ‘setosa’, ‘versicolor’, ‘virginica’ 값들이 있는데요. factorize() 을 이용하여 setosa는 0, versicolor는 1, virginica는 2로 바꿔줘요.# random splitX_train, X_test, y_train, y_test = train_test_split(            data, target, test_size=0.4, random_state=0)X_train.shape, y_train.shapeX_test.shape, y_test.shape그다음에는 data와 target 데이터를 가지고 training set과 test set으로 6:4로 나눠요.X_train.shape = (90,4),  X_test.shape = (60, 4)가 돼요.# LDA f = LinearDiscriminantAnalysis() f.fit(X_train,y_train) y_train_hat = f.predict(X_train) table_count(y_train,y_train_hat) f.score(X_train,y_train)LDA(Linear discriminant analysis)는 대표적인 확률론적 생성 모형이에요. 즉 y의 클래스 값에 따른 x의 분포에 대한 정보를 먼저 알아낸 후, 베이즈 정리를 사용하여 주어진 x에 대한 y의 확률 분포를 찾아낸다고 해요.Step2. test set 준비(1) LOOCV으로 test set 준비# leave-one-out  from sklearn.model_selection import LeaveOneOutloo = LeaveOneOut()loo.get_n_splits(X_train)scv = []for train_idx, test_idx in loo.split(X_train):    print('Train: ',train_idx,'Test: ',test_idx)    f.fit(X_train[train_idx,:],y_train[train_idx])    s = f.score(X_train[test_idx,:],y_train[test_idx])    scv.append(s) get_n_splits() 함수를 사용하여 (90,4)의 shape을 가지는 X_train을 90개로 나눠요.test set에 0부터 89까지 하나씩 할당되고 할당된 숫자 외의 나머지 숫자들은 training set으로 모델을 검증해요. 위의 결과에서도 볼 수 있듯이 test set에 0이 할당되면 train set에는 1 ~ 89가 할당되어 모델을 검증하게 돼요!(2) K-fold CV로 test set 준비# K-fold CVfrom sklearn.model_selection import KFoldkf = KFold(5)kf.get_n_splits()scv = []for train_idx, test_idx in kf.split(X_train):    print('Train: ',train_idx,'Test: ',test_idx)    f.fit(X_train[train_idx,:],y_train[train_idx])    s = f.score(X_train[test_idx,:],y_train[test_idx])    scv.append(s) KFold(5) : 위에서 배운 k-fold 교차 검증에서 k를 5로 설정하여 우리가 가지고 있는 데이터 셋을 5개의 그룹으로 나눠서 교차 검증을 할 거예요.kf.get_n_splits()를 사용하여 5번 교차 검증할 것을 정해요.위에서 90개의 데이터셋을 5개의 그룹으로 나눴어요. 그리고 각 그룹 한 개씩 test set으로 정하고 나머지 그룹들은 training set으로 할당하고 모델을 검증해요. 예를 들어 그룹 1이 0~17, 그룹 2가 18 ~ 35, 그룹 3이 36~53, 그룹 4가 54~71, 그룹 5가 72~89라고 할 때, test set에 그룹 1을 할당하면 train set에는 그룹 2, 3, 4, 5가 할당되어 모델을 검증하게 돼요.Step3. 교차 검증 시행CV는 단순히 데이터 셋을 나누는 역할을 수행할 뿐이에요. 실제로 모형의 성능(편향 오차 및 분산)을 구하려면 이렇게 나누어진 데이터셋을 사용하여 평가를 반복해야 해요. 이 과정을 자동화하는 명령이 cross_val_score()이에요.# K-fold CVfrom sklearn.model_selection import cross_val_scoref = LinearDiscriminantAnalysis()s = cross_val_score(f,X_train,y_train,cv=3)cross_val_score(f, X_train, y_train, cv=3) : cross validation iterator cv를 이용하여 X_train, y_train을 분할하고 f에 넣어서 scoring metric을 구하는 과정을 반복해요.2. Regularization앞서 말한 우리의 목적은 우리의 데이터셋에 맞는 Y와 f를 구하는 것이었어요. f를 결정하기 위해서는 먼저 결정해야 하는 요소가 있어요. 아래 다섯 가지가 f를 결정하는 요소들이에요.- Model family : linear, neural 등 방법론 결정- Tuning parameter : 모델에 맞는 파라미터 조절 - Feature selection(특징 선택) : 많은 데이터 중 어떤 데이터를 쓸지 고르는 것 - Regularization(정규화)  - Dimension reduction(차원 축소)f를 결정하는 요소 중 Regularization(정규화)에 대해 알아볼게요!정규화 선형회귀 방법은 선형회귀 계수(weight)에 대한 제약 조건을 추가함으로써 모형이 과도하게 최적화되는 현상(과최적화, overfitting)을 막는 방법이에요. 모형이 과도하게 최적화되면 모형 계수의 크기도 과도하게 증가하는 경향이 나타나요. 따라서 정규화 방법에서 추가하는 제약 조건은 일반적으로 계수의 크기를 제한하는 방법이에요. 일반적으로 Ridge Regression, Lasso, Elastic Net 이 세 가지 방법이 사용돼요.Ridge Regression머신 러닝에서는 모델의 오차를 찾기 위해 보통 최소제곱법(Least squares fitting)을 이용하여 β를 최소화시켜요. 위의 RSS는 잔차제곱식으로 예측값과 실제 값 사이의 차이를 구하는 식이에요. 회귀분석의 계수 값을 RSS을 최소화하는 β값을 찾음으로써 구할 수 있어요.Ridge Regression은 최소제곱법에 가중치들의 제곱합을 최소화하는 것을 추가적인 제약 조건으로 갖는 방법이에요. λ는 기존의 제곱합과 추가적 제약 조건의 비중을 조절하기 위한 하이퍼 파라미터에요. λ가 크면 정규화 정도가 커지고 가중치의 값들이 작아져요. λ가 작아지면 정규화 정도가 작아지며 λ가 0이 되면 일반적인 선형 회귀 모형이 돼요.코드로는 아래와 같이 나타낼 수 있어요.from sklearn.linear_model import Ridgef = Ridge(alpha=0.5)f.fit(xtrain,ytrain)f.intercept_,f.coef_f.score(xtrain,ytrain)f.score(xtest,ytest)LassoLasso는 가중치의 절댓값의 합을 최소화하는 것을 추가적인 제약 조건으로 가져요. 아래와 같이 코드로 나타낼 수 있어요.from sklearn.linear_model import Lassof = Lasso(alpha=1.0)f.fit(xtrain,ytrain)f.intercept_,f.coef_f.score(xtrain,ytrain)f.score(xtest,ytest)Elastic NetElastic Net은 가중치의 절댓값의 합과 제곱합을 동시에 제약 조건으로 가지는 모형이에요. 코드로는 아래와 같아요.from sklearn.linear_model import ElasticNetf = ElasticNet(alpha=0.1,l1_ratio=0.5)f.fit(xtrain,ytrain) f.intercept_,f.coef_f.score(xtrain,ytrain)f.score(xtest,ytest)Lasso와 Ridge Regression의 차이점왼쪽 : Lasso, 오른쪽 Ridge Regression위의 두 그림은 Lasso와 Ridge Regression의  차이점을 잘 나타내는 그림이에요. 초록색 부분은 회귀계수(회귀분석에서 독립변수가 한 단위 변화함에 따라 종속변수에 미치는 영향력 크기)가 가질 수 있는 영역이고 빨간색 원은 RSS가 같은 지점을 연결한 것을 보여주는 것으로 가운데로 갈수록 오차가 작아져요.Lasso와 Ridge Regression 모두 RSS를 희생하여 계수를 축소하는 방법이라는 공통점이 있어요.하지만 Ridge Regression과 Lasso의 가장 큰 차이점은 Ridge 회귀는 계수를 축소하되 0에 가까운 수로 축소하는 반면, Lasso는 계수를 완전히 0으로 축소화한다는 점이에요.Cross validation(교차 검증)과 Regularization(정규화)에 대해 알아보았는데요. 간단히 요약해 볼게요.Cross validation(교차 검증)은 머신러닝 모델의 타당성을 검증하는 방법 중의 하나로, 특정 데이터를 training set과 test set으로 분할한 뒤 training set을 활용해 학습하고 test set으로 테스트하여 학습의 타당성을 검증하는 방법이에요. 교차 검증에는 여러 가지 방법이 있는데 그중에서도 우리는 LOOCV와 K-Fold CV를 배웠어요.Regularization(정규화)는 모델의 일반화 오류를 줄여 과적합을 방지하는 방법을 말해요. 일반적으로 Ridge Regression, Lasso, Elastic Net 이 세 가지 방법을 사용해요.이상적인 머신러닝 모델을 만들기 위해 고려해야 할 점들은 정말 많은 것 같아요. 우리가 만든 모델이 적합한 모델인지 이번 수업시간에 배운 교차 검증과 정규화를 통해 잘 살펴봐요!* 이 글은 AI스쿨 - 인공지능 R&D 실무자 양성과정 4주차 수업에 대하여 수강생 최유진님이 작성하신 수업 후기입니다.
조회수 2134

나는 이쁜 데일리룩을 보고 싶은걸? \w pose estimation

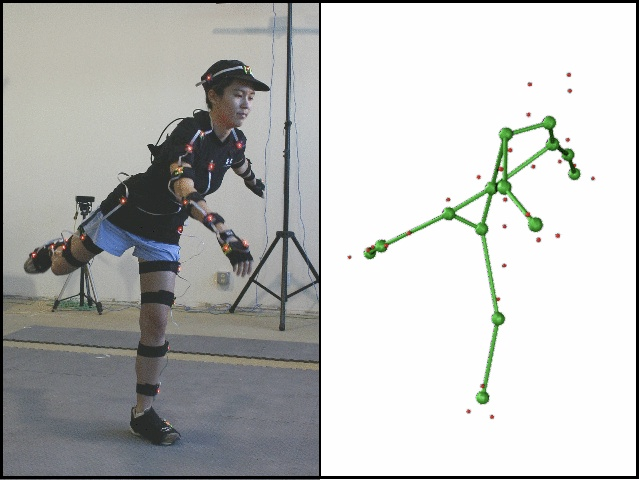
안녕하세요. 스타일쉐어 백엔드 개발자 김동현입니다.2018년의 스타일쉐어에서는 뷰티, 중고 그리고 데일리룩이라는 피드가 추가로 등장했는데요, 그중 제가 작업했던 데일리룩 피드를 만들게 된 배경과 개발 방향에 대해 공유드리고자 합니다.스타일쉐어 데일리룩#데일리룩 #ootd / 타자 치는 것은 귀찮아데일리룩에 관련된 스타일들만 뽑아내는 방법 중에 가장 간단한 방법은 텍스트로 분리해내는 방법이었을 것입니다.하지만 #데일리룩 #ootd는 사진이나 내용이 관계가 없더라도 들어가 있는 경우가 많았습니다.또한 위의 피드처럼 정성스러운 글을 써주는 유저도 많긴 했지만 자신의 데일리 로그를 남기면서 글을 작성하지 않는 경우도 더러 있었습니다.즉, 단순히 텍스트로만 구별해내기에는 이미지에 대한 질을 확신할 수 없었고, 텍스트가 주된 서비스가 아니다 보니 설명 없는 좋은 이미지들이 많았는데요.우리는 이 이미지들을 놓치고 싶지 않았습니다.그래서 결과적으로 텍스트 대신 이미지를 사용하는 방향을 선택하게 되었습니다.이미지로 어떻게 구별해낼까?다행히도 R-CNN의 높은 인식률과 Pre-Trained 된 모델의 label 중 person이 이미 학습되어있던 터라 별도의 Transfer Learning 없이 이미지 내에서 body parts가 있는지 없는지 찾아내는 것은 아주 어렵지 않았습니다.다만 문제가 있다면 body parts에 들어가는 모든 부분을 person이라고 예측하던 부분이었죠.예를 들자면 아래와 같습니다.다음과 같이 제가 사용한 모델에서는 body parts를 person이라는 라벨로 처리하고 있었습니다.단순히 R-CNN의 person 라벨만을 믿기에는 의도했던 데일리룩 외에도 너무나도 많은 것들이 데일리룩이라는 이름으로 필터링될 것 같았습니다.그래서 또 다른 필터가 하나 더 필요하다는 생각이 들었습니다.Pose EstimationBody Parts 중 우리가 원하는 부분이 사진에 있으면 좋겠다!라는 생각을 곰곰이 하다 보니 우연히 머릿속에 스쳐 지나가는 하나의 장면이 있었습니다.Source: http://graphics.berkeley.edu/papers/Kirk-SPE-2005-06/바로 3D 모델링 중에서 Motion Tracker 에 관련된 장면이었는데요. 이것을 Tracker가 아니라 이미지에서 stick figure를 뽑아낼 수 있으면 되지 않을까?라는 생각이 들었습니다.놀라운 딥러닝의 세계에는 이미 여러 명의 Stick Figure를 뽑아낼 수 있는 경지에 도달해 있었습니다.Source: https://github.com/ZheC/Realtime_Multi-Person_Pose_EstimationPose Estimation 딥러닝 모델을 사용하여 아래와 같은 결과물을 얻어낼 수 있었는데요.이미지 내의 Body Parts의 존재 여부를 알게 되었으니 우리가 원하는 Body Parts가 이미지 내에 있는지 검사할 수 있게 되었습니다.하지만 해당 모델이 마냥 가볍지는 않았기에 사용자의 업로드가 많은 순간에는 예측 Task가 밀리기 시작했습니다.그래서 아주 단순하지만, 효과적인 아이디어들을 적용하였는데요.pose estimation을 하기 전에 R-CNN을 돌린 후 person으로 예측된 bounding box가 있다면 pose estimation 모델을 돌리도록 했습니다.하지만 위의 필터를 통했음에도 원하는 결과물이 안 나오는 경우가 종종 있었는데요.바로 다음과 같은 경우입니다.생각보다 작은 사람의 stick figure도 잘 추출 내어서 해수욕장으로 떠나 찍은 사진 속의 저 멀리 있는 휴양객을 데일리룩으로 잡는 일이 종종 발생했거든요.그래서 위의 조건에 더불어서 person이라고 예측된 bounding box size가 전체 이미지 크기 대비 n % 이상의 크기 일 경우 Pose Estimation을 진행하자는 것이었죠.적당한 크기 이상의 데일리룩들을 뽑아내고 싶었고 사람이 너무 작아서 안 보이는 경우도 피할 수 있었습니다.빠른 분류 속도는 덤이었고요.덕분에 유저들이 올린 콘텐츠 중 데일리룩이라는 범주에 속하는 콘텐츠를 잘 뽑아낼 수 있었습니다.아래는 위의 과정을 거쳐서 Pose Estimation까지 처리되어 데일리룩 사진이라고 판별된 이미지입니다.이다음으론 무엇을 더 해볼 수 있을까요?사진 속의 자세를 알 수 있게 되었으니 좀 더 재밌는 것을 할 수 있을 것 같은데요.예를 들면 K-Means를 적용하면 비슷한 모습의 데일리룩들만 모아볼 수도 있고 스타일쉐어 유저들이 자주 찍는 자세 라던가 유저 별 자세 선호도 등등 재밌는 것들을 할 수 있을 것 같습니다.날 따라 해 봐요 같은 것도 해볼 수 있겠네요 :)같이 해보지 않을래요?아직도 재밌는 것들이 많이 남은 스타일쉐어 에서는 더 많은 것을 하기 위해 개발자분들을 모시고 있습니다 :)백엔드 개발자라고 해서 백엔드 개발에만 국한되지 않고 하고 싶은 것들을 해도 된다, 할 수 있다고 이야기해 주는 회사라고 생각합니다.스타일쉐어를 좀 더 알고 싶으시다면 여기를 눌러 주세요 :)#스타일쉐어 #개발팀 #개발자 #백엔드개발 #개발인사이트 #경험공유 #후기
조회수 2006

인공지능은 인류의 축복이 될 것이다

알파고와 이세돌의 대결에서 알파고가 3연승을 거둔 이후에 많은 사람들은 충격에 빠졌다. 인공 지능의 발전으로 인해 없어질 직업들을 걱정하는 사람들부터 더 나아가서는 인류의 종말을 경고하는 사람들도 나오고 있다. 이러한 예상이나 걱정이 완전히 근거가 없는 것은 아니지만 지나친 걱정과 두려움이라는 생각이다. 산업 혁명시대에 기계가 일자리를 빼았는것을 두려워한 사람들이 러다이트 운동을 일으켜 기계를 파괴했던 일이 있었다. 하지만 지금 누구도 방직 기계가 사람의 일자리를 빼앗아 가는걸 두려워하지 않는다. 인공지능은 어차피 인간을 위해 인간이 만들어내는 도구에 불과한것이고 인간을 능가할 수는 없다. 계산기가 인간보다 계산을 잘한다고 해서 계산기가 인간보다 우월하다고 하지 않는다.찬란한 문화 예술의 시대로 불렸던 고대 그리스 시대의 이면에는 잉여 생산을 가능케 한 노예 노동이 있었다. 고대 그리스의 시민들은 고된 노예 노동이 만들어낸 잉여 생산물 기반위에 철학과 과학을 논하고 문화와 예술을 즐겼다. 현대 시대에는 노예 노동은 사라졌다. 하지만 인공지능과 로봇기술의 발전은 극단적인 표현으로 말하자면 새로운 노예 노동의 시대를 만들어 낼 수 있다. 인공지능의 발전으로 인해 인류는 루틴하고 반복적인 일들을 맡길 누군가를 만들어 낼 수 있다. 그리고 인류는 좀더 창조적인 일 즉 인공지능이 할 수 없는 일에 좀더 시간을 쏟을 수 있다. 이것이 인류 문명을 더 찬란하게 만들어 줄 것이라 믿는다.  인공지능이 아름다운 음계를 작곡하고 연주한다 하더라도 그 음악 뒤에 숨어있는 철학과 열정을 만들어 낼 수는 없다. 우리가 조성진의 연주에 감동받는 것은 단순히 그 음악이 아니라 음악을 연주하는 열정을 느끼고 열정에 연결되어 있는 스토리에 감동받는 것이다. 인공지능과 로봇이 외과수술을 대신할 수 있지만, 환자들의 아픔에 공감하고 위로하고 희망을 줄 수 있는 것은 사람 의사만이 할 수 있는 영역이다. 그리고 기존 과학 법칙에 의문을 품고 새로운 법칙을 만들어내거나 기존 법과 제도에 반기를 들고 새로운 질서를 만들어 내는것 또한 인간만이 가질 수 있는 능력이다. 우리가 생각하는 것 이상으로 인간의 창의력과 능력은 인공지능이 가질 수 있는 능력을 넘어선다. 인간보다 빨리 달릴 수 있는 자동차를 만들어냈다고 인간이 자동차를 두려워하지는 않는다. 인공지능도 인간의 능력을 보조하는 역할을 충실히 할 도구에 불과하다.인공지능은 분명 인류의 새로운 진보를 만들어 낼 축복이지만 우리가 이러한 새로운 혁명을 맞을 준비가 되어 있는가에 대해서는 다시한번 생각해 볼 필요가 있다. 난 인공지능이 만들어낼 새로운 시대에 우리가 준비해야할 몇 가지를 말하고 싶다.첫번째, 교육을 근본적으로 바꾸어야 한다. 지금 우리나라의 교육은 산업화 시대에 맞는 인재를 만들어내는 교육이다. 무비판적인 지식의 습득을 강조하는 교육 시스템이다. 우리나라의 교육 시스템하에서 학생들은 정해진 시간에 누가 빨리 암기하고 누가 빨리 문제를 풀어낼 수 있도록 훈련하고 배우고 있다. 무비판적으로 지식을 습득하고 암기한다. 사람이 아무리 빨리 수학계산을 할 수 있도록 훈련한다고 해도 컴퓨터를 이길 수 없고, 사람이 아무리 암기를 잘한다 해도 컴퓨터의 저장능력을 이길 수 없다. 지금 우리 아이들에게 필요한 것은 인공지능이 할 수 없는 영역의 일을 가르쳐야 한다. 기존의 지식에 의문을 품고 질문을 만들어 내고 사람과 사람의 감정을 공감하고 감동을 만들어 낼 수 있는 인재로 교육시켜야 한다. 언제든지 인터넷으로 찾을 수 있는 '수학 공식'과 '역사 연대표'를 외우고 있는 학생들을 보면 안타까운 생각밖에 들지 않는다. 정확한 답을 찾는 교육이 아닌 올바른 질문을 찾아내는 교육이 되어야한다. 질문과 호기심은 인간만의 재능이고 이것이 인류 문명을 발전시켜왔다.두번째, 인공지능이 만들어 낼 잉여 생산을 소수의 사람들이 독점해서는 안된다. 산업화 시대에 태동한 자본주위는 소수의 부의 독점과 그로인한 수요의 실종으로 인해 발생한 대공황때 붕괴 위기를 맞는다. 그리고 경제학자들은 기존의 자본주의를 수정한 수정 자본주의 개념을 도입하고 국가의 개입을 정당화 시켰다. 서양의 사회 복지 제도는 단순히 인본주의 혹은 동정주의로 인한 것이 아니라 사회 시스템을 건강하게 유지시키고 지속 가능한 경제 성장을 만들어내기 위한 방법인 것이다. 그것은 빈부격차가 심한 멕시코와 남미가 치솟는 범죄율과 사회의 불안정으로 인해 경제 성장이 위협받는 것과 안정적인 복지제도로 인해 사회 안정을 바탕으로 지속적인 경제 성장을 만들어내는 북유럽을 비교하면 쉽게 이해 할 수 있을 것이다. 인공지능과 로봇은 잉여 생산을 만들어 낼 것이다. 그리고 그것을 소수가 독점하지 못하도록 사회 시스템을 만들지 못한다면 인공지능과 로봇이 만들어낸 잉여 생산을 사줄 소비자들은 구매력을 상실하고 사회 경제 시스템이 붕괴 위기에 놓일 가능성이 높다. 난 최근 북유럽에서 도입되고 있는 '기본 소득'이 이러한 노력의 일환이라고 생각한다.우리는 새로운 도전의 시대에 살고 있다. 인공지능은 분명 인류의 축복이 될 것이다. 하지만 인공지능은 도구에 불과하다. 그 도구를 제대로 쓰지 못한다면 그 축복은 분명 저주가 될 가능성도 있다. 도구나 기술은 무색무취이다. 결국 도구나 기술을 쓰는 사람들이 그 도구와 기술의 색깔을 만들어 낸다.#NEOFECT #인사이트 #인공지능 #기술혁신 #4차산업혁명
조회수 2523

Dropwizard와 Asynchronous HBase 적용기

Background워크인사이트 서비스는 루비 온 레일즈 기반으로 작성된 웹 애플리케이션입니다. 주로 사용하는 데이터의 대부분은 HBase에 저장되어 있습니다. HBase는 자바로 작성된 API를 기본으로 제공하므로, 레일즈가 직접 HBase의 데이터에 접근할 수 없습니다. 따라서 데이터를 효과적으로 읽어들이기 위해서는 두 가지 방법 중 하나를 선택해야 합니다. 첫 번째는 HBase Java API를 이용하기 위해 웹 애플리케이션 역시 자바 기반의 프레임워크로 재작성하는 것이고, 두 번째는 HBase 스토리지 측 데이터 형식과 레일즈 웹서비스 측 데이터 형식을 서로 연결해주는 RPC 중개자를 도입하는 것입니다. 첫 번째 방법은 프로그래밍 언어를 통일함으로써 데이터 통신의 일관성은 물론 시스템 안정성이나 성능 측면에서 좀 더 낫다는 장점이 있는 반면에, 현재까지 작성한 레일즈 애플리케이션을 전부 자바 기반의 프레임워크로 재작성해야한다는 단점이 있습니다. 두 번째 방법은 보다 범용성을 지향하는 방식으로 향후 시스템의 확장에 좀 더 유용하지만, 첫 번째 방법보다 시스템 전체 성능은 뒤떨어진다는 단점을 갖고 있습니다.당시에는 이미 워크인사이트의 개발이 상당히 진척된 상태였기 때문에, 레일즈 프레임워크를 그대로 유지하면서 자바와 소통할 수 있는 JRuby를 사용하는 것이 최선인 것 같았습니다. 하지만 실험 결과 JRuby는 실 사용할 수 없을 정도의 성능을 냈습니다. 무엇보다도 레일즈 지원이 아직 미성숙한 상태였고, 사용중인 루비 젬 중에도 네이티브 C 구현 루비만 지원하는 젬이 상당 수 있었으며, 이러한 이유들로 인해 결국 JRuby는 대안에서 제외되었습니다. 루비 온 레일즈를 버리고 다른 자바 기반 프레임워크로 전면 재작성하기에는 너무 큰 소모비용과 위험요소가 있었기에 다른 방식을 고려하게 됩니다.그래서 조이는, 앞서 말한 크게 두 가지의 대안 중 두 번째, 범용 데이터 중개자를 도입하기로 결정하고, Thrift를 선택하기로 결정하였습니다. Thrift는 페이스북에서 처음 개발하였고, 현재는 아파치 재단에서 관리하고 있는 범용 RPC 프레임워크입니다. 비슷한 기능을 가진 다른 프레임워크로는 구글의 Protocol Buffer나 아파치 Avro등이 있습니다만, Thrift를 선택한 이유는 지원하는 프로그래밍 언어의 종류가 가장 다양하다는 것이었고, 워낙 많은 사용 사례가 있어 신뢰성이 검증되었다는 판단을 했기 때문입니다. Thrift는 그 규모에 걸맞게 다양한 플랫폼별 배포판을 지원하고 있으며, 조이는 현재 사용중인 하둡 시스템 관리용 Cloudera manager를 지원하는 배포판을 이용하여 디플로이하였습니다. 레일즈와의 연동도 thrift젬을 이용하여 손쉽게 할 수 있었습니다. 테스팅 결과도 문제 없었고, 이것으로 모든 것이 잘 돌아가는 줄 알았습니다.그림1. Thrift를 적용한 ZOYI Back-end SystemProblem워크인사이트는 런칭 이후 지금까지 가파른 성장세를 이어오고 있습니다. 서비스 초기에 느긋한 속도로 성장하던 적용 매장 증가 추세는, 2015년 현재 기하급수적으로 증가하는 상승곡선을 그리고 있으며, 그에 따른 시스템의 스케일 업 & 아웃 이슈도 매 달 새롭게 발생하고 있습니다.그림2. 오픈 이후 워크인사이트가 구동 중인 실제 매장 수문제없이 잘 굴러갈 것만 같았던 Thrift서비스 역시 조이의 성장세에 따라 점차 부하가 걸리기 시작했는데, 당초에 기대했던 범용 RPC 프레임워크가 보장하는 확장성과 동시성과는 조금 다른 성격의 문제가 발생하게 되었습니다. 시스템에 대규모 질의가 집중되는 시점에 병목 현상이 발생하고, 이것이 CPU와 메모리의 한도를 초과하면 그대로 다운되는 현상이었습니다. 특히 메모리 사용량이 복구되지 못하고 계속 쌓여만 가는 누수 현상이 치명적이었습니다. 게다가 이렇게 다운된 Thrift가 재시작된 경우, 레일즈와의 연결을 복구하지 못하는 현상도 비주기적으로 발생하였습니다.조이의 하둡 클러스터는 본래부터 확장성을 고려하여 설계되었기 때문에, Thrift에서 발생한 이러한 문제는 생소한 것이었습니다. 다각도에서 테스트를 해 봤지만, 처음에는 원인을 파악하기가 쉽지 않았습니다. 리부트된 클러스터도 자가 복구가 되지 않아, 개발팀이 직접 클라우데라 매니저를 주시하고 있다가 Thrift 서버의 다운 시점에 수동으로 재시작을 해 줘야 하기도 했습니다. 데이터 변환 프로토콜의 문제인지 검토해 보았으나, Thrift 프로토콜이 갖는 본질적 결함은 더더욱 아니었습니다. 자바 언어가 갖고 있는 내재적 결함도 아니었습니다. HBase가 제공하는 자바 API의 문제도 아니었습니다.하지만 심도 있는 검증 과정을 통해, Thrift의 가비지 컬렉션이 제대로 작동하지 않는 문제를 발견하였고, 이는 단순히 Thrift의 최적화의 문제가 아니라는 결론에 이르렀습니다.Dropwizard그렇게 고심하던 개발팀은, 2014년의 워크인사이트 첫 런칭 시점으로 되돌아가서 생각해보기로 합니다. 당시의 조이가 먼저 생각했던 방식은 JVM 기반의 프레임워크였는데, 자바를 이용하여 서비스 레벨도 구현하면 Thrift에서의 데이터 변환 과정에서 야기되는 문제를 원천적으로 방지할 수 있음에 다시금 주목하게 되었습니다. 많은 프로그래밍 언어간의 데이터 통신을 위해 설계된 Thrift는 사실 레일즈와 자바로 균일하게 구축된 조이 시스템에는 필요 이상으로 무겁고 큰 프레임워크였습니다. 조이가 겪은 이런 Thrift의 문제를, 해외의 여러 기업들도 경험하였고 각기 다른 방법으로 최적화를 진행한 것도 알게 되었습니다. 이렇게 된 이상 바꿀 수 밖에 없었던 것입니다.그래서 다음 대안을 찾기 위해 많은 리서치와 스터디를 진행했습니다. 넘쳐나는 프레임워크들의 홍수 속에서 가볍고 안정적이며 구현이 편리한 프레임워크를 찾기란 쉽지 않았습니다만, 결국 Dropwizard라는 자바 프레임워크를 도입하기로 결정하게 됩니다. Dropwizard는 이미 잘 알려져 있는 Spring이나 Play 등과 같은 풀 스택 자바 프레임워크와는 다른, 경량 REST API 프레임워크입니다. Dropwizard는 모듈화가 잘 되어 있고, 숙성된 자바 생태계의 안정적인 라이브러리(Jetty, Jersey, Jackson)들을 사용하였으며, 모던 자바에 걸맞는 방식(리플렉션, 동시성 등)을 사용하기 쉽게 패키징되어있습니다. 국내에는 잘 알려지지 않았지만, 해외에서는 이미 Airbnb 등 유수의 스타트업들이 실제 서비스에 사용함으로써 그 유용성을 입증하고 있는 프레임워크입니다.그림3. Dropwizard로 새로 구성된 ZOYI Back-end System다만, 처음 사용하는 프레임워크에 조이의 모든 서비스를 포팅하는 것은 불가능에 가까웠고, 설령 하더라도 엄청난 리스크를 감당할 가치가 있는 지 의문이었습니다. 레일즈가 보장해주는 빠른 기능 구현과 쉬운 배포 및 강력한 ORM 등은 루비 온 레일즈가 주는 최대의 강점이기에, 이를 포기하기는 쉽지 않았습니다. 생산성과 성능, 어느 한 쪽도 놓치고 싶지 않았습니다.그래서 조이는 두 마리 토끼를 다 잡아 보기로 결정합니다. 레일즈의 장점을 유지하면서, Dropwizard의 최대 장점인 HBase 데이터 접근의 유연성도 살릴 수 있는 방법을 찾기로 하였고, 결론적으로 Dropwizard는 기존의 Thrift가 담당하던 데이터 중개자의 역할만을 수행하게 되었습니다. Dropwizard의 잘 나뉘어진 모듈화는 이를 가능하게 해 주었습니다. 모든 모듈을 사용하면 풀 스택 프레임워크에 버금가는 규모의 시스템도 구축할 수 있지만, 필요한 것만 선택하여 사용하면 가볍고 빠르게 작동하는 미들웨어 역할도 가능한 것입니다.Asynchronous HBase, and Java 8Dropwizard가 HBase 연결에 사용한 클라이언트 모듈은 AsyncHBase입니다. Asynchronous HBase는, 타임스탬프 기반 데이터베이스인 OpenTSDB를 만든 팀이 자신들의 제품에 HBase를 연동하기 위해 기존의 HBase 클라이언트인 HTable을 대체하는 모듈을 재작성한 것으로, 완전한 비동기 방식과 넌블록킹 및 스레드 안전성 보장이 강점이라 할 수 있습니다. AsyncHBase와 Dropwizard를 연동하는 것은 매우 수월했습니다. 테스트 결과, 간결한 코드로도 초당 수 만 단위의 동시성을 안정적으로 처리할 수 있음을 검증했습니다. 조이는 OpenTSDB를 실시간 데이터 분석에 사용하고 있어, 해당 팀이 제공하는 제품의 품질과 전망에 대해 신뢰를 갖고 있었습니다. 테스트 결과는 이 신뢰를 더욱 뒷받침해주었고, 본 모듈을 Dropwizard의 HBase 연결 모듈로 선정하게 되었습니다.또한, Dropwizard와 AsyncHBase의 도입과 함께 처음으로 자바 버전 8로의 이식도 진행하게 되었습니다. 자바 8은 람다와 스트림 등 함수형 프로그래밍의 여러 기법을 대거 도입하였고, 자바 특유의 장황한 문법을 조금 더 간결하게 축약할 수 있는 장점이 있습니다. Dropwizard와 AsyncHBase 모두 자바 8과 순조롭게 연동되었으며, 이 결과에 만족한 조이는 기존의 하둡 맵 리듀스 프로젝트 역시 자바 8로 버전업하기로 결정하였습니다.PerformanceDropwizard의 성능 테스트 결과는 만족스러웠습니다. AsyncBase도 기대를 저버리지 않는 결과를 보여 주었습니다. HBase Java API와의 매끄러운 연동은, 성능 측면에서 기존과는 비교할 수 없을 정도의 향상을 보여주었고, 이 덕분에 기존 맵 리듀스 워크플로우 중 일부를 실시간 처리로 옮겨, 좀 더 유연하고 동적인 분석이 가능하게 되었습니다.다음의 비교는 Thrift와 Dropwizard의 각각의 벤치마크 테스트를 100개 동시 작업, 단위당 10000개의 요청으로 수행한 경우의 결과를 나타낸 것입니다.그림4. Thrift 테스트 시의 메모리 사용량Concurrency Level: 100 Time taken for tests: 514.315 seconds Complete requests: 10000 Failed requests: 0 Total transferred: 32090000 bytes HTML transferred: 27600000 bytes Requests per second: 19.44 [#/sec] (mean) Time per request: 5143.151 [ms] (mean) Time per request: 51.432 [ms] (mean, across all concurrent requests) Transfer rate: 60.93 [Kbytes/sec] received Thrift 벤치마크 결과. 전체 수행에 514초가 걸렸습니다.그림5. Dropwizard 테스트 시의 메모리 사용량Concurrency Level: 100 Time taken for tests: 4.599 seconds Complete requests: 10000 Failed requests: 121 (Connect: 0, Receive: 0, Length: 121, Exceptions: 0) Non-2xx responses: 121 Total transferred: 23288000 bytes HTML transferred: 21559452 bytes Requests per second: 2174.25 [#/sec] (mean) Time per request: 45.993 [ms] (mean) Time per request: 0.460 [ms] (mean, across all concurrent requests) Transfer rate: 4944.72 [Kbytes/sec] received Dropwizard 벤치마크 결과. 전체 수행에 4초가 걸렸습니다!그림6. 초당 처리량 (높을수록 좋음)벤치마크 테스팅 시 스레드 분산이 최적화 된 경우에는 최대 100배 이상의 속도 향상이 있었습니다. Dropwizard는 기존 Thrift에 비하여 성능 향상은 물론, 안정성 면에서도 시스템이 다운된 이후에 자동 복구되지 않는 현상도 사라졌습니다. 무엇보다도 짧은 코드만으로 대규모의 질의에도 견고하고 신속하게 반응하는 서비스를 구현할 수 있다는 점이 Dropwizard의 가장 큰 장점입니다.Conclusion유용한 오픈소스 프로젝트는 시장에 너무나도 많이 널려 있습니다. 이 중에 어떤 것을 선택하는가는 소프트웨어 기업에게 중요한 안건이며, 잘못된 결정은 프로젝트 자체는 물론 회사의 생사를 결정하기까지 합니다. 조이는 적합성, 성능, 안정성, 생산성 등 모든 면에서 조이의 서비스와 알맞는 제품을 찾으려고 항상 노력하고 있으며, 가능한 한 넓고 깊은 검증, 분석 및 연구를 통해 최적의 대안을 찾아내고 있습니다. 그 결과, 이번 Dropwizard와 Asynchronous HBase를 도입하여 기존의 Thrift를 대체하는 프로젝트는 예상보다 훨씬 좋은 성과를 낼 수 있었습니다. 국내에는 Dropwizard의 실무 사용기 등을 찾아보기 힘들고, 한글화된 문서 자체도 찾기 쉽지 않은데, 이 글이 앞으로의 선택을 고민하는 분들, 드롭위자드에 관심이 있는 분들께 도움이 될 수 있으면 좋겠습니다.#조이코퍼레이션 #개발팀 #개발자 #개발환경 #업무환경 #인사이트 #경험공유

기업문화 엿볼 때, 더팀스

로그인

/